ai-agents-for-beginners
Exploration du Microsoft Agent Framework
Introduction
Cette leçon couvrira :
- Comprendre Microsoft Agent Framework : Fonctionnalités clés et valeur
- Explorer les concepts clés de Microsoft Agent Framework
- Modèles avancés de MAF : flux de travail, middleware et mémoire
Objectifs d’apprentissage
Après avoir terminé cette leçon, vous saurez comment :
- Construire des agents IA prêts pour la production en utilisant Microsoft Agent Framework
- Appliquer les fonctionnalités principales de Microsoft Agent Framework à vos cas d’utilisation agentiques
- Utiliser des modèles avancés incluant les workflows, middleware et observabilité
Exemples de code
Des exemples de code pour Microsoft Agent Framework (MAF) se trouvent dans ce dépôt sous les fichiers xx-python-agent-framework et xx-dotnet-agent-framework.
Comprendre Microsoft Agent Framework
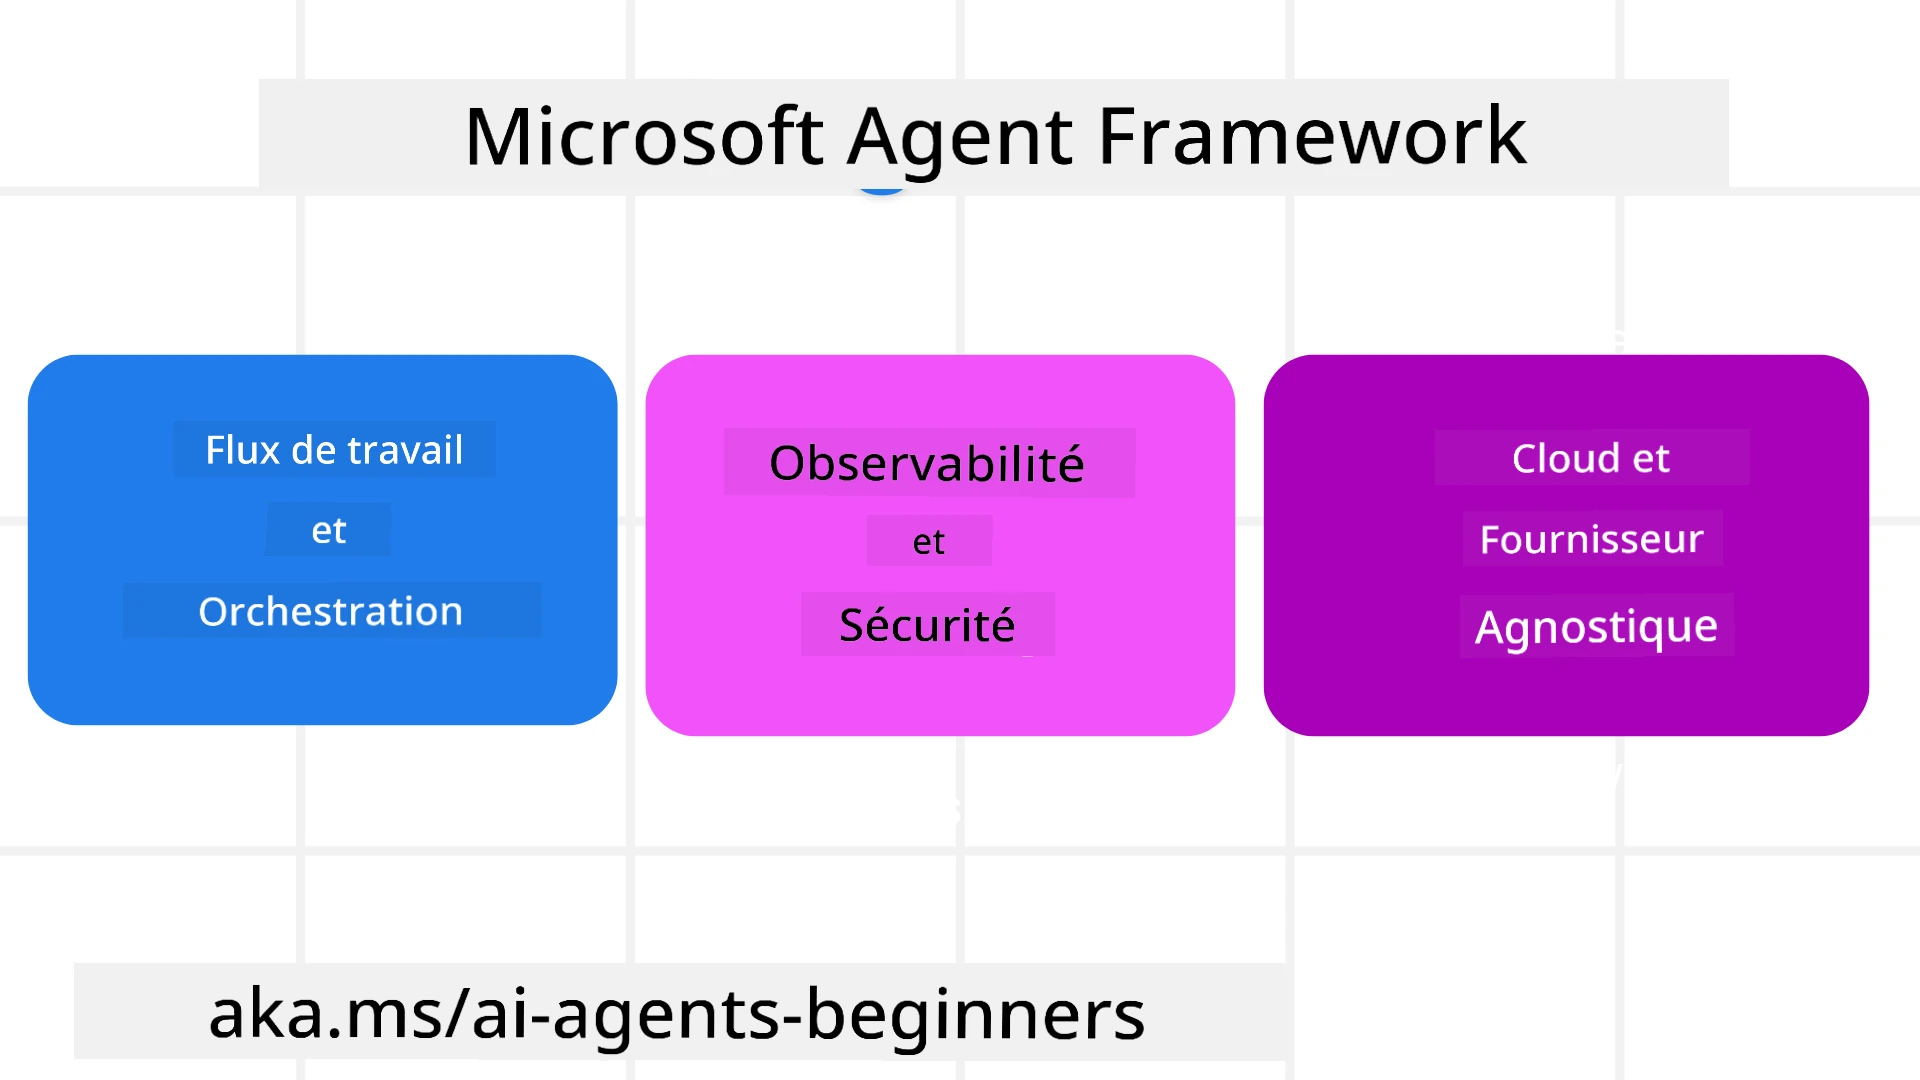
Microsoft Agent Framework (MAF) est le framework unifié de Microsoft pour construire des agents IA. Il offre la flexibilité nécessaire pour répondre à la grande variété de cas d’usage agentiques observés tant en production qu’en recherche, notamment :
- Orchestration séquentielle d’agents dans les scénarios où des flux de travail pas à pas sont requis.
- Orchestration concurrente dans les scénarios où les agents doivent accomplir des tâches en même temps.
- Orchestration de chat de groupe dans les scénarios où des agents peuvent collaborer ensemble sur une tâche.
- Orchestration de transfert dans les scénarios où les agents se transmettent la tâche au fur et à mesure que les sous-tâches sont complétées.
- Orchestration magnétique dans les scénarios où un agent gestionnaire crée et modifie une liste de tâches et coordonne les sous-agents pour accomplir la tâche.
Pour livrer des agents IA en production, MAF inclut également des fonctionnalités pour :
- Observabilité via l’utilisation d’OpenTelemetry où chaque action de l’agent IA est tracée, y compris l’invocation d’outils, les étapes d’orchestration, les flux de raisonnement et la surveillance des performances via les tableaux de bord Microsoft Foundry.
- Sécurité en hébergeant les agents nativement sur Microsoft Foundry, qui inclut des contrôles de sécurité tels que l’accès basé sur les rôles, la gestion des données privées et la sécurité intégrée du contenu.
- Durabilité puisque les threads et workflows de l’agent peuvent être mis en pause, repris et récupérer d’erreurs, ce qui permet des processus plus longs.
- Contrôle avec le support des workflows « human in the loop » où certaines tâches requièrent une approbation humaine.
Microsoft Agent Framework met aussi l’accent sur l’interopérabilité par :
- Être indépendant du cloud - Les agents peuvent fonctionner dans des conteneurs, sur site et sur plusieurs clouds différents.
- Être indépendant du fournisseur - Les agents peuvent être créés via le SDK de votre choix dont Azure OpenAI et OpenAI.
- Intégrer des standards ouverts - Les agents peuvent utiliser des protocoles comme Agent-to-Agent (A2A) et Model Context Protocol (MCP) pour découvrir et utiliser d’autres agents et outils.
- Plugins et connecteurs - Des connexions peuvent être établies vers des services de données et de mémoire comme Microsoft Fabric, SharePoint, Pinecone et Qdrant.
Voyons comment ces fonctionnalités s’appliquent à certains des concepts clés de Microsoft Agent Framework.
Concepts clés de Microsoft Agent Framework
Agents
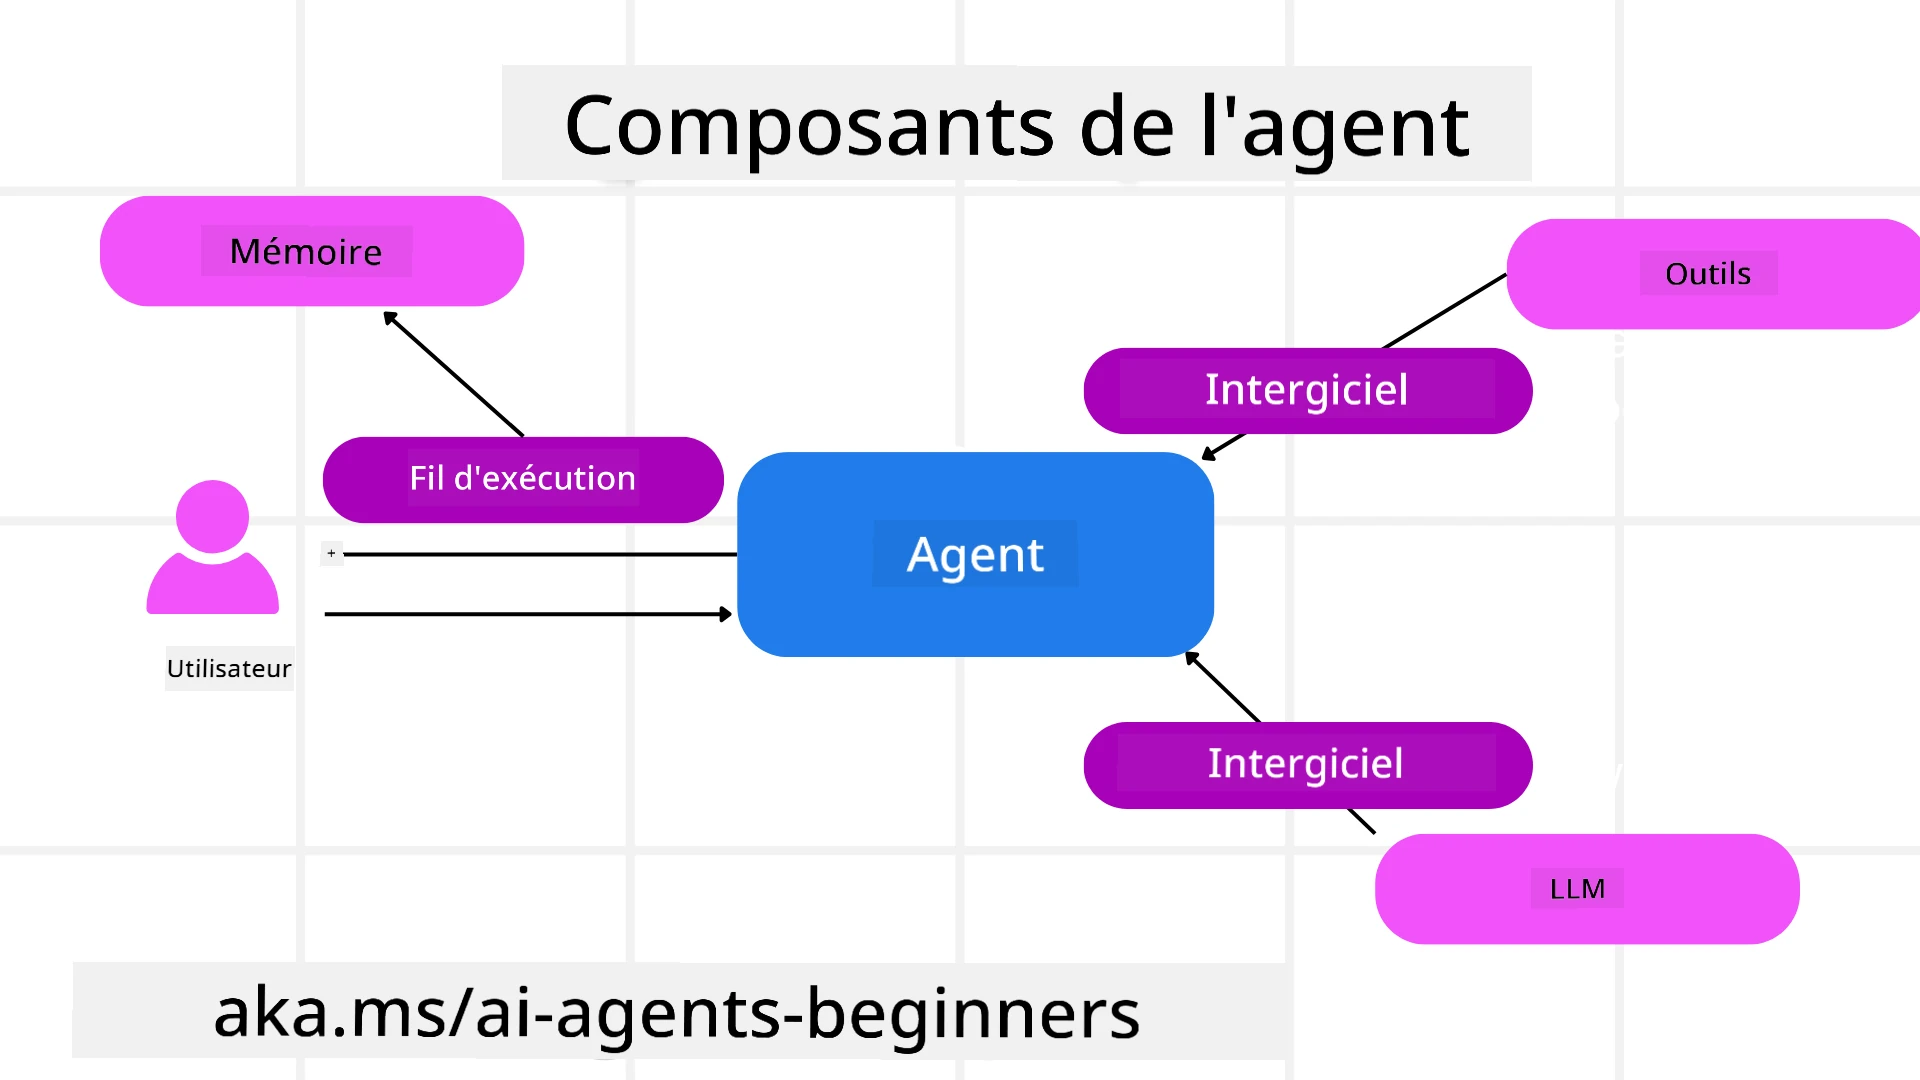
Création d’agents
La création d’agent se fait en définissant le service d’inférence (fournisseur LLM), un
ensemble d’instructions que l’agent IA doit suivre, et un name assigné :
agent = AzureOpenAIChatClient(credential=AzureCliCredential()).create_agent( instructions="You are good at recommending trips to customers based on their preferences.", name="TripRecommender" )
L’exemple ci-dessus utilise Azure OpenAI mais les agents peuvent être créés à partir de divers services incluant Microsoft Foundry Agent Service :
AzureAIAgentClient(async_credential=credential).create_agent( name="HelperAgent", instructions="You are a helpful assistant." ) as agent
API OpenAI Responses, ChatCompletion
agent = OpenAIResponsesClient().create_agent( name="WeatherBot", instructions="You are a helpful weather assistant.", )
agent = OpenAIChatClient().create_agent( name="HelpfulAssistant", instructions="You are a helpful assistant.", )
ou MiniMax, qui propose une API compatible OpenAI avec de grandes fenêtres contextuelles (jusqu’à 204K tokens) :
agent = OpenAIChatClient(base_url="https://api.minimax.io/v1", api_key=os.environ["MINIMAX_API_KEY"], model_id="MiniMax-M3").create_agent( name="HelpfulAssistant", instructions="You are a helpful assistant.", )
ou des agents distants utilisant le protocole A2A :
agent = A2AAgent( name=agent_card.name, description=agent_card.description, agent_card=agent_card, url="https://your-a2a-agent-host" )
Exécution des agents
Les agents sont exécutés avec les méthodes .run ou .run_stream pour des réponses non-streaming ou en streaming.
result = await agent.run("What are good places to visit in Amsterdam?")
print(result.text)
async for update in agent.run_stream("What are the good places to visit in Amsterdam?"):
    if update.text:
        print(update.text, end="", flush=True)
Chaque exécution d’agent peut aussi avoir des options pour personnaliser des paramètres tels que max_tokens utilisés par l’agent, tools que l’agent peut appeler, et même le model lui-même utilisé par l’agent.
Cela est utile dans les cas où des modèles ou outils spécifiques sont requis pour accomplir la tâche de l’utilisateur.
Outils
Des outils peuvent être définis aussi bien lors de la définition de l’agent :
def get_attractions( location: Annotated[str, Field(description="The location to get the top tourist attractions for")], ) -> str: """Get the top tourist attractions for a given location.""" return f"The top attractions for {location} are."


# Lors de la création directe d'un ChatAgent

agent = ChatAgent( chat_client=OpenAIChatClient(), instructions="You are a helpful assistant", tools=[get_attractions]
que lors de l’exécution de l’agent :
result1 = await agent.run( "What's the best place to visit in Seattle?", tools=[get_attractions] # Outil fourni uniquement pour cette exécution )
Threads d’agent
Les threads d’agent sont utilisés pour gérer les conversations à multiples tours. Les threads peuvent être créés soit en :
- Utilisant
get_new_thread()qui permet de sauvegarder le thread dans le temps - Créant un thread automatiquement lors de l’exécution d’un agent et ne gardant le thread que durant l’exécution courante.
Pour créer un thread, le code ressemble à ceci :
# Créer un nouveau thread.
thread = agent.get_new_thread() # Exécuter l'agent avec le thread.
response = await agent.run("Hello, I am here to help you book travel. Where would you like to go?", thread=thread)
Vous pouvez ensuite sérialiser le thread pour le stocker pour une utilisation ultérieure :
# Créez un nouveau thread.
thread = agent.get_new_thread()

# Exécutez l'agent avec le thread.

response = await agent.run("Hello, how are you?", thread=thread)

# Sérialisez le thread pour le stockage.

serialized_thread = await thread.serialize()

# Désérialisez l'état du thread après le chargement depuis le stockage.

resumed_thread = await agent.deserialize_thread(serialized_thread)
Middleware d’agent
Les agents interagissent avec des outils et des LLM pour réaliser les tâches de l’utilisateur. Dans certains scénarios, nous voulons exécuter ou suivre des actions entre ces interactions. Le middleware d’agent nous permet cela via :
Middleware de fonction
Ce middleware permet d’exécuter une action entre l’agent et une fonction/outil qu’il va appeler. Un exemple d’utilisation peut être l’enregistrement (logging) de l’appel de fonction.
Dans le code ci-dessous, next définit si le middleware suivant ou la fonction réelle doit être appelée.
async def logging_function_middleware(
    context: FunctionInvocationContext,
    next: Callable[[FunctionInvocationContext], Awaitable[None]],
) -> None:
    """Function middleware that logs function execution."""
    # Pré-traitement : Journaliser avant l'exécution de la fonction
    print(f"[Function] Calling {context.function.name}")

    # Continuer vers le middleware suivant ou l'exécution de la fonction
    await next(context)

    # Post-traitement : Journaliser après l'exécution de la fonction
    print(f"[Function] {context.function.name} completed")
Middleware de chat
Ce middleware permet d’exécuter ou d’enregistrer une action entre l’agent et les requêtes vers le LLM.
Cela inclut des informations importantes comme les messages envoyés au service IA.
async def logging_chat_middleware(
    context: ChatContext,
    next: Callable[[ChatContext], Awaitable[None]],
) -> None:
    """Chat middleware that logs AI interactions."""
    # Pré-traitement : Journaliser avant l'appel à l'IA
    print(f"[Chat] Sending {len(context.messages)} messages to AI")

    # Continuer vers le middleware ou service IA suivant
    await next(context)

    # Post-traitement : Journaliser après la réponse de l'IA
    print("[Chat] AI response received")
Mémoire d’agent
Comme abordé dans la leçon Agentic Memory, la mémoire est un élément important pour permettre à l’agent de fonctionner sur différents contextes. MAF propose plusieurs types de mémoires :
Stockage en mémoire
C’est la mémoire stockée dans les threads pendant l’exécution de l’application.
# Créez un nouveau fil.
thread = agent.get_new_thread() # Exécutez l'agent avec le fil.
response = await agent.run("Hello, I am here to help you book travel. Where would you like to go?", thread=thread)
Messages persistants
Cette mémoire est utilisée pour stocker l’historique des conversations entre différentes sessions. Elle est définie avec le chat_message_store_factory :
from agent_framework import ChatMessageStore

# Créer un magasin de messages personnalisé
def create_message_store():
    return ChatMessageStore()

agent = ChatAgent(
    chat_client=OpenAIChatClient(),
    instructions="You are a Travel assistant.",
    chat_message_store_factory=create_message_store
)
Mémoire dynamique
Cette mémoire est ajoutée au contexte avant l’exécution des agents. Ces mémoires peuvent être stockées dans des services externes comme mem0 :
from agent_framework.mem0 import Mem0Provider

# Utilisation de Mem0 pour des capacités mémoire avancées
memory_provider = Mem0Provider(
    api_key="your-mem0-api-key",
    user_id="user_123",
    application_id="my_app"
)

agent = ChatAgent(
    chat_client=OpenAIChatClient(),
    instructions="You are a helpful assistant with memory.",
    context_providers=memory_provider
)
Observabilité d’agent
L’observabilité est importante pour construire des systèmes agentiques fiables et maintenables. MAF s’intègre avec OpenTelemetry pour offrir traçage et métriques pour une meilleure observabilité.
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()
with tracer.start_as_current_span("my_custom_span"):
    # faire quelque chose
    pass
counter = meter.create_counter("my_custom_counter")
counter.add(1, {"key": "value"})
Workflows
MAF propose des workflows, qui sont des étapes prédéfinies pour accomplir une tâche et incluent des agents IA comme composants dans ces étapes.
Les workflows sont composés de différents composants permettant un meilleur contrôle du flux. Ils permettent aussi l’orchestration multi-agent et les points de contrôle pour sauvegarder l’état du flux.
Les composants clés d’un workflow sont :
Exécuteurs
Les exécuteurs reçoivent des messages d’entrée, accomplissent leurs tâches assignées, puis produisent un message en sortie. Cela fait avancer le workflow vers la complétion de la tâche globale. Les exécuteurs peuvent être des agents IA ou une logique personnalisée.
Arêtes
Les arêtes définissent le flux des messages dans un workflow. Elles peuvent être :
Arêtes directes - Connexions simples un-à-un entre exécuteurs :
from agent_framework import WorkflowBuilder

builder = WorkflowBuilder()
builder.add_edge(source_executor, target_executor)
builder.set_start_executor(source_executor)
workflow = builder.build()
Arêtes conditionnelles - Activées lorsqu’une certaine condition est remplie. Par exemple, lorsqu’il n’y a plus de chambres d’hôtel disponibles, un exécuteur peut suggérer d’autres options.
Arêtes switch-case - Redirigent un message vers différents exécuteurs selon des conditions définies. Par ex : si un client voyageur a un accès prioritaire et ses tâches seront traitées via un autre workflow.
Arêtes en étoile sortante - Envoient un message à plusieurs cibles.
Arêtes en étoile entrante - Rassemblent plusieurs messages provenant de différents exécuteurs et les envoient à une cible.
Événements
Pour une meilleure observabilité des workflows, MAF offre des événements intégrés à l’exécution, notamment :
WorkflowStartedEvent- Début d’exécution du workflowWorkflowOutputEvent- Le workflow produit une sortieWorkflowErrorEvent- Le workflow rencontre une erreurExecutorInvokeEvent- L’exécuteur démarre le traitementExecutorCompleteEvent- L’exécuteur termine le traitementRequestInfoEvent- Une requête est émise
Modèles avancés de MAF
Les sections précédentes couvrent les concepts clés de Microsoft Agent Framework. Lorsque vous construisez des agents plus complexes, voici quelques modèles avancés à considérer :
- Composition middleware : Enchaîner plusieurs gestionnaires middleware (journalisation, authentification, limitation de débit) en utilisant middleware fonctionnel et middleware de chat pour un contrôle granulaire du comportement des agents.
- Points de contrôle des workflows : Utiliser les événements de workflow et la sérialisation pour sauvegarder et reprendre les processus d’agent longs.
- Sélection dynamique d’outils : Combiner RAG sur les descriptions d’outils avec l’enregistrement des outils dans MAF pour présenter uniquement les outils pertinents pour chaque requête.
- Transfert multi-agent : Utiliser les arêtes de workflow et le routage conditionnel pour orchestrer les transferts entre agents spécialisés.
Hébergement des agents LangChain / LangGraph sur Microsoft Foundry
Microsoft Agent Framework est interopérable entre frameworks — vous n’êtes pas limité aux agents écrits avec MAF. Si vous avez déjà un agent construit avec LangChain ou LangGraph, vous pouvez le faire tourner comme un agent hébergé dans Microsoft Foundry, ainsi Foundry gère l’exécution, les sessions, la montée en charge, l’identité et les points de terminaison du protocole, tandis que votre logique d’agent reste dans LangGraph.
Cela se fait avec le package langchain_azure_ai.agents.hosting, qui expose un graphe LangGraph compilé sur les mêmes protocoles que ceux utilisés par les agents hébergés Foundry.
1. Installez l’extension d’hébergement :
pip install -U "langchain-azure-ai[hosting]>=1.2.4" azure-identity
L’extension hosting installe les bibliothèques protocole Foundry : azure-ai-agentserver-responses (le point de terminaison /responses compatible OpenAI) et azure-ai-agentserver-invocations (le point de terminaison générique /invocations).
2. Choisissez un protocole d’hébergement :
| Protocole | Classe d’hôte | Point de terminaison | Utilisation |
|---|---|---|---|
| Responses | ResponsesHostServer |
/responses |
Vous voulez un chat compatible OpenAI, streaming, historique des réponses, et gestion des conversations en fils — le défaut recommandé pour agents conversationnels. |
| Invocations | InvocationsHostServer |
/invocations |
Vous avez besoin d’un format JSON personnalisé, d’un point de terminaison style webhook, ou d’un traitement non conversationnel. |
Comme l’API Responses est l’API principale pour le développement d’agents dans Foundry, commencez par ResponsesHostServer pour la plupart des agents.
3. Configurez les variables d’environnement (az login d’abord pour que DefaultAzureCredential puisse s’authentifier) :
export FOUNDRY_PROJECT_ENDPOINT="https://<resource>.services.ai.azure.com/api/projects/<project>"
export FOUNDRY_MODEL_NAME="gpt-5-mini"
Lorsque l’agent s’exécutera plus tard en tant qu’agent hébergé dans Foundry, la plateforme injectera automatiquement FOUNDRY_PROJECT_ENDPOINT.
4. Exposez un agent LangGraph via le protocole Responses :
import os

from azure.ai.projects import AIProjectClient
from azure.identity import DefaultAzureCredential, get_bearer_token_provider
from langchain.agents import create_agent
from langchain_openai import ChatOpenAI
from langchain_azure_ai.agents.hosting import ResponsesHostServer

_AZURE_AI_SCOPE = "https://ai.azure.com/.default"


def build_chat_model() -> ChatOpenAI:
    project_endpoint = os.environ["FOUNDRY_PROJECT_ENDPOINT"].rstrip("/")
    deployment = os.environ.get("FOUNDRY_MODEL_NAME", "gpt-5-mini")
    credential = DefaultAzureCredential()
    project = AIProjectClient(endpoint=project_endpoint, credential=credential)
    openai_client = project.get_openai_client()
    token_provider = get_bearer_token_provider(credential, _AZURE_AI_SCOPE)

    # ChatOpenAI ici cible le point de terminaison compatible OpenAI (Responses) du projet Foundry.
    return ChatOpenAI(
        model=deployment,
        base_url=str(openai_client.base_url),
        api_key=token_provider,
    )


def main() -> None:
    graph = create_agent(build_chat_model(), tools=[])
    port = int(os.environ.get("PORT", "8088"))
    ResponsesHostServer(graph).run(port=port)


if __name__ == "__main__":
    main()
Exécutez-le localement avec python main.py, puis envoyez une requête Responses à http://localhost:8088/responses.
Comportements clés :
- Conversations : Les clients continuent la conversation en passant
previous_response_idou un ID deconversation. Si votre graphe est compilé avec un LangGraph checkpointer, Foundry associe l’état de la conversation au point de contrôle (utilisez un checkpointer durable en production ;MemorySaversuffit pour les tests locaux). - Human-in-the-loop : Si votre graphe utilise
interrupt()LangGraph,ResponsesHostServerexpose l’interruption en attente comme un élémentfunction_call/mcp_approval_requestdans Responses, et les clients reprennent avec unfunction_call_output/mcp_approval_responsecorrespondant. - Déploiement dans Foundry : Utilisez Azure Developer CLI —
azd ext install azure.ai.agents,azd ai agent init -m <manifest>,azd ai agent run(local, nécessite Docker), puisazd provisionetazd deploy. Le déploiement d’agent hébergé nécessite le rôle Foundry Project Manager.
Une version exécutable de cet exemple se trouve dans code-samples/14-langchain-hosted-agent.py. Pour le guide complet (protocole Invocations, schémas de requêtes personnalisés, dépannage), voyez Héberger des agents LangGraph comme agents hébergés Foundry.
Exemples de code
Des exemples de code pour Microsoft Agent Framework se trouvent dans ce dépôt sous les fichiers xx-python-agent-framework et xx-dotnet-agent-framework.
Vous avez plus de questions sur Microsoft Agent Framework ?
Rejoignez le Microsoft Foundry Discord pour rencontrer d’autres apprenants, assister aux heures de bureau et obtenir des réponses à vos questions sur les agents IA.
Leçon précédente
Prochaine leçon
Construire des agents d’usage informatique (CUA)
Avertissement : Ce document a été traduit à l’aide du service de traduction automatique Co-op Translator. Bien que nous nous efforçions d’assurer l’exactitude, veuillez noter que les traductions automatisées peuvent contenir des erreurs ou des inexactitudes. Le document original dans sa langue native doit être considéré comme la source faisant autorité. Pour les informations critiques, il est recommandé de recourir à une traduction professionnelle réalisée par un humain. Nous ne saurions être tenus responsables des malentendus ou erreurs d’interprétation découlant de l’utilisation de cette traduction.