ai-agents-for-beginners
本番環境におけるAIエージェント:可観測性と評価
AIエージェントが実証実験のプロトタイプから実世界のアプリケーションへと進化するにつれて、その動作を理解し、パフォーマンスを監視し、出力を体系的に評価する能力が重要になります。
学習目標
このレッスンを修了すると、以下のことができるようになります・理解できるようになります:
- エージェントの可観測性と評価の基本概念
- エージェントのパフォーマンス、コスト、有効性を向上させる手法
- AIエージェントを体系的に評価するための方法
- AIエージェントを本番環境にデプロイする際のコスト管理方法
- Microsoft Agent Frameworkで構築したエージェントを計測する方法
目標は、あなたの「ブラックボックス」エージェントを透明で管理可能かつ信頼できるシステムに変えるための知識を提供することです。
注意: 安全で信頼できるAIエージェントをデプロイすることが重要です。Building Trustworthy AI Agents のレッスンもチェックしてください。
トレースとスパン
Langfuse や Microsoft Foundry のような可観測性ツールは通常、エージェントの実行をトレースとスパンとして表現します。
- トレース はユーザーのクエリ処理のような、開始から終了までのエージェントのタスク全体を表します。
- スパン はトレース内の個々のステップを表します(言語モデルの呼び出しやデータ取得など)。
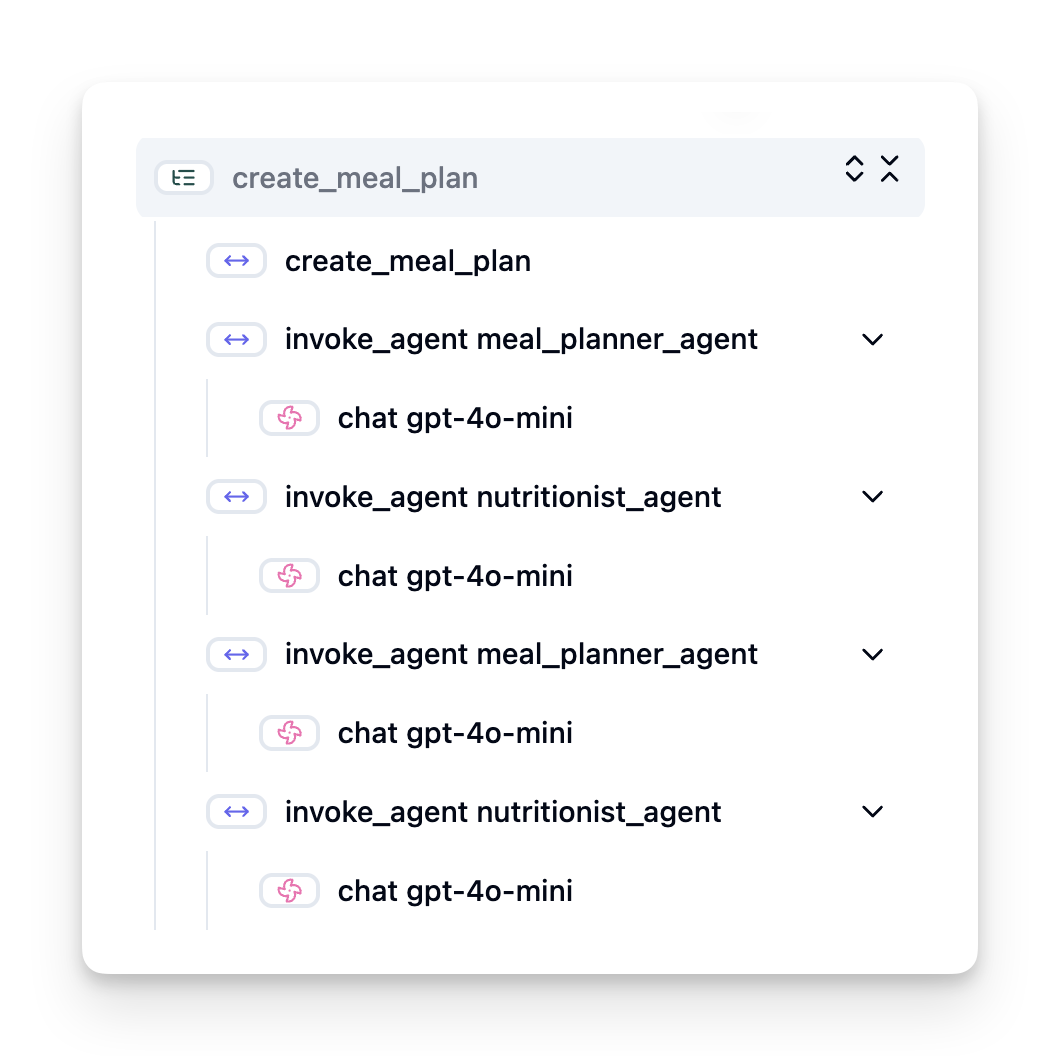
可観測性がなければ、AIエージェントは「ブラックボックス」のように感じられ、その内部状態や推論が不透明で、問題の診断やパフォーマンスの最適化が難しくなります。可観測性を持つことで、エージェントは「ガラス箱」となり、透明性を提供し、信頼を築き、意図した通りに動作することを保証するために不可欠となります。
本番環境で可観測性が重要な理由
AIエージェントを本番環境に移行すると、新たな課題や要件が発生します。可観測性は「あると良いもの」ではなく、重要な機能になります:
- デバッグと根本原因分析:エージェントが失敗したり予期せぬ結果を出した場合、可観測性ツールはエラーの原因を特定するためのトレースを提供します。これは複雑なエージェントで複数のLLM呼び出しやツールの連携、条件ロジックが含まれる場合に特に重要です。
- レイテンシーとコスト管理:AIエージェントはトークン単位や呼び出し単位で課金されるLLMや外部APIに依存することが多いです。可観測性により、これらの呼び出しを正確に追跡でき、過剰に遅いまたは高コストな操作を特定できます。これによりチームはプロンプトの最適化やより効率的なモデル選択、ワークフローの再設計を行い、運用コストを管理し良好なユーザー体験を保証できます。
- 信頼性、安全性、コンプライアンス:多くのアプリケーションでエージェントが安全かつ倫理的に動作することを保証することが重要です。可観測性はエージェントの行動や判断の監査証跡を提供します。これによりプロンプトインジェクション、有害コンテンツの生成、個人識別情報(PII)の不適切な扱いの検出と緩和が可能になります。例えばトレースを確認して、なぜエージェントが特定の応答を出したかや特定のツールを使ったかを理解できます。
- 継続的改善ループ:可観測性データは反復的な開発プロセスの基盤です。エージェントの実際の動作を監視することで改善点を特定し、モデルの微調整のためのデータを収集し、変更の効果を検証できます。これにより、オンライン評価からの本番環境の知見がオフラインの実験や改良に反映され、エージェントの性能を段階的に向上させます。
追跡すべき主要な指標
エージェントの動作を監視し理解するためには、多様な指標やシグナルを追跡する必要があります。具体的な指標はエージェントの用途により異なりますが、普遍的に重要なものもあります。
可観測性ツールが監視する最も一般的な指標の一部を以下に示します:
レイテンシー: エージェントの応答速度はどのくらいか?長い待ち時間はユーザー体験を損ないます。トレースを用いてタスクや個々のステップのレイテンシーを計測すべきです。例えば、すべてのモデル呼び出しで20秒かかるエージェントは、より高速なモデルの使用やモデル呼び出しの並列実行で加速できます。
コスト: エージェント実行あたりの費用は?AIエージェントはトークン単価のLLM呼び出しや外部APIに依存しています。頻繁なツール使用や複数のプロンプトによりコストが急増することがあります。たとえば、品質向上のためにエージェントがLLMを5回呼び出す場合、そのコストが妥当か、呼び出し回数を削減できないか廉価なモデルが使えないかを評価すべきです。リアルタイム監視では予期しない急増(例:バグによるAPIループの過剰呼び出し)を検出できます。
リクエストエラー: エージェントが失敗したリクエスト数は?APIエラーやツール呼び出しの失敗を含みます。本番環境でより堅牢にするためにフォールバックやリトライ機構を設定できます。例えばLLMプロバイダーAが停止した場合、代替のLLMプロバイダーBに切り替えるなどです。
ユーザーフィードバック: 直接的なユーザー評価を実装すると有益なインサイトが得られます。👍賛成/👎反対、⭐1~5つ星、テキストコメントなどがあります。継続的な否定的フィードバックはエージェントが期待通りに動いていない兆候です。
間接的ユーザーフィードバック: ユーザーの行動は明示的評価なしでも間接的にフィードバックを提供します。質問の言い換えや繰り返しのクエリ、再試行ボタンのクリックなどが例です。例えばユーザーが同じ質問を繰り返す場合、それはエージェントの機能不全を示します。
正確性: エージェントが正しいまたは望ましい出力をどのくらいの頻度で出すか?正確性の定義は(問題解決の正確さ、情報検索の精度、ユーザー満足度など)様々です。まずは成功基準を定義し、自動チェック、評価スコア、タスク完了ラベルで追跡します。例えばトレースを「成功」または「失敗」にマークする方法があります。
自動評価指標: 自動評価の設定も可能です。例えばLLMを使ってエージェントの出力が有用か正確か判定することができます。また、エージェントの各側面を評価するオープンソースライブラリもあります。例:RAGエージェント用の RAGAS、有害言語やプロンプトインジェクション検出用の LLM Guard など。
実際には、これらの指標を組み合わせることでAIエージェントの健全性を最も包括的に把握できます。本章の例題ノートブックで実際の例をご紹介しますが、まず典型的な評価ワークフローを学びましょう。
エージェントの計測を行う
トレースデータを収集するには、コードを計測可能にする必要があります。エージェントコードを計測し、可観測性プラットフォームでキャプチャ・処理・可視化可能なトレースや指標を出力することが目標です。
OpenTelemetry (OTel): OpenTelemetryはLLMの可観測性における業界標準として台頭しています。API、SDK、ツールのセットで、テレメトリーデータの生成、収集、エクスポートを提供します。
既存のエージェントフレームワークをラップし、OpenTelemetryスパンを可観測性ツールに簡単にエクスポートできる計測ライブラリは多数あります。Microsoft Agent FrameworkはOpenTelemetryとネイティブ統合されています。以下はMAFエージェントの計測例です:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
本章の例題ノートブックであなたのMAFエージェントを計測する方法を実演します。
手動スパン作成: 計測ライブラリは基盤として有用ですが、より詳細な情報やカスタム情報が必要な場合があります。手動でスパンを作成してカスタムアプリケーションロジックを追加できます。さらに自動または手動で作成したスパンに対し、カスタム属性(タグやメタデータとも呼ばれる)を追加して情報を強化できます。これらの属性にはビジネス固有のデータ、中間計算結果、デバッグや分析に役立つコンテキスト(例えば user_id、session_id、model_version)などが含まれます。
Langfuse Python SDKを使った手動でのトレース・スパン作成例:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
エージェントの評価
可観測性は指標を提供しますが、評価とはそのデータを分析し(テストを実施し)、AIエージェントがどの程度うまく機能しているか、どう改善すべきかを判断するプロセスです。言い換えれば、そのトレースや指標を使ってエージェントを評価し、意思決定する方法です。
定期的な評価は重要です。なぜならAIエージェントはしばしば非決定論的であり(アップデートやモデルの挙動変化により)進化するため、評価なしでは「賢いエージェント」が本当に役立っているか、劣化しているかがわからないからです。
AIエージェントの評価には2つのカテゴリがあります:オンライン評価とオフライン評価。両方とも価値があり、相互に補完します。通常はオフライン評価から始めます。これはエージェントをデプロイする前に最低限必要なステップです。
オフライン評価
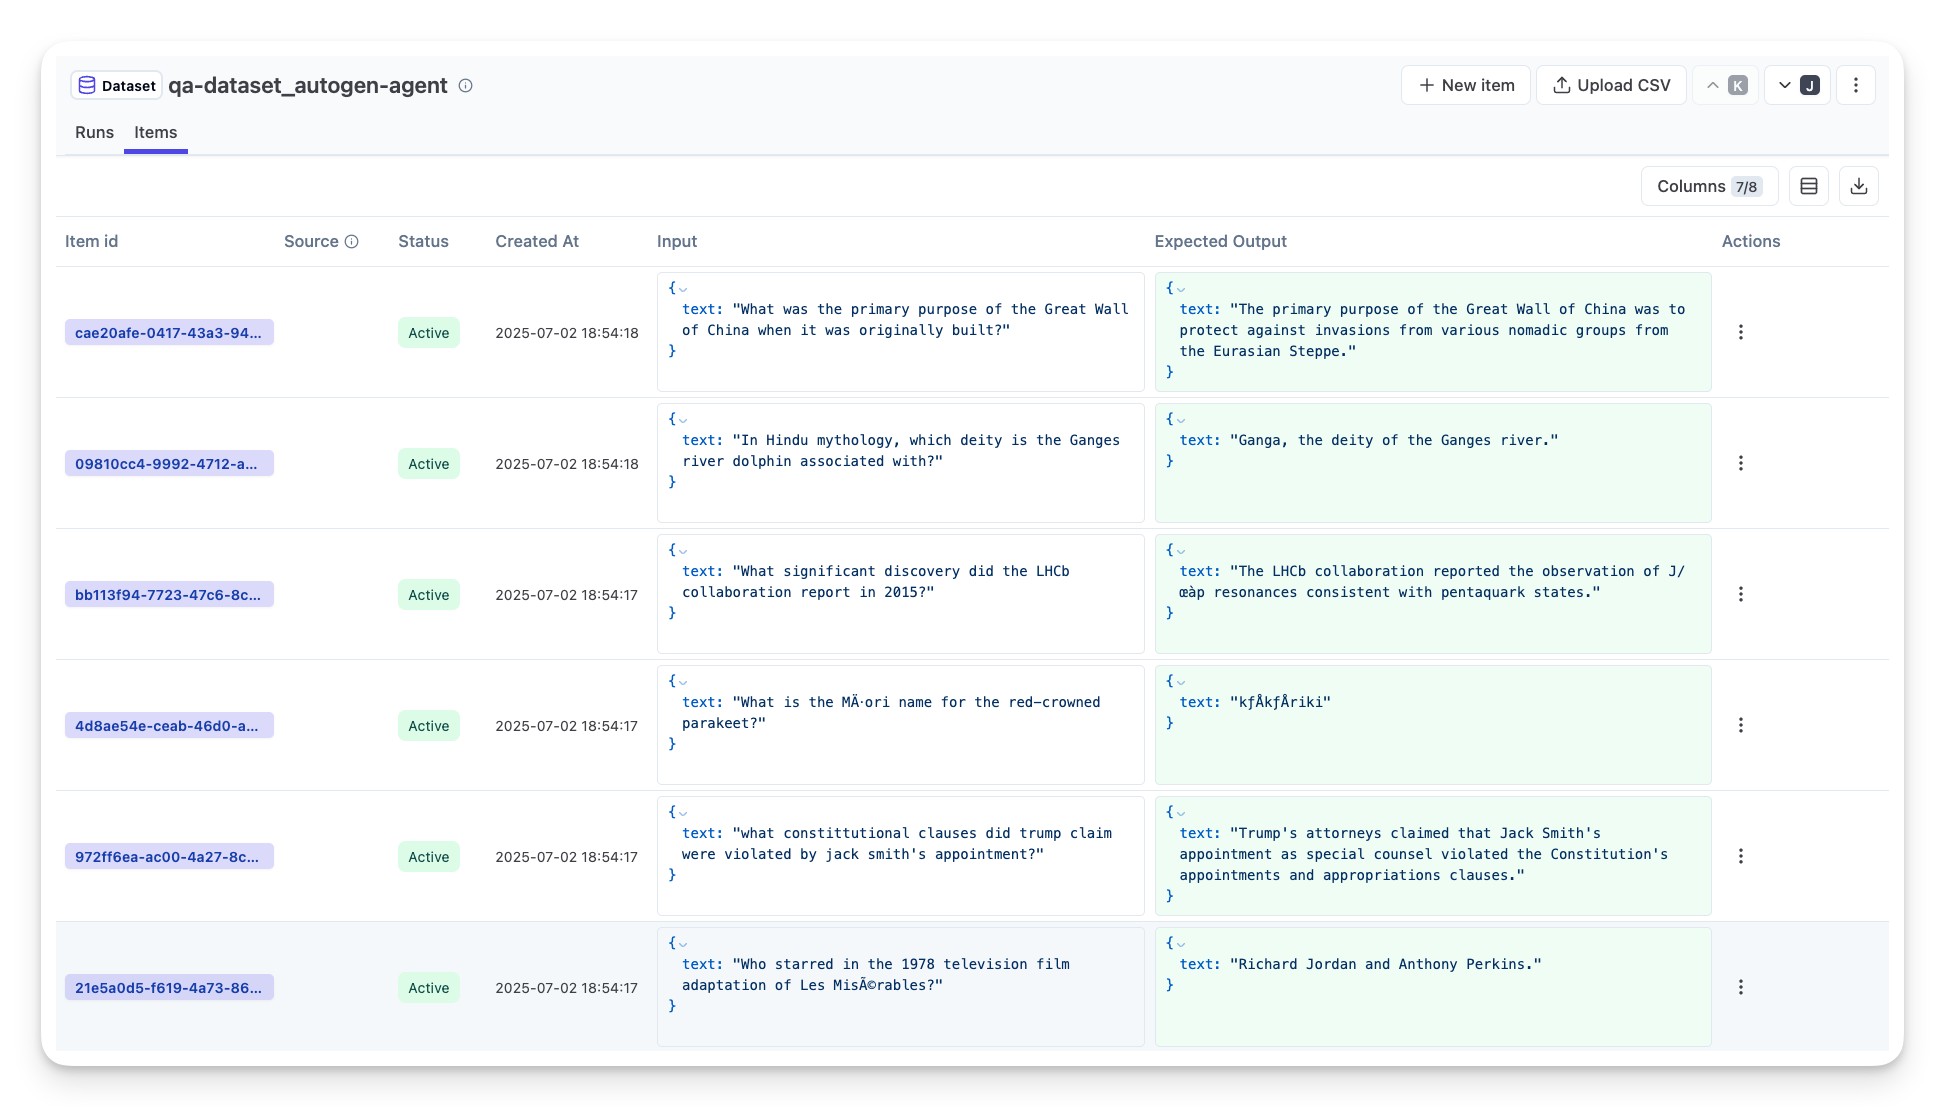
これは制御された環境でエージェントを評価することを指し、通常はテストデータセットを使い、ライブユーザーのクエリでは実施しません。期待される出力や正しい動作がわかっている厳選されたデータセットを用います。
例えば、数学の文章題を解くエージェントを作成した場合、100問の既知の解答があるテストデータセットを用意します。オフライン評価は開発中に行い(CI/CDパイプラインの一部になることもあります)、改善や後退をチェックします。その利点は繰り返し可能かつ基準解があるため明確な正確性指標が得られることです。ユーザーのクエリをシミュレートして理想的な回答と比較したり、前述の自動指標を使うこともあります。
オフライン評価の主な課題は、テストデータセットを包括的にし関連性を保つことです。固定のテストセットでは良い成績を出せても本番環境では全く異なるクエリに遭遇するかもしれません。そのため、最新のエッジケースや実際のシナリオを反映した新しい例を継続的に追加してテストセットを更新すべきです。小さな「スモークテスト」と大規模な評価セットを混在させるのが有用です:小さいセットで素早くチェックし、大きなセットで広範囲の性能指標を取得します。
オンライン評価
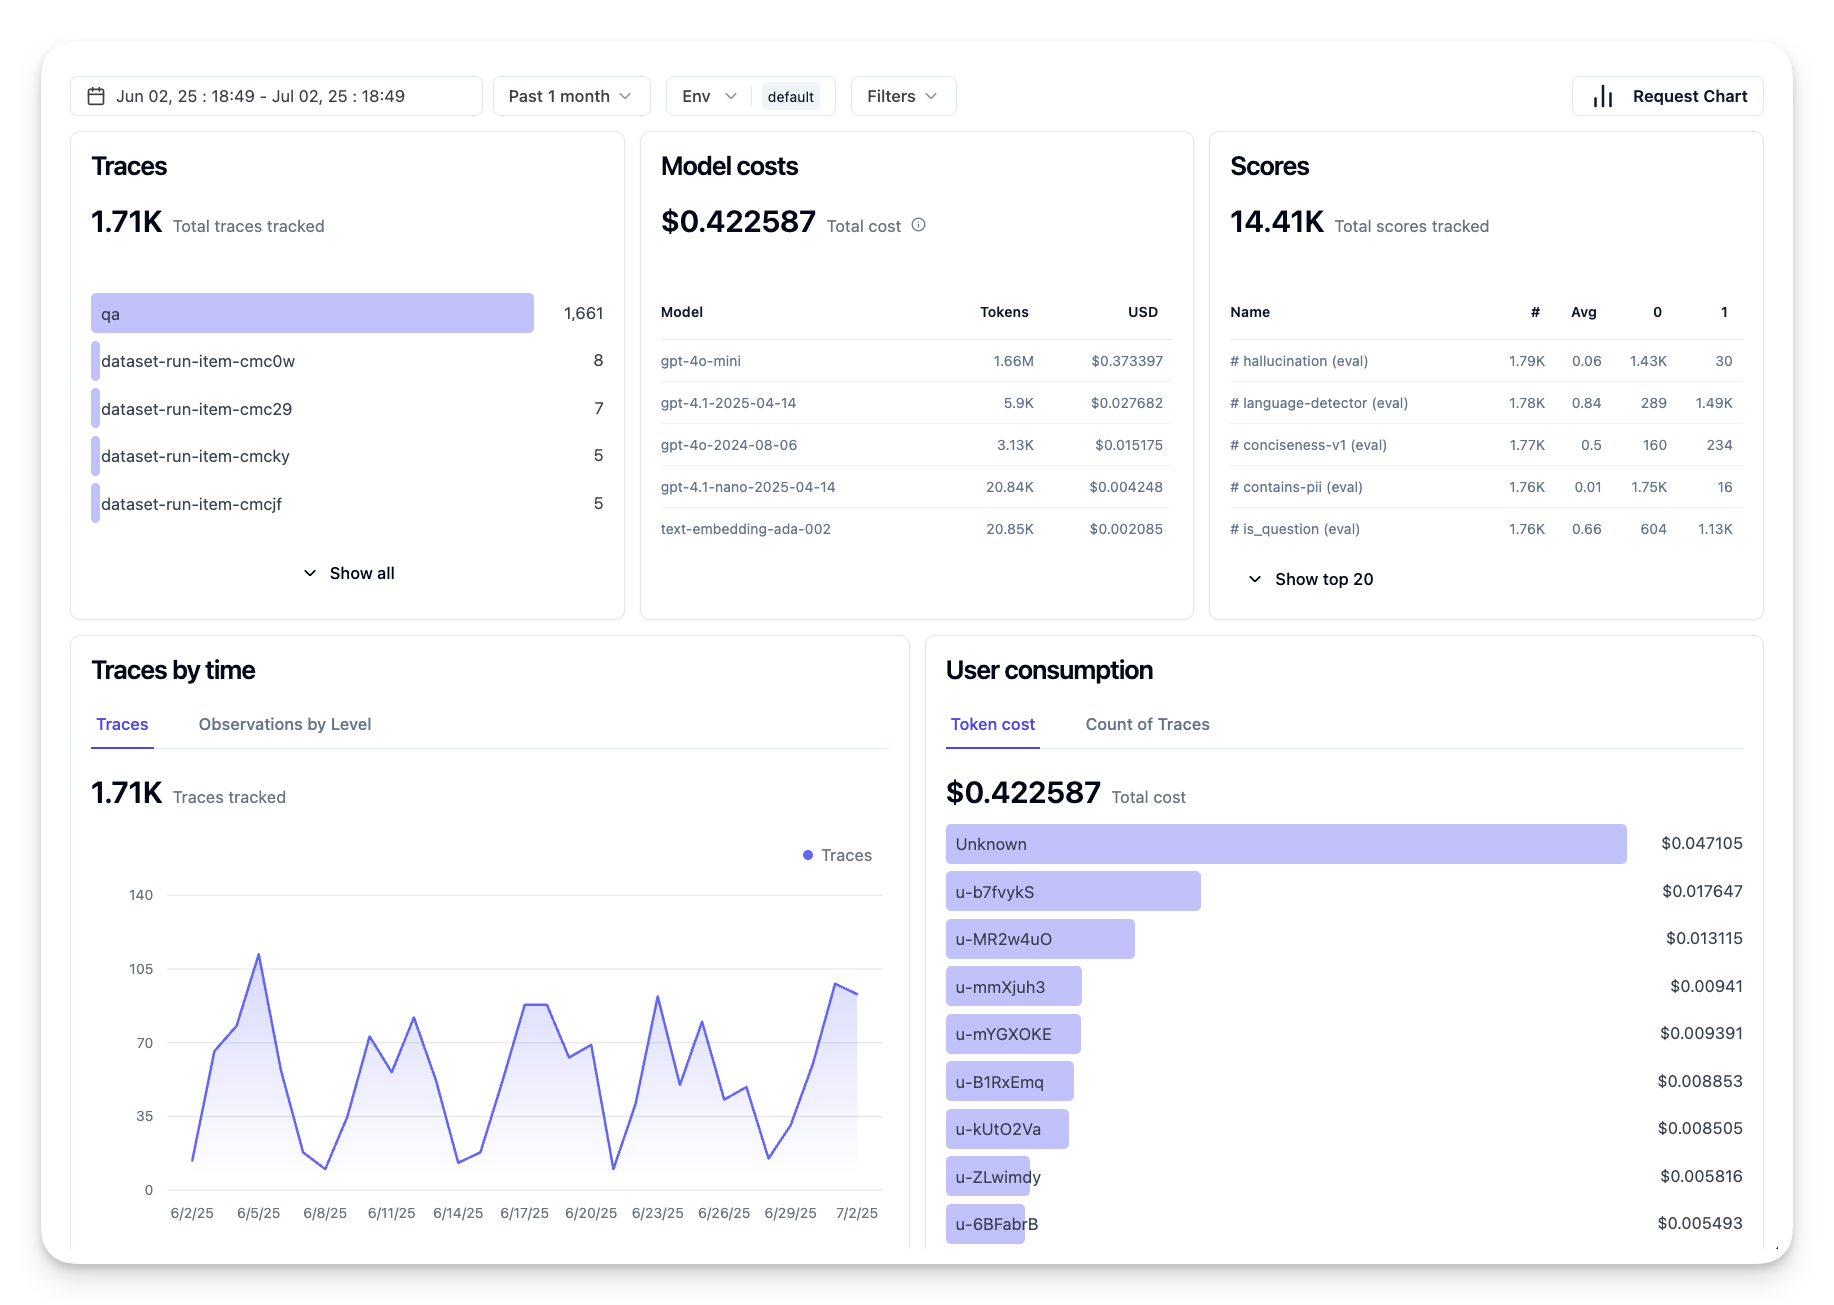
これは本番環境の実際の使用中にエージェントを評価することを指し、リアルタイムのユーザーインタラクションにおけるエージェントのパフォーマンスを継続的に監視し成果を分析します。
例えば、本番トラフィックで成功率やユーザー満足度スコア、その他の指標を追跡します。オンライン評価の利点は、ラボ環境では予測できなかった事象を捉えられることです。モデルのドリフト(入力パターンの変化による効果の低下)やテストデータにない想定外のクエリ・状況を検知でき、本番でのエージェントの真の挙動を把握できます。
オンライン評価では間接的・直接的なユーザーフィードバックを収集したり、シャドウテストやA/Bテスト(新旧エージェントを並行実行して比較する)を実施することもあります。課題はライブインタラクションにおける信頼できるラベルやスコアを取得することです。ユーザーフィードバックや下流の指標(ユーザーが結果をクリックしたかなど)に依存する場合があります。
二つの評価の組み合わせ
オンライン評価とオフライン評価は相反せず、非常に補完的です。オンライン監視で得られた洞察(例えばエージェントの成績が悪い新たなユーザークエリの種類)はオフラインのテストデータセット改善に利用できます。逆に、オフラインテストで良好な成績を示したエージェントは、より自信を持ってオンラインにデプロイ・監視できます。
多くのチームは以下のループを採用しています:
オフラインで評価 -> デプロイ -> オンラインでモニター -> 新たな失敗事例収集 -> オフラインデータセットに追加 -> エージェント改良 -> 繰り返し。
よくある問題
AIエージェントを本番環境にデプロイする際に遭遇する一般的な課題とその解決策を紹介します:
| 問題 | 可能な解決策 |
|---|---|
| AIエージェントがタスクを一貫して実行しない | - エージェントに与えるプロンプトを明確にし、目的を明示する。 - タスクをサブタスクに分割し複数のエージェントで処理する方法を検討する。 |
| AIエージェントが連続ループに陥る | - エージェントがプロセスの終了条件を明確に認識できるように設定する。 - 複雑な推論や計画が必要な場合は、推論タスクに特化した大きなモデルを使用する。 |
| AIエージェントのツール呼び出しの性能不十分 | - エージェントシステムの外でツールの出力をテスト・検証する。 - パラメータ、プロンプト、ツール名を再検討・改善する。 |
| マルチエージェントシステムの一貫性欠如 | - 各エージェントに与えるプロンプトを具体的かつ他と区別できるものにする。 - 「ルーティング」あるいはコントローラーエージェントを使った階層システムを構築し、適切なエージェントを選択する。 |
これらの問題の多くは可観測性を導入することでより効果的に特定できます。前述のトレースや指標によりエージェントワークフローのどこで問題が発生しているか正確に特定でき、デバッグや最適化が大幅に効率化します。
コスト管理
AIエージェントを本番環境にデプロイする際のコスト管理のための戦略をいくつか紹介します:
小さいモデルの活用: Small Language Models (SLMs) は特定のエージェンティックなユースケースで良好なパフォーマンスを発揮し、コストを大幅に削減できます。前述の通り、評価システムを構築して大きいモデルと比較することで、SLMがユースケースにどれだけ適しているかを理解するのが最適です。インテント分類やパラメータ抽出などの簡単なタスクにはSLMを使い、複雑な推論には大きいモデルを使うことを検討してください。
ルーターモデルの使用: 類似の戦略として、さまざまなモデルとサイズを使い分ける方法があります。LLM/SLMやサーバーレス関数を用いて、複雑さに応じて最適なモデルにリクエストをルーティングできます。これによりコストを削減しつつ、適切なタスクでのパフォーマンスも確保できます。例えば、単純なクエリは小さくて高速なモデルにルーティングし、複雑な推論には高価な大きいモデルを使うなどです。
レスポンスのキャッシュ: よくあるリクエストやタスクを特定し、エージェンティックシステムを通す前に応答を提供することは、類似リクエストの量を減らす良い方法です。基本的なAIモデルを使ってリクエストがキャッシュ済みリクエストとどれだけ似ているかを識別するフローを実装することも可能です。この戦略により、よくある質問や一般的なワークフローのコストを大幅に削減できます。
実際の動作を見てみましょう
このセクションの例ノートブックでは、オブザーバビリティツールを使ってエージェントを監視・評価する例を紹介します。
本番環境のAIエージェントについてもっと質問はありますか?
Microsoft Foundry Discordに参加して、他の学習者と交流したり、オフィスアワーに参加したり、AIエージェントの質問に答えてもらいましょう。
前のレッスン
次のレッスン
免責事項: 本書類は AI 翻訳サービス Co-op Translator を使用して翻訳されています。正確性を期していますが、自動翻訳には誤りや不正確な部分が含まれる可能性があることをご承知おきください。原文の原語版が正式な情報源とみなされるべきです。重要な情報については、専門の人間による翻訳を推奨します。本翻訳の利用により生じたいかなる誤解や解釈違いについても、当方は責任を負いかねます。