ai-agents-for-beginners
AI agentai gamyboje: stebimas ir vertinimas
Kai AI agentai pereina nuo eksperimentinių prototipų prie realaus pasaulio taikymų, tampa svarbu suprasti jų elgesį, stebėti našumą ir sistemingai vertinti jų išvestis.
Mokymosi tikslai
Baigę šią pamoką, žinosite kaip / suprasite:
- Pagrindines agentų stebimumo ir vertinimo sąvokas
- Technikas, skirtas gerinti agentų našumą, kaštus ir efektyvumą
- Kaip sistemingai vertinti savo AI agentus ir ką vertinti
- Kaip valdyti kaštus diegiant AI agentus gamyboje
- Kaip įrengti instrumentus agentams, sukurtiems naudojant Microsoft Agent Framework
Tikslas – suteikti žinių, kurios padės paversti jūsų „juodosios dėžės“ agentus skaidriais, valdomais ir patikimais sistemomis.
Pastaba: Svarbu diegti saugius ir patikimus AI agentus. Taip pat peržiūrėkite pamoką Patikimų AI agentų kūrimas.
Sekos ir intervalai
Stebėjimo įrankiai, tokie kaip Langfuse arba Microsoft Foundry, dažniausiai vaizduoja agentų vykdymus kaip sekas ir intervalus.
- Seka reiškia visą agento užduotį nuo pradžios iki pabaigos (pvz., naudotojo užklausos apdorojimas).
- Intervalai yra atskiros šios sekos dalys (pvz., kvietimas kalbos modeliui arba duomenų paieška).
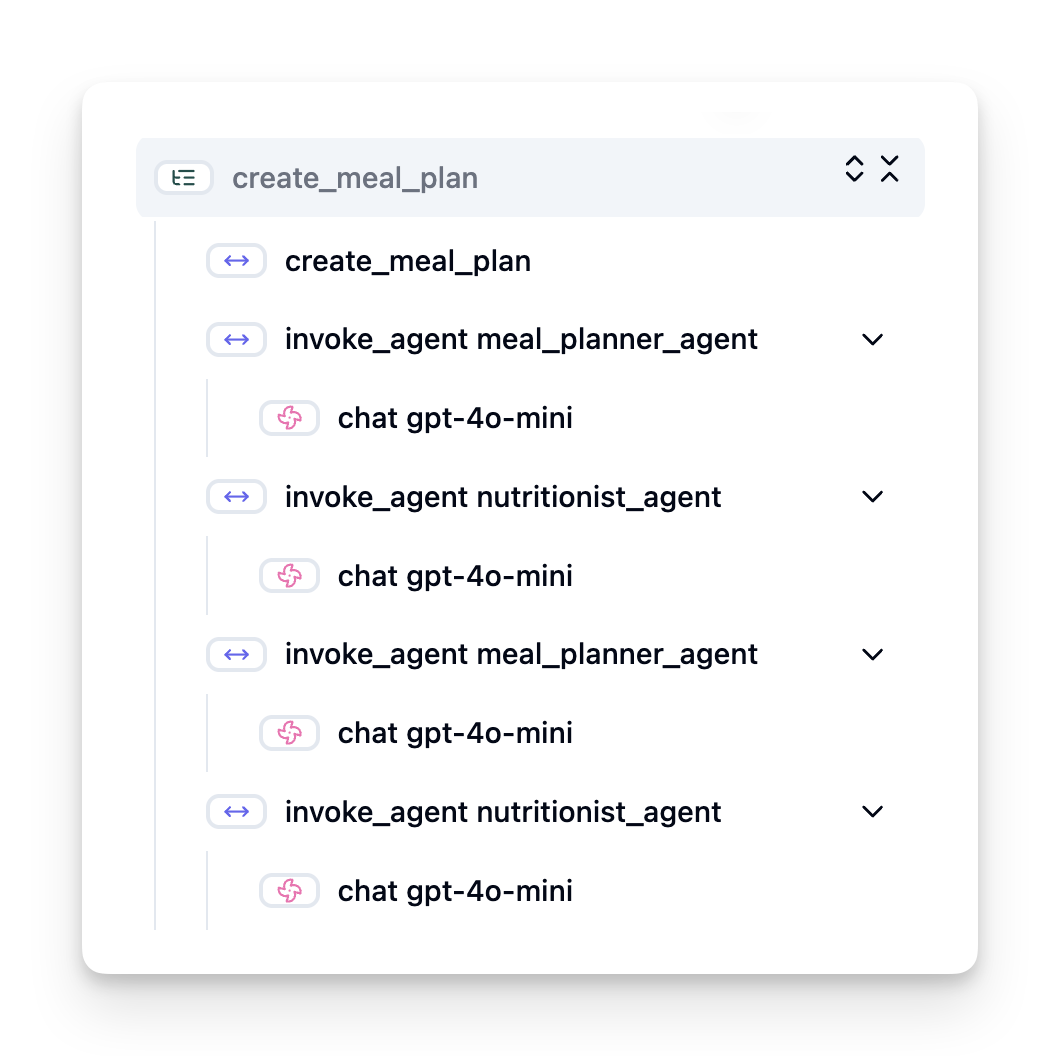
Be stebimumo AI agentas gali atrodyti kaip „juodoji dėžė“ – jo vidinė būklė ir pagrindimas yra neaiškūs, todėl sunku diagnozuoti problemas ar optimizuoti našumą. Su stebimumu agentai tampa „stiklinėmis dėžėmis“, siūlančiomis skaidrumą, kuris yra būtinas pasitikėjimui kurti ir užtikrinti, kad jie veikia kaip numatyta.
Kodėl stebimumas svarbus gamybos aplinkoje
Perkėlimas su AI agentais į gamybos aplinką sukelia naujų iššūkių ir reikalavimų. Stebimumas nebe yra „pageidautinas“, o kritinė galimybė:
- Derinimas ir pagrindinės priežasties analizė: Kai agentas sugenda arba sukuria netikėtą išvestį, stebėjimo įrankiai pateikia sekas, reikalingas klaidos šaltinio nustatymui. Tai ypač svarbu sudėtinguose agentuose, kuriuose gali būti keli LLM kvietimai, įrankių sąveikos ir sąlyginė logika.
- Vėlinimas ir kaštų valdymas: AI agentai dažnai naudoja LLM ir kitas išorines API, kurios apmokestinamos už ženklą arba kvietimą. Stebimumas leidžia tiksliai sekti šiuos kvietimus, padėdamas nustatyti per lėtus arba brangius veiksmus. Tai leidžia komandoms optimizuoti užklausas, pasirinkti efektyvesnius modelius ar pertvarkyti darbo eigas, kad valdyti veiklos kaštus ir užtikrinti gerą vartotojo patirtį.
- Pasitikėjimas, saugumas ir atitiktis: Daugelyje taikymų svarbu užtikrinti, kad agentai veiktų saugiai ir etiškai. Stebimumas suteikia audito taką agento veiksmams ir sprendimams. Tai gali būti naudojama aptikti ir mažinti problemas, tokias kaip užklausų įpurškimas, žalingo turinio generavimas arba netinkamas asmeninės informacijos tvarkymas. Pavyzdžiui, galite peržiūrėti sekas, kad suprastumėte, kodėl agentas pateikė tam tikrą atsakymą arba naudojo konkretų įrankį.
- Nuolatinio tobulinimo ciklai: Stebimumo duomenys yra iteracinio vystymo proceso pagrindas. Stebint agentų veikimą realiame pasaulyje, komandos gali nustatyti tobulinimo sritis, surinkti duomenis modeliui tuninti ir įvertinti pakeitimų poveikį. Tai sukuria atgalinio ryšio ciklą, kai gamybos įžvalgos iš internetinio vertinimo informuoja apie offline eksperimentavimą ir tobulinimą, vedantį prie vis geresnio agentų našumo.
Pagrindiniai stebimi rodikliai
Norint stebėti ir suprasti agentų elgesį, reikia sekti įvairius rodiklius ir signalus. Nors specifiniai rodikliai gali skirtis priklausomai nuo agento paskirties, kai kurie yra universaliai svarbūs.
Štai keletas dažniausiai stebimų rodiklių:
Vėlinimas: Kaip greitai agentas atsako? Ilgas laukimo laikas neigiamai veikia vartotojo patirtį. Turėtumėte matuoti užduočių ir atskirų žingsnių vėlinimą sekant agento vykdymus. Pavyzdžiui, agentas, kuris visiems modeliavimo kvietimams užtrunka 20 sekundžių, gali būti pagreitintas naudojant greitesnį modelį arba vykdant modelių kvietimus lygiagrečiai.
Kaštai: Kiek kainuoja vienas agento vykdymas? AI agentai remiasi LLM kvietimais, kurie apmokestinami pagal ženklus arba išorinėmis API. Dažnas įrankių naudojimas ar keli užklausimai gali sparčiai didinti kaštus. Pavyzdžiui, jei agentas penkis kartus kreipiasi į LLM dėl nedidelio kokybės pagerinimo, turite įvertinti, ar tai verta kaštų arba ar būtų galima sumažinti kvietimų skaičių ar naudoti pigesnį modelį. Realaus laiko stebėjimas taip pat padeda aptikti netikėtus pikus (pvz., klaidas, sukeliančias per daug API kvietimų).
Užklausų klaidos: Kiek užklausų agentas nepavyko atlikti? Tai gali būti API klaidos arba nepavykę įrankių kvietimai. Kad jūsų agentas būtų atsparesnis gamyboje, galite nustatyti rezervinius variantus arba pakartojimus. Pvz., jei LLM tiekėjas A neveikia, pereinate prie LLM tiekėjo B kaip atsarginio.
Vartotojo atsiliepimai: Tiesioginiai vartotojų vertinimai suteikia vertingų įžvalgų. Tai gali būti aiškūs vertinimai (👍patinka/👎nepatinka, ⭐1-5 žvaigždutės) arba tekstiniai komentarai. Nuolatiniai neigiami atsiliepimai turi jus įspėti, nes tai ženklas, kad agentas neveikia kaip tikėtasi.
Netiesioginiai vartotojo atsiliepimai: Vartotojų elgesys suteikia netiesioginį grįžtamąjį ryšį net be aiškių vertinimų. Tai gali būti klausimų perrašymai, pakartotiniai užklausimai arba bandymo mygtuko paspaudimai. Pvz., jei matote, kad vartotojai kelis kartus užduoda tą patį klausimą, tai yra ženklas, kad agentas neveikia pagal lūkesčius.
Tikslumas: Kaip dažnai agentas generuoja teisingą arba pageidaujamą išvestį? Tikslumo apibrėžimai skiriasi (pvz., problemų sprendimo teisingumas, informacijos paieškos tikslumas, vartotojo pasitenkinimas). Pirmas žingsnis yra apibrėžti, ką jūsų agentas laiko sėkme. Tikslumą galite stebėti automatiniais patikrinimais, vertinimo balais arba užduoties įvykdymo žymomis. Pavyzdžiui, žymėdami sekas kaip „pavyko“ arba „nepavyko“.
Automatiniai vertinimo rodikliai: Taip pat galite nustatyti automatinius vertinimus. Pavyzdžiui, galite naudoti LLM įvertinti agento išvestį, pvz., ar ji naudinga, tiksli ar ne. Yra keletas atviro kodo bibliotekų, kurios padeda vertinti skirtingus agento aspektus. Pvz., RAGAS skirtas RAG agentams arba LLM Guard žalingos kalbos ar užklausų įpurškimo aptikimui.
Praktikoje geriausią agento būklės aprėptį suteikia šių metrikų derinys. Šioje skyriaus pavyzdinėje užrašų knygoje pamatysite, kaip šie rodikliai atrodo realiose situacijose, bet pirmiausia išmokime, kaip atrodo tipinis vertinimo procesas.
Instrumentuokite savo agentą
Norėdami rinkti sekimo duomenis, turėsite instrumentuoti savo kodą. Tikslas – instrumentuoti agento kodą taip, kad būtų generuojamos sekos ir metrikos, kurias galima kaupti, apdoroti ir vizualizuoti stebimumo platformoje.
OpenTelemetry (OTel): OpenTelemetry tapo pramonės standartu LLM stebimumui. Ji teikia API, SDK ir įrankių rinkinį telemetrijos duomenims generuoti, rinkti ir eksportuoti.
Yra daug instrumentacijos bibliotekų, kurios supakuoja esamus agentų rinkinius ir leidžia lengvai eksportuoti OpenTelemetry intervalus į stebimumo įrankį. Microsoft Agent Framework natūraliai integruotas su OpenTelemetry. Žemiau pateiktas pavyzdys, kaip instrumentuoti MAF agentą:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
Šio skyriaus pavyzdinė užrašų knyga parodys, kaip instrumentuoti savo MAF agentą.
Rankinis intervalų kūrimas: Nors instrumentacijos bibliotekos suteikia gerą bazę, dažnai reikia detalesnės ar individualios informacijos. Galite rankiniu būdu kurti intervalus, kad pridėtumėte savo programos logiką. Svarbiausia, jie gali praturtinti automatiškai arba rankiniu būdu sukurtus intervalus su specialiais atributais (taip pat žinomais kaip žymės arba metaduomenys). Šie atributai gali būti verslo specifiniai duomenys, tarpiniai skaičiavimai arba bet koks kontekstas, naudingas derinimui ar analizei, pavyzdžiui, user_id, session_id arba model_version.
Pavyzdys, kaip rankiniu būdu kurti sekas ir intervalus naudojant Langfuse Python SDK:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
Agentų vertinimas
Stebimumas suteikia metrikas, bet vertinimas yra procesas, kurio metu analizuojami šie duomenys (atliekami testai), siekiant nustatyti, kaip gerai veikia AI agentas ir kaip jį galima patobulinti. Kitaip tariant, kai turite sekas ir metrikas, kaip jas naudoti agento vertinimui ir sprendimų priėmimui?
Reguliarus vertinimas svarbus, nes AI agentai dažnai būna nedeterministiniai ir gali vystytis (atnaujinimų ar modelio elgesio pasikeitimo dėka) – be vertinimo nežinotumėte, ar jūsų „protingas agentas“ iš tiesų gerai dirba ar patiri regresiją.
AI agentų vertinimai skirstomi į dvi kategorijas: internetinį vertinimą ir offline vertinimą. Abu yra vertingi ir papildo vienas kitą. Paprastai pradedame nuo offline vertinimo, nes tai minimalus būtinas žingsnis prieš diegiant bet kurį agentą.
Offline vertinimas
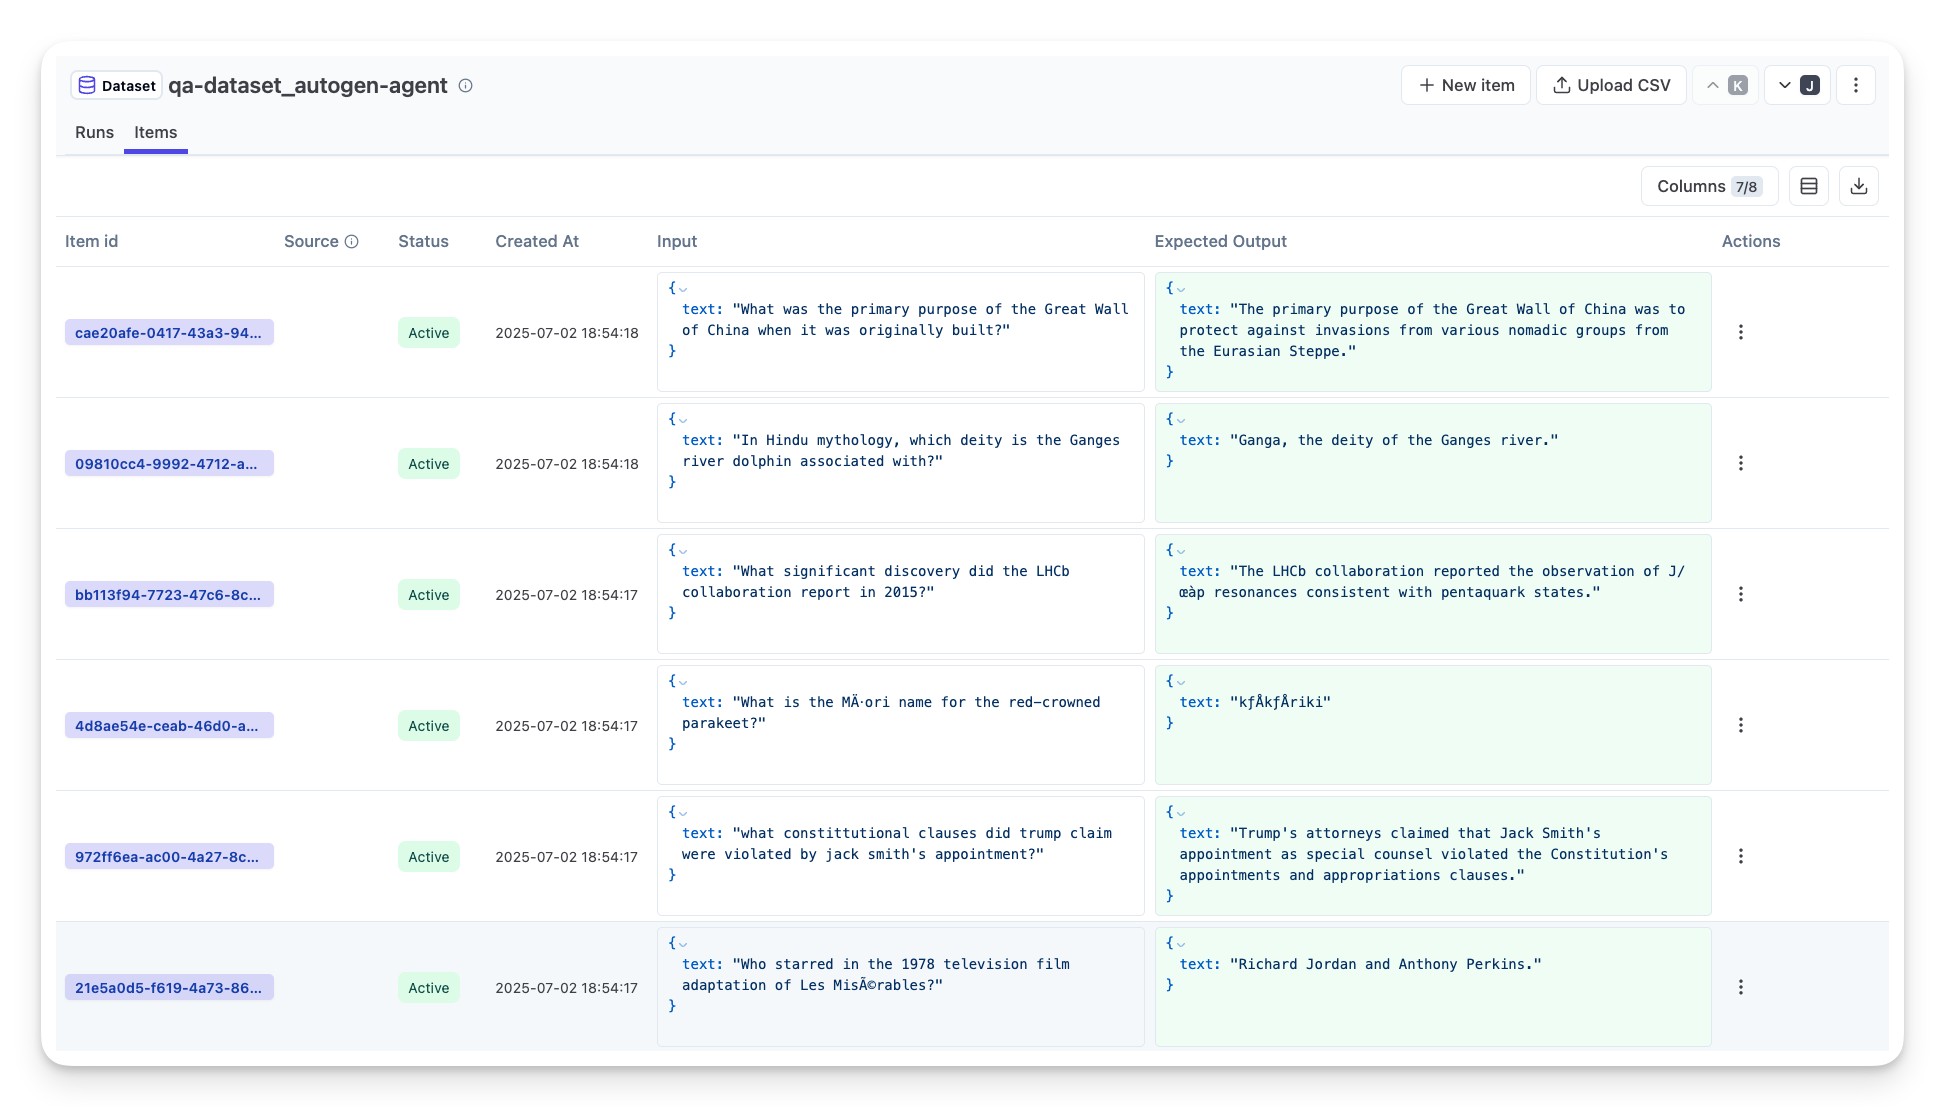
Tai reiškia agento vertinimą kontroliuojamoje aplinkoje, paprastai naudojant testinius duomenų rinkinius, o ne tiesiogines vartotojų užklausas. Naudojate paruoštus duomenų rinkinius, kuriuose žinote, kokia yra tikėtina išvestis ar teisingas elgesys, ir tada vykdote savo agentą juose.
Pavyzdžiui, jei sukūrėte matematikos žodinių uždavinių agentą, galite turėti testinį duomenų rinkinį su 100 problemų su žinomais atsakymais. Offline vertinimas dažnai atliekamas vystymo metu (gali būti CI/CD kelių dalis), kad būtų patikrinti patobulinimai arba išvengta regresijų. Privalumas: jis yra pakartojamas ir galite gauti aiškius tikslumo rodiklius, nes turite tiesą. Taip pat galite simuliuoti vartotojų užklausas ir palyginti agento atsakymus su idealiais atsakymais arba naudoti automatinius rodiklius, kaip aprašyta aukščiau.
Pagrindinė offline vertinimo problema yra užtikrinti, kad jūsų testinis duomenų rinkinys būtų išsamus ir aktualus – agentas gali gerai veikti fiksuotame testų rinkinyje, bet susidurti su labai skirtingomis realios gamybos užklausomis. Todėl turėtumėte nuolat atnaujinti testinius rinkinius naujais kraštutiniais atvejais ir pavyzdžiais, atspindinčiais realias situacijas. Naudinga turėti ir mažus „dūmų testus“ greitai patikrinti, ir didesnius rinkinius platesniems našumo rodikliams.
Internetinis (online) vertinimas
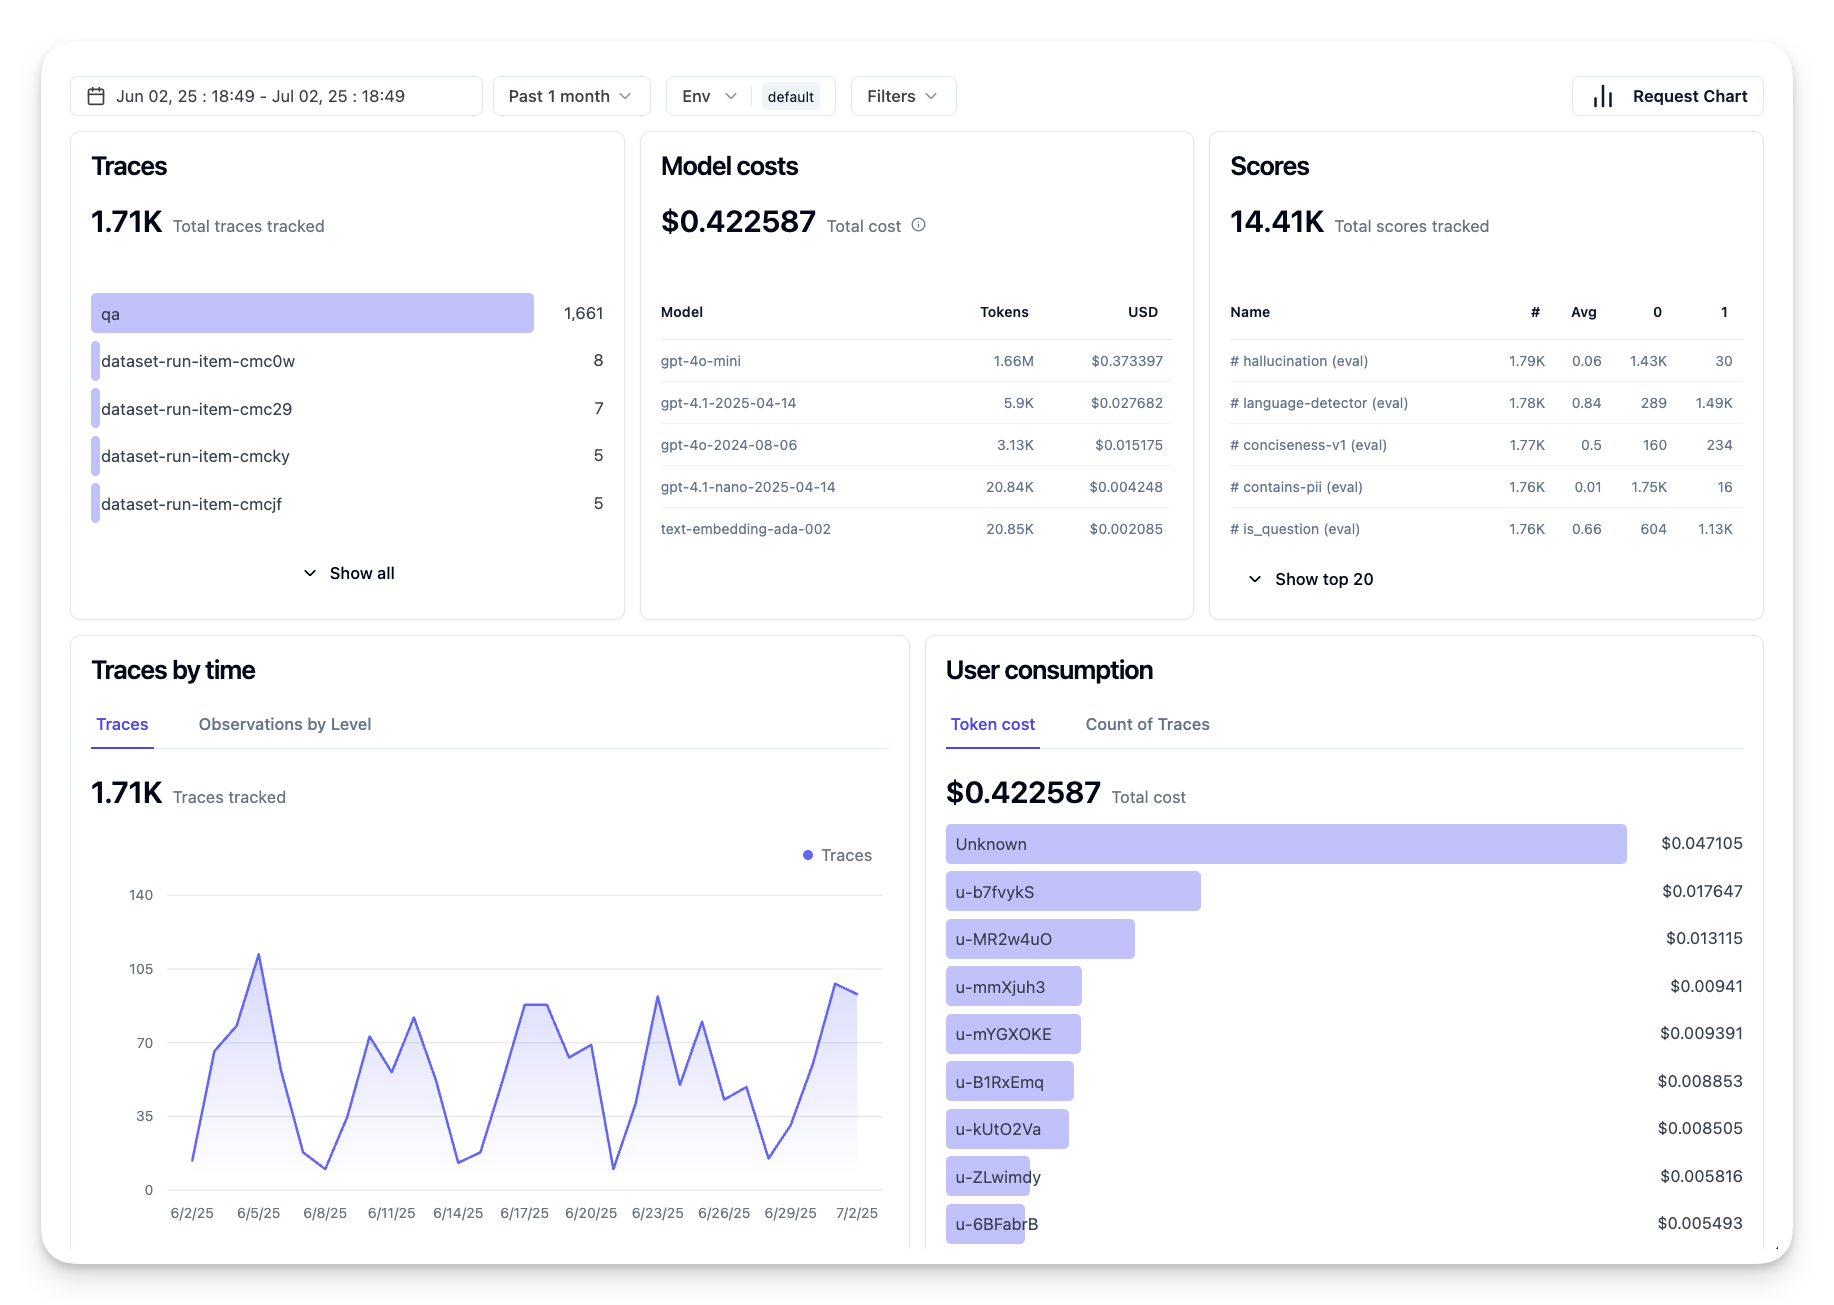
Tai reiškia agento vertinimą tiesioginėje, realioje aplinkoje, t.y. faktiškai gamybos naudojimo metu. Internetinis vertinimas apima agento veiklos stebėjimą realiose vartotojų sąveikose ir nuolatinį rezultatų analizavimą.
Pavyzdžiui, galite stebėti sėkmės rodiklius, vartotojų pasitenkinimo balus arba kitus rodiklius gyvame sraute. Internetinio vertinimo privalumas, kad jis atspindi tai, ko negalėtumėte numatyti laboratorijoje – matote modelio pasikeitimus laikui bėgant (jei agento efektyvumas blogėja dėl įvesties šablonų pasikeitimo) ir aptinkate netikėtas užklausas ar situacijas, kurių nebuvo testų duomenyse. Tai pateikia tikrą agento elgesio vaizdą gamtoje.
Internetinis vertinimas dažnai apima tiek netiesioginių, tiek tiesioginių vartotojų atsiliepimų rinkimą, kaip minėta, ir galbūt šešėlines ar A/B testų vykdymą (kai nauja agento versija veikia lygiagrečiai su sena, siekiant palyginti). Iššūkis – įvertinti patikimai gyvas sąveikas su etiketėmis ar balais – gali tekti remtis vartotojų atsiliepimais arba pasėkminiais rodikliais (pvz., ar vartotojas paspaudė rezultatą).
Abiejų derinimas
Internetiniai ir offline vertinimai nėra vienas kitam prieštaraujantys – jie puikiai papildo vienas kitą. Internetinio stebėjimo įžvalgos (pvz., nauji vartotojų užklausų tipai, kur agentas veikia prastai) gali būti naudojamos papildyti ir pagerinti offline testinius rinkinius. Atvirkščiai, agentai, kurie gerai veikia offline testuose, gali būti labiau patikimai diegiami ir stebimi internetu.
Daugelis komandų taiko ciklą:
offline vertinimas -> diegimas -> internetinis stebėjimas -> naujų klaidų rinkimas -> pridėjimas prie offline rinkinio -> agento tobulinimas -> kartojama.
Dažnos problemos
Diegiant AI agentus gamyboje galite susidurti su įvairiomis problemomis. Štai keletas dažnų problemų ir galimų sprendimų:
| Problema | Galimas sprendimas |
|---|---|
| AI agentas neatlieka užduočių nuosekliai | - Patobulinkite agento pateikiamą užklausą; aiškiai nurodykite tikslus. - Nustatykite, ar galima užduotį suskaidyti į mažesnes dalis ir apdoroti ją kelių agentų. |
| AI agentas įstringa nuolatiniuose cikluose | - Užtikrinkite aiškias proceso užbaigimo sąlygas, kad agentas žinotų, kada sustoti. - Sudėtingoms užduotims, reikalaujančioms mąstymo ir planavimo, naudokite didesnį modelį, skirtą sudėtingoms užduotims. |
| AI agento įrankių kvietimai veikia prastai | - Testuokite ir patikrinkite įrankio rezultatus nepriklausomai nuo agentų sistemos. - Patobulinkite apibrėžtus parametrus, užklausas ir įrankių pavadinimus. |
| Daugiaagentė sistema veikia nenuosekliai | - Patobulinkite kiekvieno agente pateikiamas užklausas, kad jos būtų specifinės ir skirtingos. - Sukurkite hierarchinę sistemą, naudodami „maršruto“ ar valdymo agentą, kuris nustato tinkamą agentą. |
Daugelis šių problemų gali būti efektviau identifikuotos turint stebimumą. Aptartų sekų ir metrikų pagalba galima tiksliai nustatyti, kur agentų darbo eigoje vyksta problemos, todėl derinimas ir optimizavimas yra žymiai efektyvesni.
Kaštų valdymas
Štai keletas strategijų, kaip valdyti AI agentų diegimo gamyboje kaštus:
Naudojant mažesnius modelius: Mažieji kalbos modeliai (SLM) gali gerai veikti tam tikruose agentų naudojimo atvejuose ir ženkliai sumažinti išlaidas. Kaip minėta anksčiau, geriausias būdas suprasti, kaip gerai SLM veiks jūsų atveju – sukurti vertinimo sistemą, leidžiančią įvertinti ir palyginti našumą su didesniais modeliais. Svarstykite naudoti SLM paprastesnėms užduotims, tokioms kaip ketinimų klasifikavimas ar parametrų išgavimas, o sudėtingiems samprotavimams naudokite didesnius modelius.
Naudojant maršrutizatoriaus modelį: Panaši strategija yra naudoti įvairovę modelių ir dydžių. Galite naudoti LLM/SLM arba be serverio funkciją, kad maršrutizuotumėte užklausas pagal sudėtingumą į geriausiai tinkamus modelius. Tai taip pat padės sumažinti kaštus ir užtikrins našumą tinkamoms užduotims. Pavyzdžiui, paprastas užklausas nukreipkite į mažesnius, greitesnius modelius, o brangius didelius modelius naudokite tik sudėtingiems samprotavimo uždaviniams.
Atsakymų talpinimas: Nustatyti dažnas užklausas ir užduotis bei pateikti atsakymus prieš jiems einant per jūsų agentų sistemą yra geras būdas sumažinti panašių užklausų kiekį. Netgi galite sukurti srautą, skirtą nustatyti, kiek užklausa panaši į jūsų talpykloje esančias užklausas, naudodami paprastesnius DI modelius. Ši strategija gali ženkliai sumažinti kaštus dažnai užduodamiems klausimams ar įprastiems darbo srautams.
Pažiūrėkime, kaip tai veikia praktiškai
Šio skyriaus pavyzdiniame užrašų knygelėje pamatysime pavyzdžių, kaip naudoti stebėjimo įrankius mūsų agentui stebėti ir vertinti.
Turite daugiau klausimų apie DI agentus gamyboje?
Prisijunkite prie Microsoft Foundry Discord, kad susipažintumėte su kitais besimokančiais, dalyvautumėte konsultacijose ir gautumėte atsakymus į savo klausimus apie DI agentus.
Ankstesnė pamoka
Metakognicijos dizaino šablonas
Kitoji pamoka
Atsakomybės apribojimas: Šis dokumentas buvo išverstas naudojant dirbtinio intelekto vertimo paslaugą Co-op Translator. Nors siekiame tikslumo, prašome atkreipti dėmesį, kad automatiniai vertimai gali turėti klaidų ar netikslumų. Originalus dokumentas jo gimtąja kalba laikomas autoritetingu šaltiniu. Svarbiai informacijai rekomenduojama naudoti profesionalų žmogiškąjį vertimą. Mes neatsakome už jokius nesusipratimus ar neteisingą interpretaciją, kilusią naudojantis šiuo vertimu.