ai-agents-for-beginners
പ്രൊഡക്ഷനിലെ AI ഏജന്റുകൾ: അവലോകനവും മൂല്യനിർണയവും
AI ഏജന്റുകൾ പരീക്ഷണ പ്രോട്ടോไപ്പുകളിൽ നിന്ന് യാഥാർത്ഥ്യ പ്രയോഗങ്ങളിലേക്ക് നീങ്ങുമ്പോൾ, അവയുടെ പ്രവൃത്തി മനസ്സിലാക്കാനും അവയുടെ പ്രകടനം നിരീക്ഷിക്കാനും അവരുടെ ഫലങ്ങൾ ഘടിതരീതിയിൽ മൂല്യനിർണയം ചെയ്യാനുമുള്ള കഴിവ് მნიშვნელოვანი ആകുന്നു.
പഠന ലക്ഷ്യങ്ങൾ
ഈ പാഠം പൂർത്തിയാക്കിയശേഷം, നിങ്ങൾക്ക് താഴെ പ്രവർത്തനങ്ങൾ നടത്താനും മനസ്സിലാക്കാനും കഴിയും:
- ഏജന്റ് അവലോകനം, മൂല്യനിർണയം എന്നിവയുടെ ആശയങ്ങൾ
- ഏജന്റുകളുടെ പ്രകടനം, ചെലവുകൾ, ഫലപ്രാപ്തി എന്നിവ മെച്ചപ്പെടുത്താനുള്ള സാങ്കേതിക വിദ്യകൾ
- നിങ്ങളുടെ AI ഏജന്റുകൾ ഘടിതരീതിയിൽ എങ്ങനെ മൂല്യനിർണയം ചെയ്യാമെന്ന്
- പ്രൊഡക്ഷനിലേക്ക് AI ഏജന്റുകൾ വിന്യസിക്കുമ്പോൾ ചെലവുകൾ നിയന്ത്രിക്കുന്നത് എങ്ങനെ
- മൈക്രോസോഫ്റ്റ് ഏജന്റ് ഫ്രെയിംവർക്ക് ഉപയോഗിച്ചുള്ള ഏജന്റുകൾക്ക് ഇൻസ്ട്രുമെന്റേഷൻ നൽകുന്നത് എങ്ങനെ
ലക്ഷ്യം നിങ്ങളുടെ “ബ്ളാക് ബോക്സ്” ഏജന്റുകളെ പാരదర్శകമായ, നിയന്ത്രിക്കാവുന്ന, വിശ്വസനീയമായ സിസ്റ്റങ്ങളായി മാറ്റാൻ വേണ്ട അറിവുകൾ നൽകുകയാണ്.
കുറിപ്പ്: സുരക്ഷിതവും വിശ്വസനീയവുമായ AI ഏജന്റുകൾ വിന്യസിക്കുന്നത് അത്യന്താപേക്ഷിതമാണ്. Building Trustworthy AI Agents പാഠവും പരിശോധിക്കുക.
ട്രേസുകളും സ്പാനുകളും
Langfuse അല്ലെങ്കിൽ Microsoft Foundry പോലുള്ള അവലോകനം ഉപകരണങ്ങൾ സാധാരണയായി ഏജന്റ് പ്രവർത്തനങ്ങളെ ട്രേസുകളായി സ്പാനുകളായി പ്രദർശിപ്പിക്കുന്നു.
- ട്രേസ് ഒരു ഏജന്റെ മുഴുവൻ പ്രവൃത്തി ആരംഭം മുതൽ സമാപനം വരെ പ്രതിനിധാനം ചെയ്യുന്നു (ഉദാ: ഉപയോക്തൃ ചോദ്യം കൈകാര്യം ചെയ്യൽ).
- സ്പാനുകൾ ട്രേസിനുള്ളിൽ വ്യക്തിഗത ഘട്ടങ്ങളാണ് (ഉദാ: ഭാഷാ മodel് വിളിക്കൽ അല്ലെങ്കിൽ ഡാറ്റ എടുക്കൽ).
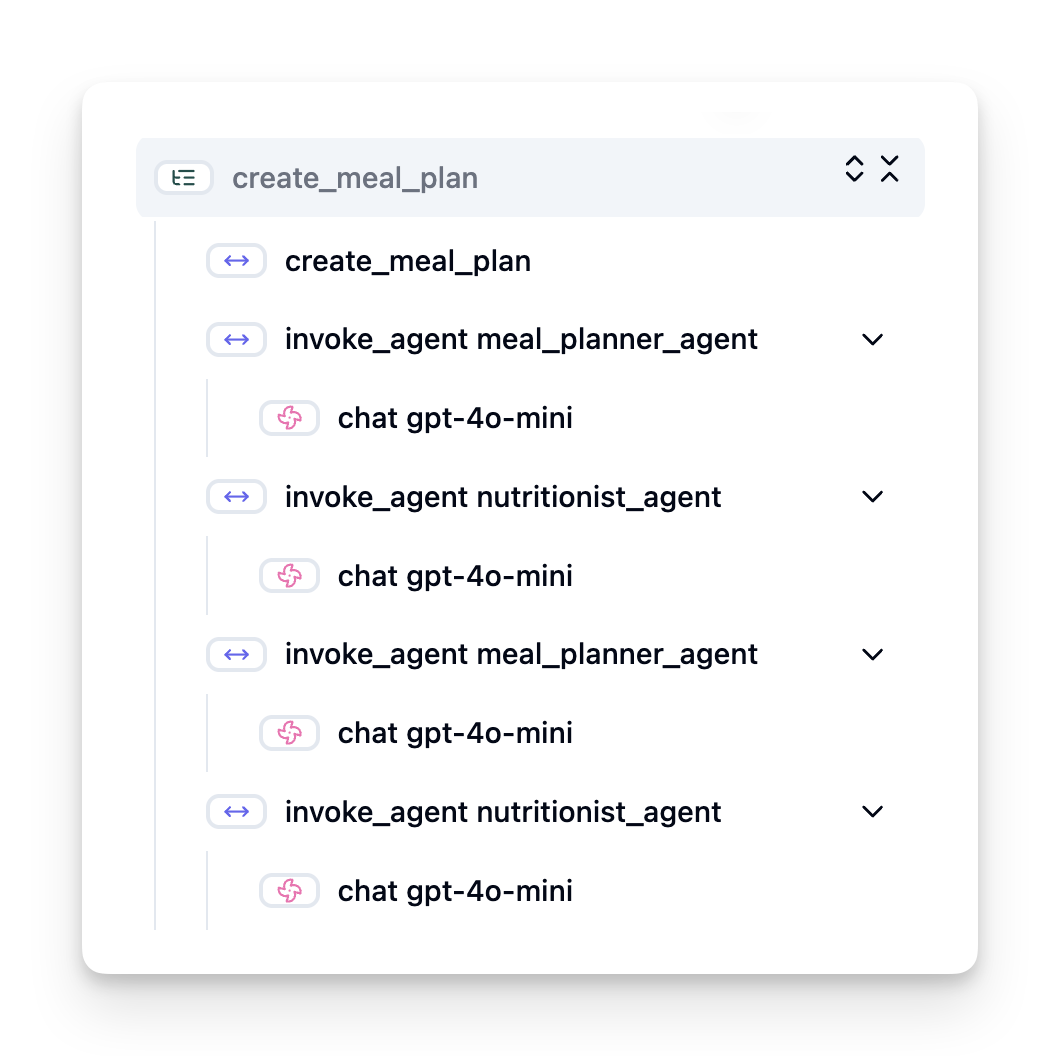
അവലോകനം ഇല്ലാതെ, AI ഏജന്റ് ഒരു “ബ്ളാക് ബോക്സ്” പോലെയാകും - അതിന്റെ ആഭ്യന്തരം അപ്രകാശമായിരിക്കും, പ്രശ്നങ്ങൾ നിഖിതം കണ്ടെത്തലും പ്രകടനം മെച്ചപ്പെടുത്തലും പ്രയാസമാകും. അവലോകനത്തോടെ, ഏജന്റുകൾ “ഗ്ലാസ് ബോക്സുകൾ” ആകുന്നു, വിശ്വാസം നിർമ്മിക്കാൻ ആവശ്യമായ പാര straightforwardത്വം നൽകുന്നു.
പ്രൊഡക്ഷൻ പരിസ്ഥിതികളിൽ അവലോകനം എന്തുകൊണ്ട് പ്രാധാന്യം കരുതപ്പെടുന്നു
AI ഏജന്റുകൾ പ്രൊഡക്ഷൻ പരിസ്ഥിതിയിലെത്തുന്നത് പുതിയ വെല്ലുവിളികളും ആവശ്യങ്ങളും ഉണ്ടാക്കുന്നു. അവലോകനം “നല്ലത്” അല്ല, അത്യന്താപേക്ഷിത കഴിവാണ്:
- ഡിബഗ്ഗിംഗ്, മൂലകാരണ വിശകലനം: ഏജന്റ് പരാജയപ്പെടുമ്പോൾ അല്ലെങ്കിൽ അനുദീക്ഷിത ഫലങ്ങൾ ഉണ്ടാക്കുമ്പോൾ, അവലോകന ഉപകരണങ്ങൾ പ്രശ്നത്തിന്റെ ഉറവിടം കണ്ടെത്താൻ ട്രേസുകൾ നൽകുന്നു. ബഹുമുഖ LLM വിളികളുള്ള, ഉപകരണ ഇടപെടലുകളുള്ള, നിബന്ധനാപരമായ ലജിക് ഉള്ള സങ്കീർണ ഏജന്റുകളിലേക്ക് ഇത് പ്രത്യേകിച്ച് പ്രാധാന്യമുണ്ട്.
- വൈലന്സിയും ചെലവിന്റെ മാനേജുമെന്റും: AI ഏജന്റുകൾ LLM കളിലും മറ്റ് ബാഹ്യ API കളിലുമായി ടോക്കൻ അടിസ്ഥാനത്തിൽ അല്ലെങ്കിൽ കോളിൻ പ്രകാരം ബിൽ ചെയ്യപ്പെടുന്നു. അവലോകനം ഈ കോള്ട്രാക്കിംഗ് കൃത്യമായി നടത്താൻ സാധിക്കുന്നു, സ്ലോ അല്ലെങ്കിൽ ചെലവേറിയ പ്രവർത്തനങ്ങൾ തിരിച്ചറിയാൻ സഹായിക്കുന്നു. ഇത് ടീമുകൾക്ക് പ്രോമ്പ്റ്റുകൾ മെച്ചപ്പെടുത്താനും, കൂടുതൽ കാര്യക്ഷമമായ മോഡലുകൾ തിരഞ്ഞെടുക്കാനുമോ, പ്രവൃത്തി ഫ്ലോകൾ പുനർഡിസൈൻ ചെയ്യാനുമോ സഹായിക്കുന്നു, പ്രവർത്തന ചെലവുകൾ നിയന്ത്രിക്കുകയും മികച്ച ഉപയോക്തൃ അനുഭവം ഉറപ്പു വരുത്തുകയും ചെയ്യുന്നു.
- വിശ്വാസം, സുരക്ഷ, പാലനം: പല പ്രയോഗങ്ങളിലും, ഏജന്റുകൾ സുരക്ഷിതവും നൈതികവുമായ രീതിയിൽ പ്രവർത്തിക്കുന്നുവെന്ന് ഉറപ്പാക്കേണ്ടത് നിർദേശം ആണ്. അവലോകനം ഏജന്റ് പ്രവർത്തി, തീരുമാനങ്ങളുടെ ഓഡിറ്റ് ട്രെയിൽ നൽകുന്നു. ഇത് പ്രോമ്പ്റ്റ് ഇൻജെക്ഷൻ, ഹാനികരമായ ഉള്ളടക്കം സൃഷ്ടിക്കൽ, വ്യക്തിമുദ്രിത വിവരങ്ങൾ (PII) തെറ്റായി കൈകാര്യം ചെയ്യൽ പോലുള്ള പ്രശ്നങ്ങൾ കണ്ടെത്താനും നിയന്ത്രിക്കാനും ഉപയോഗിക്കാം. ഉദാഹരണത്തിന്, ഏജന്റ് ഒരു പ്രത്യേക പ്രതികരണം കൊടുത്തതെന്തുകൊണ്ടെന്നോ പ്രത്യേക ഉപകരണം ഉപയോഗിച്ചതെന്തുകൊണ്ടെന്നോ പരിശോധിക്കാൻ ട്രേസുകൾ പരിശോധിക്കാം.
- ചിറകെങ്കിലും മെച്ചപ്പെടുത്തൽ ചക്രങ്ങൾ: അവലോകന ഡാറ്റ തുടർച്ചയായ വികസന പ്രക്രിയയുടെ അടിസ്ഥാനമാണ്. യാഥാർഥ്യത്തിൽ ഏജന്റുകളുടെ പ്രകടനം നിരീക്ഷിച്ച്, മെച്ചപ്പെടുത്തേണ്ട മേഖലകൾ കണ്ടെത്തി, മോഡലുകൾ ഫൈൻ-ട്യൂണിങ്ങിനും മാറ്റത്തിന്റെ സ്വാധീനം അംഗീകൃതമാക്കുന്നതിനും ഡേറ്റ ശേഖരിക്കും. ഇത് ഒരു സാന്ദ്രമായ ഫീഡ്ബാക്ക് ചക്രം സൃഷ്ടിക്കുന്നു, ഇപ്രകാരം പ്രൊഡക്ഷൻ洞ലും ഓൺലൈൻ വിലയിരുത്തലും ഓഫ്ലൈൻ പരീക്ഷണവും മെച്ചപ്പെടുത്തലും തമ്മിൽ ബന്ധപ്പെടുന്നു, തുടർച്ചയായി ഏജന്റ് പ്രകടനം മെച്ചപ്പെടുന്നു.
ട്രാക്ക് ചെയ്യേണ്ട പ്രധാന മെറ്റ്രിക്കുകൾ
ഏജന്റിന്റെ പെരുമാറ്റം നിരീക്ഷിക്കുന്നതിനും മനസ്സിലാക്കുന്നതിനും, വിവിധ മെറ്റ്രിക്കുകളും സിഗ്നലുകളും ട്രാക്ക് ചെയ്യണം. ഏജന്റിന്റെ ലക്ഷനുസരിച്ച് പ്രത്യേക മെറ്റ്രിക്കുകൾ വ്യത്യാസപ്പെട്ടാലും, ചിലത് സർവത്ര പ്രധാനം.
അവലോകന ഉപകരണങ്ങൾ സാധാരണയായി നിരീക്ഷിക്കുന്ന ചില മുൻവശ മെറ്റ്രിക്കുകൾ:
വൈലന്സി: ഏജന്റ് എത്ര അതീവ വേഗത്തിൽ പ്രതികരിക്കുന്നു? ദൈർഘ്യമേറിയ കാത്തിരിപ്പുകൾ ഉപയോക്തൃ അനുഭവത്തിന് ഹാനികരമാണ്. ഏജന്റ് പ്രവർത്തനങ്ങൾക്കും വ്യക്തിഗത ഘട്ടങ്ങൾക്കും വൈലന്സി അളക്കണം ട്രേസിംഗ് വഴി. ഉദാഹരണത്തിന്, എല്ലാ മോഡല് കോളുകളും പുതിയിച്ച 20 സെക്കൻഡ് വൈകിയ ഏജന്റ് വേഗതയേറിയ മോഡൽ ഉപയോഗിക്കുക കൊണ്ടോ ഒന്ന് പാരലെൽ കോൾ ചെയ്ത് വേഗത്തിലാക്കാം.
ചെലവുകൾ: ഏജന്റ് പ്രവർത്തനം എത്ര ചെലവാണ്? AI ഏജന്റുകൾ ടോക്കൻ അടിസ്ഥാനത്തിലുള്ള LLM കോൾകൾക്കും ബാഹ്യ APIകൾക്കും ആശ്രയിക്കുന്നു. ഉപകരണം ആവർത്തിക്കുന്നതും, നിരവധി പ്രോമ്പ്റ്റുകളും ചെലവ് വേഗത്തിൽ വർദ്ധിപ്പിക്കും. ഉദാഹരണത്തിന്, ഒരു ഏജന്റ് LLM അഞ്ചു തവണ വിളിച്ച് ചെറിയ ഗുണനിലവാരം മെച്ചപ്പെടുത്തുവാൻ ചെയ്തെങ്കിൽ, ചെലവ് ഒത്തുകൂടുമോ എന്ന് വിലയിരുത്തണം അല്ലെങ്കിൽ കോളുകൾ കുറക്കാനോ, കിഫായതായ മോഡൽ തിരഞ്ഞെടുക്കാനോ പരിശ്രമിക്കണം. യഥാർത്ഥ സമയ നിരീക്ഷണം പോലുള്ള അനുമാനിക്കാത്ത ഉയർച്ചകൾ തിരിച്ചറിയാനും സഹായിക്കും (ഉദാ: ബഗ് മൂലം അധിക API ലൂപ്പുകൾ).
അഭ്യർത്ഥനാപിശകുകൾ: ഏജന്റ് എത്ര അഭ്യർത്ഥനകൾ പരാജയപ്പെട്ടു? ഇതിൽ API പിശകുകളും ഉപകരണം പരാജയപ്പെടലുകളും ഉൾപ്പെടാം. പ്രൊഡക്ഷനിൽ ഏജന്റ് കൂടുതൽ ദൃഢമാകാൻ ഫാൾബാക്കുകളും വീണ്ടും പരീക്ഷണ സംവിധാനങ്ങളും സജ്ജീകരിക്കാം. ഉദാഹരണത്തിന്, LLM പ്രൊവൈഡർ A ഓഫ് ആയാൽ, ബാക്കപ്പ് ആയി LLM പ്രൊവൈഡർ B ഉപയോഗിക്കുക.
ഉപയോക്തൃ പ്രതികരണം: നേരിട്ട് ഉപയോക്തൃ മൂല്യനിർണയം വിലപ്പെട്ട洞ലുകൾ നൽകുന്നു. ഇത് വ്യക്തമായ റേറ്റിങ്ങുകൾ (👍ഉപ്പയോക്തൃപാലിക്കൽ/👎താഴ്ന്നറിയിപ്പ്, ⭐1-5 നക്ഷത്രങ്ങൾ) അല്ലെങ്കിൽ എഴുത്തുപോലുള്ള അഭിപ്രായങ്ങളും ഉൾക്കൊള്ളാം. സ്ഥിരമായ നെഗറ്റീവ് പ്രതികരണം ഏജന്റ് ആകണമെന്നും പക്ഷം മാത്രമല്ല പ്രവർത്തിക്കുന്നില്ലെന്ന് സൂചിപ്പിക്കുന്നു.
അനുപ്രത്യക്ഷ ഉപയോക്തൃ പ്രതികരണം: വ്യക്തയായ റേറ്റിങ്ങുകൾ ഇല്ലാതെയും ഉപയോക്തൃ പെരുമാറ്റങ്ങൾ അനുപ്രത്യക്ഷ പ്രതികരണം നൽകുന്നു. ഇതിൽ ഉടൻ ചോദ്യം പുനരുപയോഗം, ചോദ്യങ്ങൾ ആവർത്തനം, റിപ്ലെയ് ബട്ടൺ ക്ലിക്ക് എന്നിവയ്ക്ക് ഉൾപ്പെടാം. ഉദാഹരണത്തിന്, ഉപയോക്താക്കൾ ഒരേ ചോദ്യം പലതവണ ചോദിക്കുന്നുവെങ്കിൽ, ഏജന്റ് അവ്യക്തമായി പ്രവർത്തിക്കുകയാണ് എന്ന് അറിയിക്കുന്നു.
ശുദ്ധത: ഏജന്റ് എത്ര ഊന്നിയതായി ശരിയായതോ ഇഷ്ടാനുസൃതമോ ഉള്ള ഔട്ട്പുട്ടുകൾ നൽകും? ശുദ്ധത നിർവചനങ്ങൾ വ്യത്യാസപ്പെട്ടേക്കാം (ഉദാ: പ്രശ്നപരിഹാര ശരിയായതോ, വിവര ശേഖരണശുദ്ധത, ഉപയോക്തൃ സംതൃപ്തി). ആദ്യം ഏജന്റിന് വിജയം എന്താണെന്ന് നിർവചിക്കണം. സ്വയം നിയന്ത്രിത പരിശോധനകൾ, മൂല്യനിർണയ സ്കോറുകൾ, പ്രവർത്തന പൂർത്തീകരണ ലേബലുകൾ എന്നിവ വഴി ശുദ്ധത ട്രാക്ക് ചെയ്യാം. ഉദാഹരണത്തിന്, ട്രേസുകൾ “വിജയിച്ച” അല്ലെങ്കിൽ “പരാജയപ്പെട്ട” എന്നിങ്ങനെ അടയാളപ്പെടുത്തുക.
സ്വയംകരിയ മൂല്യനിർണയ മെറ്റ്രിക്കുകൾ: നിങ്ങൾക്ക് സ്വയംകരിയ മൂല്യനിർണയ സംവിധാനങ്ങളും സജ്ജീകരിക്കാം. ഉദാഹരണത്തിന്, output സഹായകരമാണോ, ശുദ്ധമാണോ അല്ലയോ എന്ന് മൂല്യനിർണയിക്കാൻ LLM ഉപയോഗിക്കാം. egg, RAGAS RAG ഏജന്റുകളുടെ മായി വിവിധ ഭാഗങ്ങൾ മൂല്യനിർണയിക്കാൻ താരതമ്യമുണ്ടാകാം; അല്ലെങ്കിൽ LLM Guard ഹാനികരമായ ഭാഷയും പ്രോമ്പ്റ്റ് ഇൻജെക്ഷനും കണ്ടെത്താൻ.
പ്രായോഗികമായി, ഈ മെറ്റ്രിക്കുകളുടെ സംയോജനം AI ഏജന്റിന്റെ ആരോഗ്യം ഏറ്റവും ശരിയായി അഞ്ചിടുന്നു. ഈ അധ്യായത്തിലെ ഉദാഹരണ നോട്ട്ബുക്ക് നിങ്ങൾക്കു ഈ മെറ്റ്രിക്കുകൾ യഥാർത്ഥ ഉദാഹരണങ്ങളിൽ എങ്ങനെ കാണപ്പെടുന്നു എന്ന് കാണിക്കും, പക്ഷേ ആദ്യം, സാധാരണ മൂല്യനിർണയ പ്രവൃത്തി ക്രമം എങ്ങനെയാണെന്ന് പഠിക്കാം.
നിങ്ങളുടെ ഏജന്റിനെ ഇൻസ്ട്രുമെന്റ് ചെയ്യുക
ട്രേസിംഗ് ഡാറ്റ ശേഖരിക്കാൻ, നിങ്ങളുടെ കോഡ് ഇൻസ്ട്രുമെന്റ് ചെയ്യേണ്ടിവരും. ലക്ഷ്യം ഏജന്റ് കോഡ് ഇൻസ്ട്രുമെന്റ് ചെയ്ത് അവലോകന പ്ലാറ്റ്ഫോമിൽ ക്രമീകരിക്കാവുന്ന, പ്രോസസ് ചെയ്യാവുന്ന, ദൃശ്യവൽക്കരിക്കാവുന്ന ട്രെയ്സുകളും മെറ്റ്രിക്കുകളും ഉളവാക്കുക ആണ്.
OpenTelemetry (OTel): OpenTelemetry LLM അവലോകനത്തിനു വ്യവസായ നിലവാരമായി വളർന്നു. ഇത് APIകൾ, SDKകൾ, ഉപകരണങ്ങൾ എന്നിവ നൽകി ടെലിമെട്രി ഡാറ്റ ജനനം, ശേഖരണം, റഫത്ത് ചെയ്യാനുള്ള സഹായി ഒരുക്കുന്നു.
നിലവിലുള്ള ഏജന്റ് ഫ്രെയിംവർക്കുകൾ ചുറ്റി കൂടിവയ്ക്കുന്ന പല ഇൻസ്ട്രുമെന്റേഷൻ ലൈബ്രറി ഉണ്ട്, അവ OpenTelemetry സ്പാനുകൾ അവലോകന ഉപകരണത്തിലേക്ക് എളുപ്പത്തിൽ റഫത്ത് ചെയ്യാൻ സഹായിക്കുന്നു. മൈക്രോസോഫ്റ്റ് ഏജന്റ് ഫ്രെയിംവർക്ക് OpenTelemetry നെയിട്ടീവായി ഇന്റഗ്രേറ്റ് ചെയ്തിരിക്കുന്നു. താഴെ MAF ഏജന്റ് ഇൻസ്ട്രുമെന്റേഷൻ ഉദാഹരണം:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
ഈ അധ്യായത്തിലെ ഉദാഹരണ നോട്ട്ബുക്ക് നിങ്ങൾക്ക് നിങ്ങളുടെ MAF ഏജന്റ് ഇൻസ്ട്രുമെന്റ് ചെയ്യാൻ കാണിക്കും.
മാനുവൽ സ്പാൻ സൃഷ്ടി: ഇൻസ്ട്രുമെന്റേഷൻ ലൈബ്രറികൾ നല്ല അടിസ്ഥാനമാണ് നൽകുന്നത്, എന്നാൽ കൂടുതൽ വിശദമായ അല്ലെങ്കിൽ കസ്റ്റം വിവരങ്ങൾ ആവശ്യമുള്ള സാഹചര്യങ്ങളുണ്ടാകാം. കസ്റ്റം એપ്ലിക്കേഷൻ ലജിക് ചേർക്കാൻ മാനുവൽ സ്പാനുകൾ സൃഷ്ടിക്കാം. പ്രധാനമെങ്കിലും, ഓട്ടോമാറ്റിക് അല്ലെങ്കിൽ മാനുവലായി സൃഷ്ടിച്ച സ്പാനുകൾക്ക് ബിസിനസ് വിശേഷ ഡാറ്റ, ഇടനില കണക്കുകൾ, ഡിബഗ്ഗിംഗിനോ വിശകലനത്തിനോ ഉപകാരമാകാനുള്ള ഏതെങ്കിലും കോൺടെക്സ്റ്റ് (e.g., user_id, session_id, model_version) കൂട്ടിച്ചേർക്കാവുന്നതാണ്.
Langfuse Python SDK ഉപയോഗിച്ച് ട്രേസുകളും സ്പാനുകളും മാനുവലായി സൃഷ്ടിക്കുന്ന ഉദാഹരണം:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
ഏജന്റ് മൂല്യനിർണയം
അവലോകനം ഞങ്ങൾക്ക് മെറ്റ്രിക്കുകൾ നൽകുന്നു, എന്നാൽ മൂല്യനിർണയം ആ ഡാറ്റ വിശകലനം ചെയ്യുന്നതും (പരിശോധനകൾ നടത്തിയും) ഏജന്റ് എങ്ങനെ പ്രകടിപ്പിക്കുന്നു, അതിനെ മെച്ചപ്പെടുത്താൻ എങ്ങനെ സാധിക്കും എന്നു തീരുമാനിക്കുന്ന പ്രക്രിയയാണ്. മറ്റവകാശത്തിൽ, ട്രേസുകളും മെറ്റ്രിക്കുകളും ലഭിച്ച ശേഷം, അവ ഉപയോഗിച്ച് ഏജന്റിനെ എങ്ങനെ വിലയിരുത്തുകയും തീരുമാനങ്ങൾ എടുക്കുകയും ചെയ്യും?
നിതാന്ത മൂല്യനിർണയം പ്രാധാന്യമാണ് കാരണം AI ഏജന്റുകൾ പലപ്പോഴും നേട്ടനിഷ്ടരായിരിക്കും, പുതുക്കലുകൾ അല്ലെങ്കിൽ മോഡൽ പെരുമാറ്റം തുളുമ്പൽ വഴി വളരാം – മൂല്യനിര്ണയം ഇല്ലാതെ നിങ്ങളുടെ “സ്മാർട്ട് ഏജന്റ്” ശരിയായി പ്രവൃത്തിയാണോ അല്ലയോ എന്ന് അറിയാൻ കഴിയില്ല.
AI ഏജന്റുകളുടെ മൂല്യനിർണയത്തിനായി രണ്ട് വിഭാഗങ്ങളുണ്ട്: ഓൺലൈൻ മൂല്യനിർണയം എന്നതും ഓഫ്ലൈൻ മൂല്യനിർണയം എന്നതും. ഇരുവരും മൂല്യവത്താണ്, പരസ്പരം പരിപൂരകവും. സാധാരണയായി, ഏജന്റ് വിന്യസിക്കുന്നതിന് മുമ്പ് കുറഞ്ഞത് ആവശ്യമുള്ള ഘട്ടമായ ഒഫ്ലൈൻ മൂല്യനിർണയം ആരംഭിക്കാറുണ്ട്.
ഓഫ്ലൈൻ മൂല്യനിർണയം
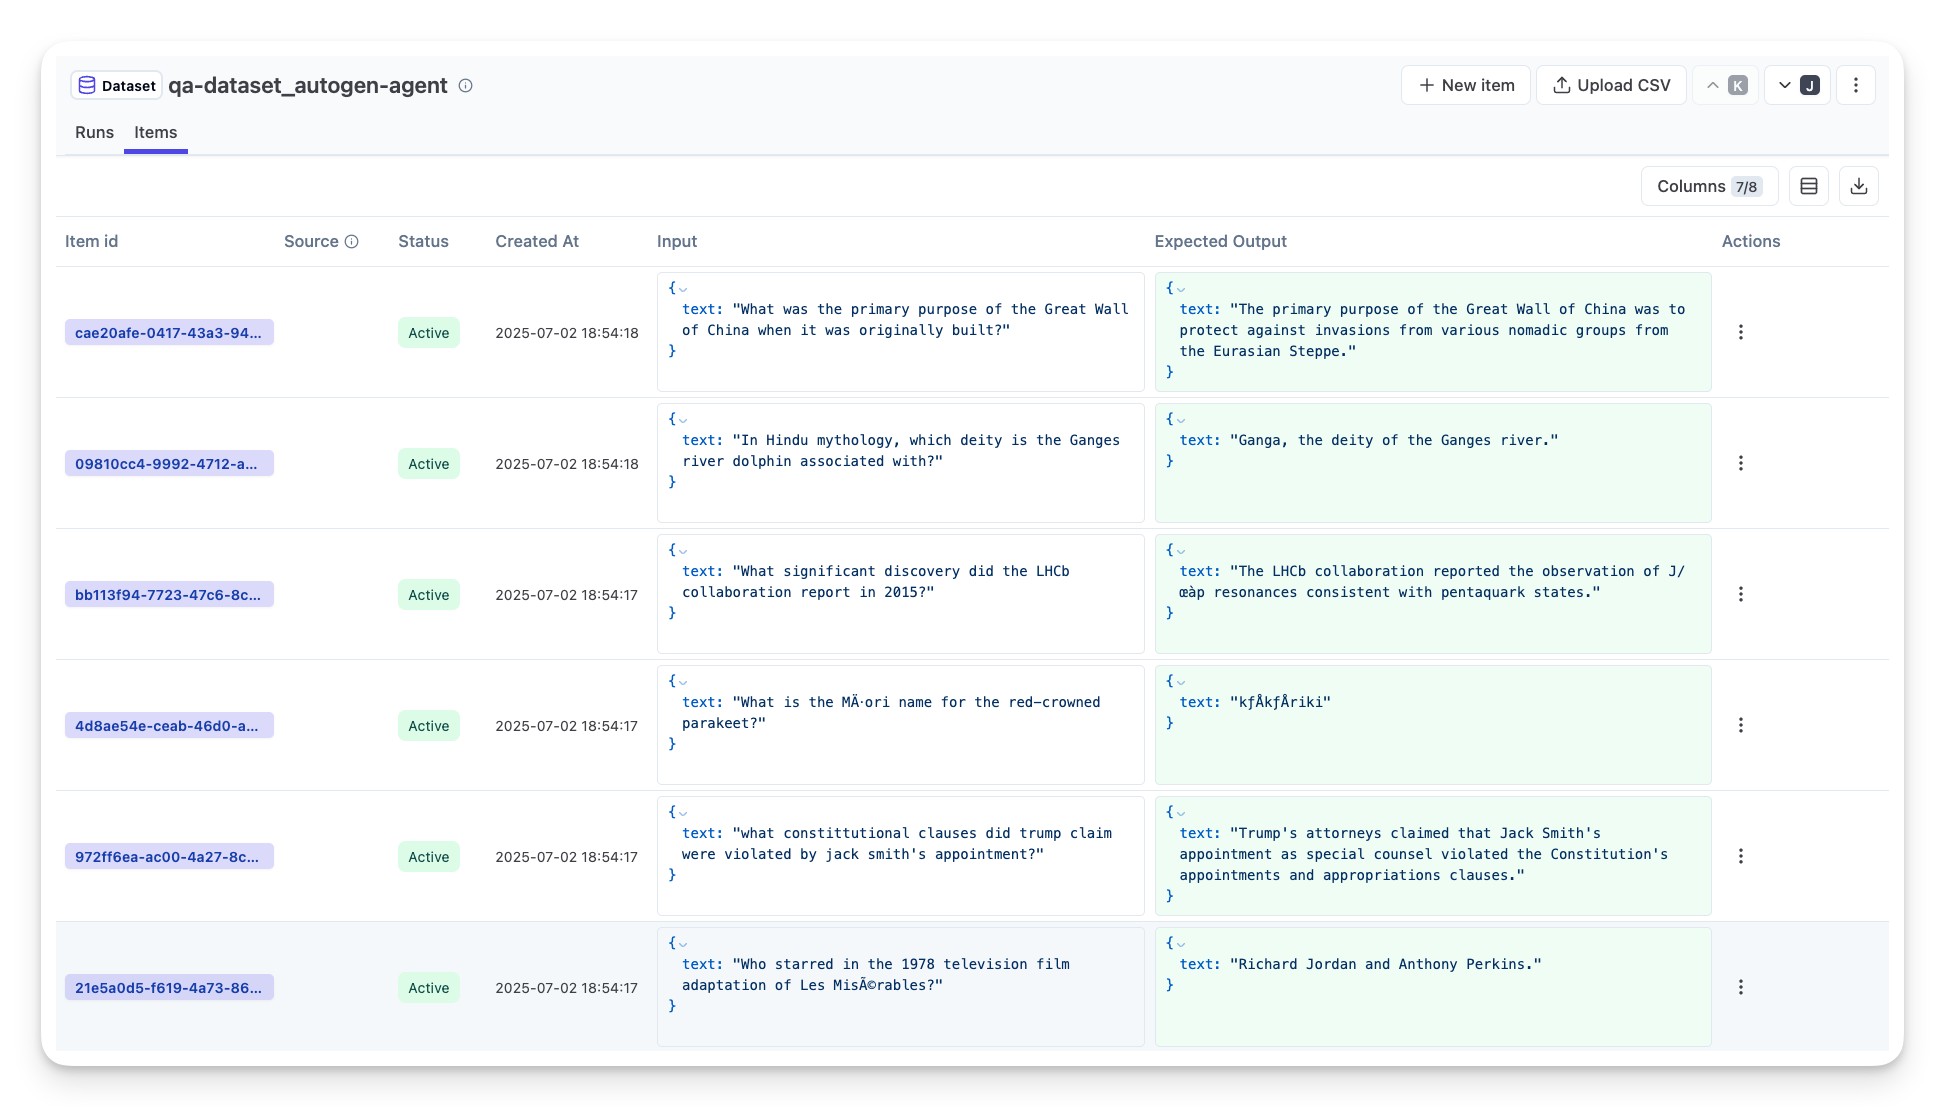
ഇത് നിയന്ത്രിത പരിസരത്ത് ഏജന്റ് മൂല്യനിർണയം നടത്തുന്നതാണ്, സാധാരണ ടെസ്റ്റ് ഡാറ്റാസെറ്റുകൾ ഉപയോഗിച്ച്, യാന്ത്രിക ഉപയോക്തൃ ചോദ്യം പദങ്ങളിൽ അല്ല. നിങ്ങൾ അറിയുന്ന പ്രതീക്ഷിക്കുന്ന ഫലം അല്ലെങ്കിൽ ശരിയായ പെരുമാറ്റം ഉള്ള ക്യൂറേറ്റഡ് ഡാറ്റാസെറ്റുകൾ ഉപയോഗിച്ച് ആദ്യം ഏജന്റിനെ മാനേജ് ചെയ്യുന്നു.
ഉദാഹരണത്തിന്, നിങ്ങൾക്ക് 100 പ്രശ്നങ്ങളുള്ള ടസ്റ്റ് ഡാറ്റാസെറ്റ് ഉണ്ടായിരിക്കാം എന്നത് ഒറ്റത്തവണ വിശദമായ ഉത്തരങ്ങൾ ശേഖരിച്ചു. ഒഫ്ലൈൻ മൂല്യനിർണയം വികസന ഘട്ടത്തിൽ ചെയ്യപ്പെടുന്നു (CI/CD പൈപ്പ്ലൈനുകളുടെ ഭാഗമായും ), മെച്ചപ്പെടുത്തലുകൾ പരിശോധിക്കാനും, പുനർധാരണകൾ തടയാനും. അതിന്റെ ഗുണം ചികിത്സാപരമായി ഉടമസ്ഥതയുള്ളതും, നിങ്ങൾക്ക് ഉറപ്പുള്ള ശരിയായ മെറ്റ്രിക്കുകളും ലഭ്യമാകുന്നതും ആണ്. ഉപയോക്തൃ ചോദ്യങ്ങൾ നകർത്തി, ആധുനിക ഉത്തരങ്ങളുടെ എതിരായ ഏജന്റ് പ്രതികരണങ്ങൾ പരിശോധിക്കാം അല്ലെങ്കിൽ മുൻപ് പറഞ്ഞ സ്വയം പശ്ചാത്തല മെറ്റ്രിക്കുകൾ ഉപയോഗിക്കാം.
ഓഫ്ലൈൻ ചോദ്യാരൂപണം പ്രശ്നം ആണെങ്കിൽ നിങ്ങളുടെ ടെസ്റ്റ് ഡാറ്റാസെറ്റ് സമഗ്രവും പ്രസക്തവുമാകണമെന്ന് ഉറപ്പാക്കേണ്ടതാണ് – ഏജന്റ് സ്ഥിരമായ ടെസ്റ്റ് സെറ്റിൽ നന്നായി പ്രവർത്തിച്ചാലും, പ്രൊഡക്ഷനിൽ സാധാരണ ചോദ്യങ്ങൾ വളരെ വ്യത്യാസപ്പെട്ടേക്കാം. അതുകൊണ്ട് പുതിയ എജന്റുകളുടെ അപ്ഡേറ്റുകളും യാഥാർത്ഥ്യ സാഹചര്യങ്ങളും താരതമ്യപ്പെടുത്തുന്നതിനായി ടെസ്റ്റ് സെറ്റുകൾ പുതുക്കുന്നത് അഭ്യന്തരമാണ്. ചെറിയ “സ്മോക്ക് ടെസ്റ്റ്” കേസുകൾക്കും വലിയ മൂല്യനിർണയ സെറ്റുകൾക്കും ചേർന്നിണക്കം ഉപയോഗിക്കുക: ചെറിയ സെറ്റുകൾ ദ്രുത പരിശോധനയ്ക്കും, വലിയവ വ്യാപക പ്രകടന മെട്രിക് പരിശോധിക്കും.
ഓൺലൈൻ മൂല്യനിർണയം
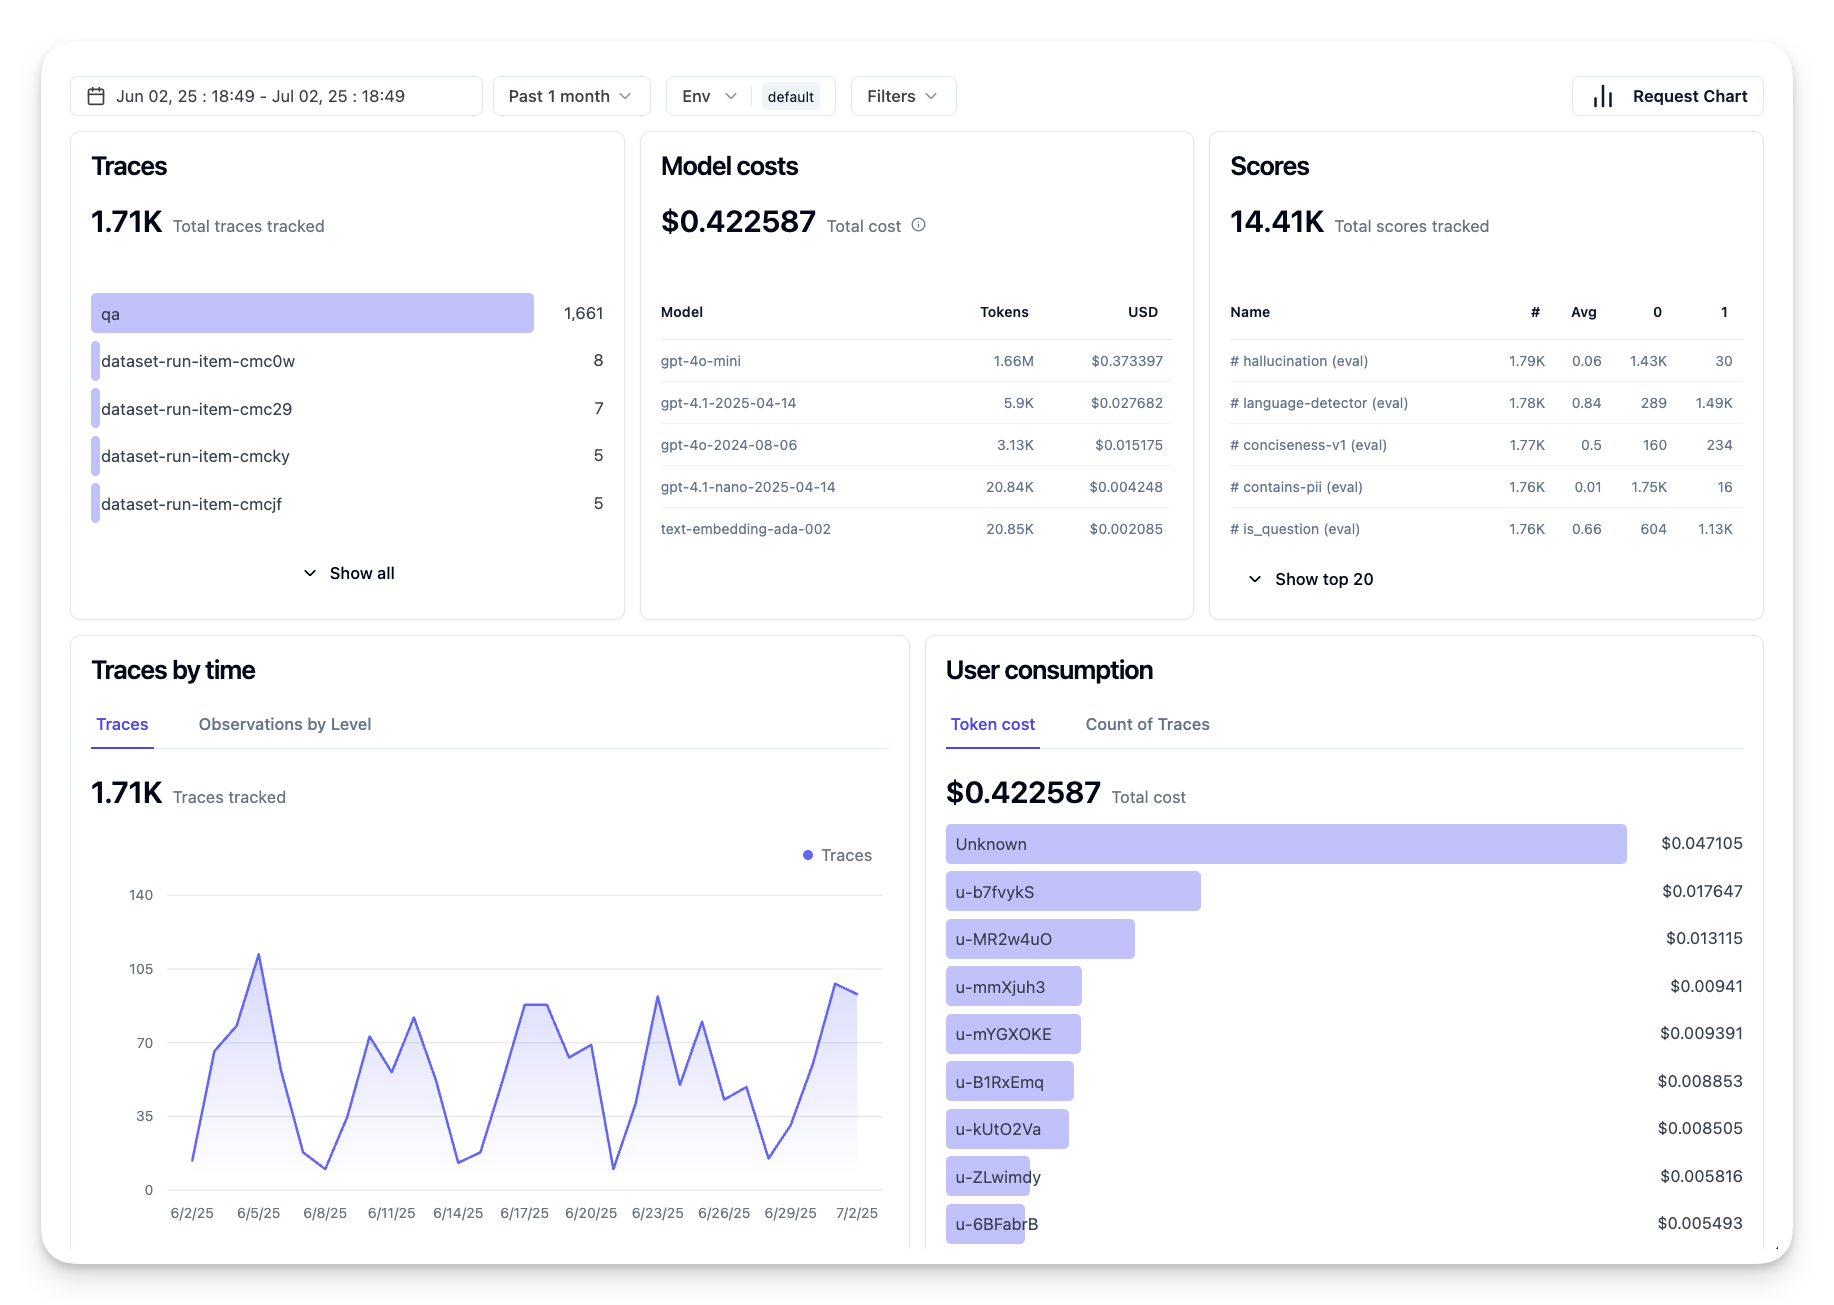
ഇത് യഥാർത്ഥ, സജീവ പരിസ്ഥിതിയിൽ ഏജന്റ് മൂല്യനിർണയം എന്നർത്ഥമാണ്, അഥവാ പ്രൊഡക്ഷനിൽ ഉപയോഗിക്കുമ്പോൾ. ഓൺലൈൻ മൂല്യനിർണയം സജീവ ഉപയോക്തൃ ഇടപെടലുകളിൽ ഏജന്റിന്റെ പ്രകടനം നിരീക്ഷിക്കുകയും തുടർച്ചയായി ഫലങ്ങൾ വിശകലനം ചെയ്യുകയും ചെയ്യുന്നു.
ഉദാഹരണത്തിന്, വിജയ നിരക്കുകൾ, ഉപയോക്തൃ സംതൃപ്തി സ്കോറുകൾ അല്ലെങ്കിൽ മറ്റു മെട്രിക്കുകൾ സജീവ ട്രാഫിക് നിരീക്ഷിച്ച് ട്രാക്ക് ചെയ്യാം. ഓൺലൈൻ മൂല്യനിർണയത്തിന്റെ ഗുണം ലബോറട്ടറി പരിസരത്തിൽ പ്രതീക്ഷിക്കാത്ത കാര്യങ്ങൾ പിടികൂടും എന്നതാണ് - കാലക്രമേണ മോഡൽ ഡ്രിഫ്റ്റ് നിരീക്ഷിക്കാം (പ്രവേശന മാതൃകകൾ മാറുമ്പോൾ) പറ്റാത്ത ചോദ്യങ്ങൾ കണ്ടെത്താനും സാധിക്കും. ഇത് യാഥാർത്ഥ്യത്തിൽ ഏജന്റ് പെരുമാറ്റത്തെ വ്യക്തമായി കാണിക്കുന്നു.
ഓൺലൈൻ മൂല്യനിർണയം അനുപ്രത്യക്ഷവും വ്യക്തവുമായ ഉപയോക്തൃ പ്രതികരണങ്ങൾ സമാഹരിക്കുന്നതും ഉൾപ്പെടാം, കൂടാതെ ഷാഡോ ടെസ്റ്റുകളും A/B ടെസ്റ്റുകളും നടത്താൻ സാധിക്കും (പുത്തൻ പതിപ്പ് പഴയതിൽ താരതമ്യം ചെയ്യാൻ സമാന്തരമായി പ്രവർത്തിക്കുന്നു). പ്രശ്നം ജീവിത ഇടപെടലുകളിൽ വിശ്വസനീയമായ ലേബലുകൾ അല്ലെങ്കിൽ സ്കോറുകൾ ലഭ്യതയ്ക്ക് സങ്കീർണമാണ്; ഉപയോക്തൃ പ്രതികരണങ്ങൾ അല്ലെങ്കിൽ താഴെ സഞ്ചരിക്കുന്ന മെട്രിക്കുകൾ (ഉദാ: ഉപയോക്താവ് ഫലത്തിൽ ക്ലിക്ക് ചെയ്തു) ആശ്രയിക്കാം.
ഇരു വന്നരീതികൾ സംയോജിപ്പിക്കൽ
ഓൺലൈൻ, ഓഫ്ലൈൻ മൂല്യനിർണയങ്ങൾ അന്യോന്യം ഒഴിവാക്കുന്നവയല്ല; അവ പരസ്പരം വളരെ പരിപൂരകങ്ങളാണ്. ഓൺലൈൻ നിരീക്ഷണ洞ലുകളിൽ നിന്നുള്ള洞ലുകൾ (ഉദാ: ഏജന്റ് മോശമായി പ്രകടിപ്പിക്കുന്ന പുതിയ തരം ഉപയോക്തൃ ചോദ്യങ്ങൾ) ഓഫ്ലൈൻ ടെസ്റ്റ് ഡാറ്റാസെറ്റുകൾ മെച്ചപ്പെടുത്താൻ ഉപയോഗിക്കാം. തിരിച്ചുപോവാൻ, ഓഫ്ലൈൻ ടെസ്റ്റുകളിൽ നന്നായി പ്രവർത്തിക്കുന്ന ഏജന്റുകൾ പിന്നീട് ആത്മവിശ്വാസത്തോടെ ഓൺലൈൻ വിന്യസിക്കുകയും നിരീക്ഷിക്കുകയും ചെയ്യാവുന്നതാണ്.
നേര്ന്തിൽ, പല ടീമുകളും ചക്രം പിന്തുടരുന്നു:
ഓഫ്ലൈൻ മൂല്യനിർണയം -> വിന്യസം -> ഓൺലൈൻ നിരീക്ഷണം -> പുതിയ പരാജയ സംഭവങ്ങൾ ശേഖരം -> ഓഫ്ലൈൻ ഡാറ്റാസെറ്റിൽ ചേർക്കുക -> ഏജന്റ് മെച്ചപ്പെടുത്തുക -> ആവർത്തിക്കുക.
സാധാരണ പ്രശ്നങ്ങൾ
AI ഏജന്റുകൾ പ്രൊഡക്ഷൻക്ക് വിന്യസിക്കുമ്പോൾ പല വെല്ലുവിളികളെയും നേരിടേണ്ടിവരും. സാധാരണ പ്രശ്നങ്ങളും അവയുടെ പരിഹാരങ്ങളും ഇവിടെ കൊടുത്തിരിക്കുന്നു:
| പ്രശ്നം | സാദ്ധ്യമായ പരിഹാരം |
|---|---|
| AI ഏജന്റ് തിയ്യതികളിൽ സ്ഥിരത പുലർത്തുന്നില്ല | - AI ഏജന്റിന് നൽകിയ പ്രോംപ്റ്റ് പുനഃപരിശോധിച്ച് ലക്ഷ്യങ്ങൾ വ്യക്തമാക്കുക. - ജോലി സബ്ടാസ്കുകളായി വിഭജിച്ച്, ബഹുഎജന്റ് ഉപയോഗിച്ച് കൈകാര്യം ചെയ്യാം എന്ന് കണ്ടെത്തുക. |
| AI ഏജന്റ് തുടർച്ചയായ ലൂപുകളിൽ നിന്ന് പുറത്തുവരുന്നില്ല | - സംസ്ക്കരണവും നിബന്ധനകളും വ്യക്തമാക്കുക, ഏജന്റ് പ്രക്രിയ 언제 멈 춥 나 എന്ന് അറിയണം. - যুক্তിപരമായ പരിഗണനയും പദ്ധതീകരണമുണ്ടായുള്ള വലിയ മോഡൽ ഉപയോഗിക്കുക. |
| AI ഏജന്റ് ഉപകരണം കോൾ നടത്തുന്നതിൽ പ്രശ്നം | - ഉപകരണം ഫലങ്ങൾ ഏജന്റ് ഉപകരണ സമ്പ്രദായത്തിനു പുറത്തായി പരിശോധിക്കുക. - നിർവ്വചിച്ച പാരാമീറ്ററുകളും പ്രോമ്പ്റ്റുകളുമും ഉപകരണ നാമമെഴുത്തും തിരിച്ചറിയുക. |
| ബഹുഎജന്റ് സിസ്റ്റം സ്ഥിരത പുലർത്തുന്നില്ല | - ഓരോ ഏജന്റും വ്യക്തമായി വ്യത്യസ്തമായിട്ടുള്ളതെന്ന് ഉറപ്പാക്കാൻ പ്രോംപ്റ്റുകൾ പുനഃപരിശോധിക്കുക. - “റൂട്ടിംഗ്” അല്ലെങ്കിൽ കൺട്രോളർ ഏജന്റ് ഉപയോഗിച്ച് വഹിച്ചേരളമായി ഏജന്റ് തിരഞ്ഞെടുത്ത് ഏകേന്ദ്രവത്കരിക്കുക. |
ഈ പ്രശ്നങ്ങളുടെ പലതും അവലോകന സംവിധാനങ്ങൾ ഉപയോഗിച്ച് കൂടുതൽ ഫലപ്രദമായി തിരിച്ചറിയാൻ കഴിയും. മുൻപ് ചർച്ച ചെയ്ത ട്രേസുകളും മെറ്റ്രിക്കുകളും ഏജന്റ് പ്രവർത്തനപ്രവാഹത്തിൽ പ്രശ്നങ്ങൾ ഏതിടത്താണ് ഉണ്ടാവുന്നത് വ്യക്തമാക്കുന്നു, ഡിബഗ്ഗിംഗ് പ്രക്രിയ മെച്ചപ്പെടുത്തുന്നു.
ചെലവ് നിയന്ത്രണം
AI ഏജന്റുകൾ പ്രൊഡക്ഷൻക്ക് വിന്യസിക്കുമ്പോൾ ചെലവുകൾ നിയന്ത്രിക്കാൻ ചില രണനതന്ത്രങ്ങൾ:
ചെറിയ മോഡലുകൾ ഉപയോഗിക്കുന്നത്: ചെറിയ ഭാഷാ മോഡലുകൾ (SLMs) ചില ഏജന്റ് ഉപയോഗ കേസുകളിൽ മികച്ച പ്രകടനം കാണിക്കാം, കൂടാതെ ചിലവുകളും ഗണ്യമായി കുറയ്ക്കും. മുമ്പും പറഞ്ഞതുപോലെ, വലിയ മോഡലുകളെ അപേക്ഷിച്ച് പ്രകടനം തിരിച്ചറിയാനും താരതമ്യം ചെയ്യാനുമുള്ള ഒരു വിലയിരുത്തൽ സംവിധാനം നിർമ്മിക്കുക നിങ്ങളുടെ ഉപയോഗ കേസിൽ SLM എത്രത്തോളം നല്ലത് ആണ് എന്ന് മനസ്സിലാക്കാനുള്ള ഏറ്റവും നല്ല മാർഗമാണ്. ഉദ്ദേശ്യം തിരിച്ചറിയൽ അല്ലെങ്കിൽ പരാമീറ്റർ എക്സ്ട്രാക്ഷൻ പോലുള്ള ലളിതമായ ജോലി ചെയ്തുകൊണ്ടിരിക്കുമ്പോൾ SLMs ഉപയോഗിക്കാനായി പരിഗണിക്കുക, അതേസമയം കൂടുതൽ ഗോത്രമായ നിബന്ധനകൾക്കായി വലിയ മോഡലുകൾ സംരക്ഷിക്കുക.
റൂട്ടർ മോഡൽ ഉപയോഗിക്കൽ: സമാനമായ ഒരു തന്ത്രം വിവിധ മോഡലുകളും വലുപ്പങ്ങളും ഉപയോഗിക്കുന്നതാണ്. നിങ്ങളുടെ അഭ്യർത്ഥനകളെ സങ്കീർണ്ണതയുടെ അടിസ്ഥാനത്തിൽ ഏറ്റവും അനുയോജ്യമായ മോഡലുകളിലേക്ക് റൂട്ട് ചെയ്യാൻ LLM/SLM അല്ലെങ്കിൽ സെർവർലസ്സ് ഫങ്ഷൻ ഉപയോഗിക്കാം. ഇത് ചിലവുകൾ കുറയ്ക്കാൻ സഹായിക്കും കൂടാതെ ശരിയായ ജോലികളിൽ മികച്ച പ്രകടനം ഉറപ്പാക്കും. ഉദാഹരണത്തിന്, ലളിതമായ ചോദ്യങ്ങൾ ചെറുതും വേഗമുള്ള മോഡലുകളിലേക്ക് റൂട്ട് ചെയ്യുക, എന്നാൽ സങ്കീർണമായ ചിന്താ ജോലികൾക്കായി മാത്രം ചെലവേറിയ വലിയ മോഡലുകൾ ഉപയോഗിക്കുക.
പ്രതികരണങ്ങൾ ക്യാഷിങ് ചെയ്യൽ: സാധാരണ അഭ്യർത്ഥനകളും ജോലികളും തിരിച്ചറിയുകയും അവ വഴി ഏജന്റ് സിസ്റ്റത്തിലേക്ക് പോകുന്നതിന് മുൻപ് ഉത്തരങ്ങൾ നൽകുകയും ചെയ്യുന്നതിലൂടെ സമാന അഭ്യർത്ഥനകളുടെ പരിമാണം കുറയ്ക്കാം. ക്യാഷിൽ ചെയ്ത അഭ്യർത്ഥനകളോട് ഒരു അഭ്യർത്ഥനം എത്രത്തോളം സാമ്യമുള്ളതാണ് എന്ന് തിരിച്ചറിയാൻ ലളിതമായ AI മോഡലുകൾ ഉപയോഗിച്ച് ഒരു ഫ്ലോ നടപ്പിലാക്കാം. പലതവണ ചോദിക്കുന്ന ചോദ്യങ്ങൾക്ക് അല്ലെങ്കിൽ സാധാരണ പ്രവൃത്തി രീതി സംബന്ധിച്ചുള്ള കാര്യങ്ങൾക്ക് ഈ തന്ത്രം ചിലവുകൾ ഗണ്യമായി കുറക്കാനാകും.
പ്രായോഗികമായി ഇത് എങ്ങനെ പ്രവർത്തിക്കുന്നു നോക്കാം
ഈ വിഭാഗത്തിന്റെ ഉദാഹരണ നോട്ട്ബുക്ക് ൽ, നാം എങ്ങനെ നിരീക്ഷണ ഉപകരണങ്ങൾ ഉപയോഗിച്ച് നമ്മുടെ ഏജന്റിനെ നിരീക്ഷിക്കുകയും വിലയിരുത്തുകയും ചെയ്യാമെന്ന ഉദാഹരണങ്ങൾ കാണാം.
പ്രൊഡക്ഷനിലെ AI ഏജന്റുകൾക്കുറിച്ച് കൂടുതൽ ചോദിക്കാൻ എന്തെങ്കിലും ഉണ്ടോ?
മറ്റുള്ള പഠനാർത്ഥികളുമായി കൂടിക്കാഴ്ച നടത്താനും ഓഫീസ്സ് സമയങ്ങളിൽ പങ്കെടുക്കാനും നിങ്ങളുടെ AI ഏജന്റ് ചോദ്യങ്ങൾക്ക് മറുപടി ലഭിക്കാനുമായി Microsoft Foundry Discord ലിയോൾക്കുക.
മുൻപത്തെ പാഠം
അടുത്ത പാഠം
അറിയിപ്പ്: ഈ രേഖ AI പരിഭാഷാ സേവനം Co-op Translator ഉപയോഗിച്ച് പരിഭാഷപ്പെടുത്തിയതാണ്. ഞങ്ങൾ കൃത്യതയ്ക്കായി ശ്രമിക്കുന്നുവെങ്കിലും, ഓട്ടോമേറ്റഡ് പരിഭാഷകളിൽ പിഴവുകൾ അല്ലെങ്കിൽ തെറ്റായ വിവരങ്ങൾ ഉണ്ടാകാൻ സാധ്യതയുണ്ട്. അതിന്റെ സ്വാഭാവിക ഭാഷയിലുള്ള അസൽ രേഖയാണ് പ്രാമാണികമായ ഉറവിടമായി പരിഗണിക്കേണ്ടത്. നിർണായകമായ വിവരങ്ങൾക്ക്, പ്രൊഫഷണൽ മനുഷ്യ പരിഭാഷ ശുപാർശ ചെയ്യുന്നു. ഈ പരിഭാഷ ഉപയോഗിച്ച് ഉണ്ടാകുന്ന തെറ്റിദ്ധാരണകൾ അല്ലെങ്കിൽ തെറ്റായ വ്യാഖ്യാനങ്ങൾക്കായി ഞങ്ങൾ ഉത്തരവാദികളല്ല.