ai-agents-for-beginners
उत्पादनातील AI एजंट्स: निरीक्षण आणि मूल्यमापन
जेव्हा AI एजंट प्रयोगात्मक प्रोटोटाइप्समधून वास्तविक जगातील अनुप्रयोगांमध्ये जातात, तेव्हा त्यांचा व्यवहार समजून घेणे, त्यांचा कार्यप्रदर्शन निरीक्षण करणे आणि त्यांच्या आउटपुटचे प्रणालीबद्ध मूल्यांकन करणे महत्वाचे होते.
शिकण्याची उद्दिष्टे
या धड्याचा पूर्ण केल्यानंतर, तुम्हाला पुढील गोष्टी कळतील/समजतील:
- एजंट निरीक्षण आणि मूल्यमापन या मुख्य संकल्पना
- एजंट्सच्या कार्यप्रदर्शन, खर्च आणि कार्यक्षमता सुधारण्यासाठी तंत्रे
- तुमचे AI एजंट्स प्रणालीबद्धपणे कसे आणि काय मूल्यमापन करायचे
- उत्पादनात AI एजंट तैनात करताना खर्च कसा नियंत्रणात ठेवायचा
- Microsoft Agent Framework वापरून तयार केलेल्या एजंट्ससाठी कसे उपकरणे जोडायची
उद्दिष्ट म्हणजे तुम्हाला “ब्लॅक बॉक्स” एजंट्सना पारदर्शक, व्यवस्थापनीय आणि विश्वासार्ह प्रणालींमध्ये रूपांतरित करण्याचे ज्ञान देणे.
टीप: सुरक्षित आणि विश्वासार्ह AI एजंट्स तैनात करणे महत्त्वाचे आहे. Building Trustworthy AI Agents धडा देखील पाहा.
ट्रेसेस आणि स्पॅन्स
निरीक्षण साधने जसे Langfuse किंवा Microsoft Foundry सामान्यतः एजंट रनना ट्रेसेस आणि स्पॅन्स म्हणून सादर करतात.
- ट्रेस एक पूर्ण एजंट कार्य सुरूवातीपासून शेवटपर्यंत दर्शवितो (उदा. वापरकर्त्याचा प्रश्न हाताळणे).
- स्पॅन्स ट्रेसमधील वैयक्तिक टप्पे आहेत (उदा. भाषा मॉडेल कॉल करणे किंवा डेटा मिळवणे).
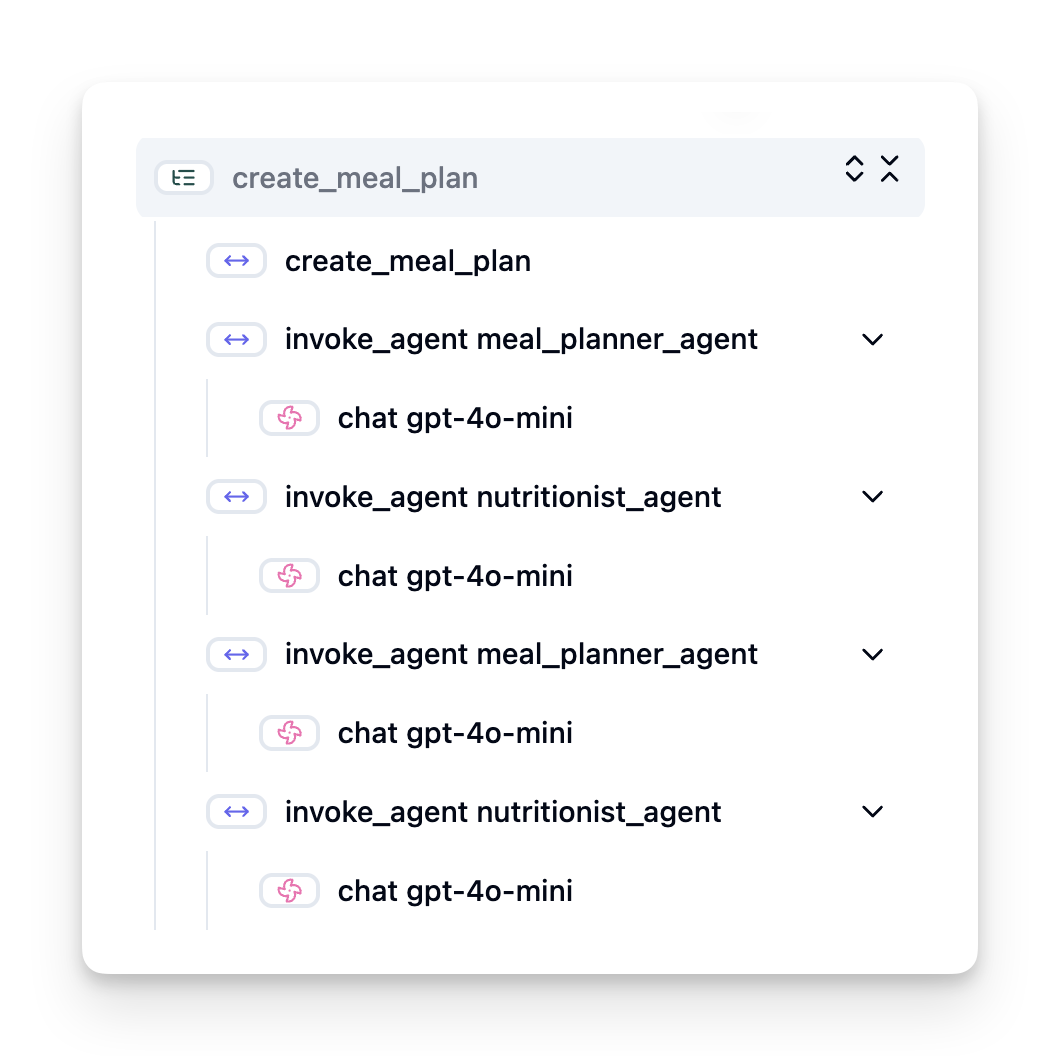
निरीक्षणाशिवाय, AI एजंट “ब्लॅक बॉक्स” सारखा वाटू शकतो - त्याचा अंतर्गत स्थिती आणि विचार प्रक्रिया अस्पष्ट असते, ज्यामुळे समस्या ओळखणे किंवा कार्यप्रदर्शन सुधारण्यासाठी कठीण होते. निरीक्षणासह, एजंट “ग्लास बॉक्स” बनतात, जे पारदर्शकता प्रदान करतात जी विश्वास निर्माण करण्यासाठी आणि ते अपेक्षितप्रमाणे कार्य करतील याची हमी देण्यासाठी आवश्यक आहे.
उत्पादन वातावरणात निरीक्षण का महत्त्वाचे आहे
AI एजंट्सना उत्पादनाच्या पर्यावरणात हलवताना नवीन आव्हाने आणि गरजा उद्भवतात. निरीक्षण आता फक्त “अच्छा आहे” अशी गोष्ट नाही, तर एक महत्त्वाची क्षमता आहे:
- डिबगिंग आणि मूळ कारण विश्लेषण: जेव्हा एजंट अयशस्वी होतो किंवा अनपेक्षित आउटपुट निर्माण करतो, तेव्हा निरीक्षण साधने त्या त्रुटीच्या मूळ कारणाची पुढे जाणारी ट्रेस पुरवतात. हे विशेषतः जटिल एजंट्समध्ये महत्त्वाचे आहे जे बहुतेक LLM कॉल्स, टूल इंटरअॅक्शन्स आणि सशर्त तर्क यांचा समावेश असू शकतो.
- विलंब आणि खर्च व्यवस्थापन: AI एजंट अनेकदा LLMs आणि इतर बाह्य API वर अवलंबून असतात, जे प्रत्येक टोकन किंवा कॉलवर बिल केले जातात. निरीक्षणाने ह्या कॉल्सचे अचूक निरीक्षण शक्य होते, ज्यामुळे अत्यंत मंदगती किंवा महागड्या ऑपरेशन्स ओळखता येतात. हे टीमला प्रॉम्प्ट्स ऑप्टिमाइझ करण्यास, अधिक कार्यक्षम मॉडेल निवडण्यास किंवा कार्यप्रवाहांची रचना सुधारण्यास मदत करते, ज्यामुळे कार्यकारी खर्च नियंत्रणात राहतो आणि चांगला वापरकर्ता अनुभव सुनिश्चित होतो.
- विश्वास, सुरक्षा आणि अनुपालन: अनेक अनुप्रयोगांमध्ये, एजंट सुरक्षित आणि नैतिक वागतात याची खात्री करणे महत्त्वाचे आहे. निरीक्षण एजंट क्रिया आणि निर्णयांचा ऑडिट ट्रेल पुरवते. हे प्रॉम्प्ट इंजेक्शन, हानिकारक सामग्री निर्मिती, किंवा वैयक्तिक ओळखपत्र माहिती (PII) च्या गैरवापरासारख्या समस्यांचा शोध घेण्यासाठी आणि प्रतिबंध करण्यासाठी वापरले जाऊ शकते. उदाहरणार्थ, तुम्ही ट्रेसेस पुनरावलोकन करू शकता ज्यामुळे तुम्हाला समजेल की एखाद्या एजंटने विशिष्ट प्रतिसाद का दिला किंवा विशिष्ट टूल का वापरले.
- सतत सुधारणा लूप्स: निरीक्षण डेटा हा पुनरावृत्ती विकास प्रक्रियेचा पाया आहे. एजंट वास्तविक जगातील कार्यप्रदर्शन कसे करत आहेत हे पाहून टीम सुधारणा क्षेत्र ओळखू शकतात, मॉडेल्सच्या बारीकसारीक करणार्या माहिती गोळा करू शकतात, आणि बदलांचा परिणाम तपासू शकतात. हे एक प्रतिक्रिया लूप तयार करते जिथे ऑनलाइन मूल्यांकनातून उत्पादनातील अंतर्दृष्टी ऑफलाइन प्रयोग आणि शुध्दीकरणासाठी माहिती पुरवते, ज्यामुळे एजंट कार्यप्रदर्शन हळूहळू सुधारते.
ट्रॅक करण्यासाठी प्रमुख मेट्रिक्स
एजंट वर्तन निरीक्षण आणि समजण्यासाठी, विविध मेट्रिक्स आणि सिग्नल्स ट्रॅक केले पाहिजेत. एजंटच्या उद्दिष्टानुसार विशिष्ट मेट्रिक्स वेगळे असू शकतात, पण काही सर्वत्र महत्त्वाचे आहेत.
येथे काही सर्वसाधारण मेट्रिक्स आहेत जे निरीक्षण साधने ट्रॅक करतात:
विलंब (Latency): एजंट किती लवकर प्रतिसाद देतो? दीर्घ प्रतीक्षा वेळा वापरकर्ता अनुभवावर नकारात्मक परिणाम करतात. तुम्ही एजंट रनचे ट्रेसिंग करून कार्ये आणि वैयक्तिक टप्प्यांसाठी विलंब मोजायला हवे. उदाहरणार्थ, जर एजंटसाठी सर्व मॉडेल कॉल्ससाठी 20 सेकंद लागत असतील, तर तुम्ही जलद मॉडेल वापरून किंवा कॉल्स थेट एकाच वेळी चालवून त्याला वेगवान करू शकता.
खर्च (Costs): प्रति एजंट रनचा खर्च काय आहे? AI एजंट LLM कॉल्स किंवा बाह्य API साठी प्रति टोकन बिलिंगवर अवलंबून असतात. वारंवार टूल वापर किंवा अनेक प्रॉम्प्ट्स खर्च लवकर वाढवू शकतात. उदाहरणार्थ, जर एखाद्या एजंटने गुणवत्ता थोडी सुधारण्यासाठी LLM पाच वेळा कॉल केला, तर तुम्हाला पाहावे लागेल की खर्च योग्य आहे का किंवा कॉल्स कमी करू शकता का किंवा स्वस्त मॉडेल वापरू शकता का. रिअल-टाइम मॉनिटरिंगने अनपेक्षित वाढ (उदा. निरंधक API लूप्सने) ओळखण्यास मदत होते.
विनंती त्रुटी (Request Errors): एजंटने किती विनंत्या अयशस्वी केल्या? यात API त्रुटी किंवा निकृष्ट टूल कॉल्स समाविष्ट असू शकतात. उत्पादनात अश्यापासून अधिक रोबस्ट बनवण्यासाठी, नंतर तुम्ही फॉलबॅक किंवा पुनर्प्रयत्न सेट करू शकता. उदा. जर LLM प्रदाता A डाउन असेल तर तुम्ही बॅकअप म्हणून LLM प्रदाता B वापरू शकता.
वापरकर्ता अभिप्राय (User Feedback): थेट वापरकर्ता मूल्यमापन अमलात आणणे महत्त्वाचे आहे. यात स्पष्ट रेटिंग्स (👍थम्ब्स अप/👎थम्ब्स डाउन, ⭐1-5 स्टार) किंवा मजकूर टिप्पण्या समाविष्ट होऊ शकतात. सातत्यपूर्ण नकारात्मक अभिप्राय हे संकेत देतो की एजंट अपेक्षित प्रमाणे काम करत नाही.
गुप्त वापरकर्ता अभिप्राय (Implicit User Feedback): स्पष्ट रेटिंगशिवायही वापरकर्त्यांच्या वर्तनातून अप्रत्यक्ष अभिप्राय मिळतो. यात तत्काळ प्रश्नाची पुनर्रचना, प्रश्नांची पुनरावृत्ती किंवा पुनर्प्रयत्न बटणावर क्लिक करणे यांचा समावेश असू शकतो. उदाहरणार्थ, जर वापरकर्ते वारंवार एकाच प्रश्न विचारत असतील, तर हे सूचित करते की एजंट अपेक्षितप्रमाणे काम करत नाही.
अचूकता (Accuracy): एजंट किती वेळा योग्य किंवा अपेक्षित आउटपुट तयार करतो? अचूकतेची व्याख्या वेगवेगळी असू शकते (उदा. समस्या सोडवण्याची बरोबरी, माहिती शोध अचूकता, वापरकर्ता समाधान). पहिले पाऊल म्हणजे तुमच्या एजंटसाठी यश काय आहे ते निश्चित करणे. तुम्ही स्वयंचलित तपास, मूल्यमापन गुणांक किंवा कार्य पूर्णत्वाच्या लेबलद्वारे अचूकता ट्रॅक करू शकता. उदाहरणार्थ, ट्रेसेसना “यशस्वी” किंवा “अयशस्वी” म्हणून चिह्नित करणे.
स्वयंचलित मूल्यमापन मेट्रिक्स: तुम्ही स्वयंचलित मूल्यमापन देखील सेट करू शकता. उदाहरणार्थ, तुम्ही LLM वापरून एजंटच्या आउटपुटचे गुणांकन करू शकता उदा. तो उपयुक्त आहे का, अचूक आहे का, नाही का. बरेच खुले स्रोत लायब्ररी देखील उपलब्ध आहेत जे एजंटच्या विविध पैलूंचे गुणांकन करतात. उदा. RAG एजंटसाठी RAGAS किंवा हानिकारक भाषा किंवा प्रॉम्प्ट इंजेक्शन ओळखण्यासाठी LLM Guard.
व्यवहारात, या मेट्रिक्सचे संयोजन AI एजंटच्या आरोग्याचा सर्वोत्तम आढावा देते. या धड्यातील उदाहरण नोटबुक मध्ये, आम्ही दाखवू की हे मेट्रिक्स खऱ्या उदाहरणांमध्ये कसे दिसतात पण प्रथम, आम्ही शिकू की सामान्य मूल्यमापन कार्यप्रवाह कसा दिसतो.
तुमच्या एजंटला उपकरणे द्या
ट्रेसिंग डेटा गोळा करण्यासाठी, तुम्हाला तुमच्या कोडमध्ये उपकरणे जोडावी लागतील. उद्दिष्ट म्हणजे एजंटचा कोड असे उपकरण करणे जे ट्रेसेस आणि मेट्रिक्स तयार करेल जे निरीक्षण प्लॅटफॉर्मद्वारे पकडले, प्रक्रिया केले आणि दृश्यात्मक बनवले जाऊ शकतील.
OpenTelemetry (OTel): OpenTelemetry हे LLM निरीक्षणासाठी उद्योगातील मानक म्हणून उदयास आले आहे. हे API, SDK आणि टूल्सचा संच प्रदान करते ज्याद्वारे टेलिमेट्री डेटा जनरेट, गोळा आणि निर्यात करता येतो.
अनेक उपकरण लायब्ररी आहेत ज्या अस्तित्वात असलेल्या एजंट फ्रमवर्कला वेढून ठेवतात आणि OpenTelemetry स्पॅन्स सहज निरीक्षण टूलला निर्यात करतात. Microsoft Agent Framework OpenTelemetry सह नैसर्गिकपणे एकत्रित आहे. खाली MAF एजंटच्या उपकरणीकरणाचे उदाहरण दिले आहे:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
या धड्यातील उदाहरण नोटबुक तुमच्या MAF एजंटला कसे उपकरण द्यायचे हे दाखवेल.
हाथोडे स्पॅन तयार करणे: उपकरण लायब्ररी चांगली बेसलाइन देतात, पण अनेक वेळा अधिक तपशीलवार किंवा सानुकूल माहिती आवश्यक असते. तुम्ही हाताने स्पॅन्स तयार करू शकता जेणेकरून सानुकूल अनुप्रयोग तर्क जोडता येईल. आणखी महत्त्वाचं म्हणजे, ते स्वयंचलित किंवा हाताने तयार केलेल्या स्पॅन्सना सानुकूल वैशिष्ट्यांसह (टॅग किंवा मेटाडेटा म्हणूनही ओळखले जाते) समृद्ध करू शकतात. या वैशिष्ट्यांत व्यवसाय-संबंधित डेटा, मध्यवर्ती गणना किंवा डिबगिंग किंवा विश्लेषणासाठी उपयुक्त असलेला कोणताही संदर्भ समाविष्ट असू शकतो, जसे user_id, session_id, किंवा model_version.
Langfuse Python SDK सह हाती ट्रेसेस आणि स्पॅन्स तयार करण्याचे उदाहरण:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
एजंट मूल्यमापन
निरीक्षण आपल्याला मेट्रिक्स देते, पण मूल्यमापन हा तो डेटा विश्लेषित करण्याची (आणि चाचण्या करण्याची) प्रक्रिया आहे ज्याद्वारे ठरवले जाते की AI एजंट किती चांगले काम करत आहे आणि कसे सुधारता येईल. दुसऱ्या शब्दांत, एकदा तुमच्याकडे ट्रेसेस आणि मेट्रिक्स आली की, तुम्ही ते एजंटचे मूल्यमापन करण्यासाठी आणि निर्णय घेण्यासाठी कसे वापराल?
नियमित मूल्यमापन महत्त्वाचे आहे कारण AI एजंट बर्याचदा अनियंत्रीत असतात आणि विकसित होऊ शकतात (अपडेट किंवा मॉडेल वर्तनातील घसर यामुळे) – मूल्यमापनाशिवाय, तुम्हाला माहितच नसते की तुमचा “स्मार्ट एजंट” खरंच काम करत आहे का किंवा तो मागे गेला आहे का.
AI एजंटसाठी दोन मूल्यमापन प्रकार आहेत: ऑनलाइन मूल्यमापन आणि ऑफलाइन मूल्यमापन. दोन्ही मौल्यवान आहेत आणि एकमेकांना पूरक आहेत. आपण सामान्यतः ऑफलाइन मूल्यमापनाने सुरुवात करतो, कारण हे कोणत्याही एजंटला तैनात करण्याआधी आवश्यक किमान पाऊल आहे.
ऑफलाइन मूल्यमापन
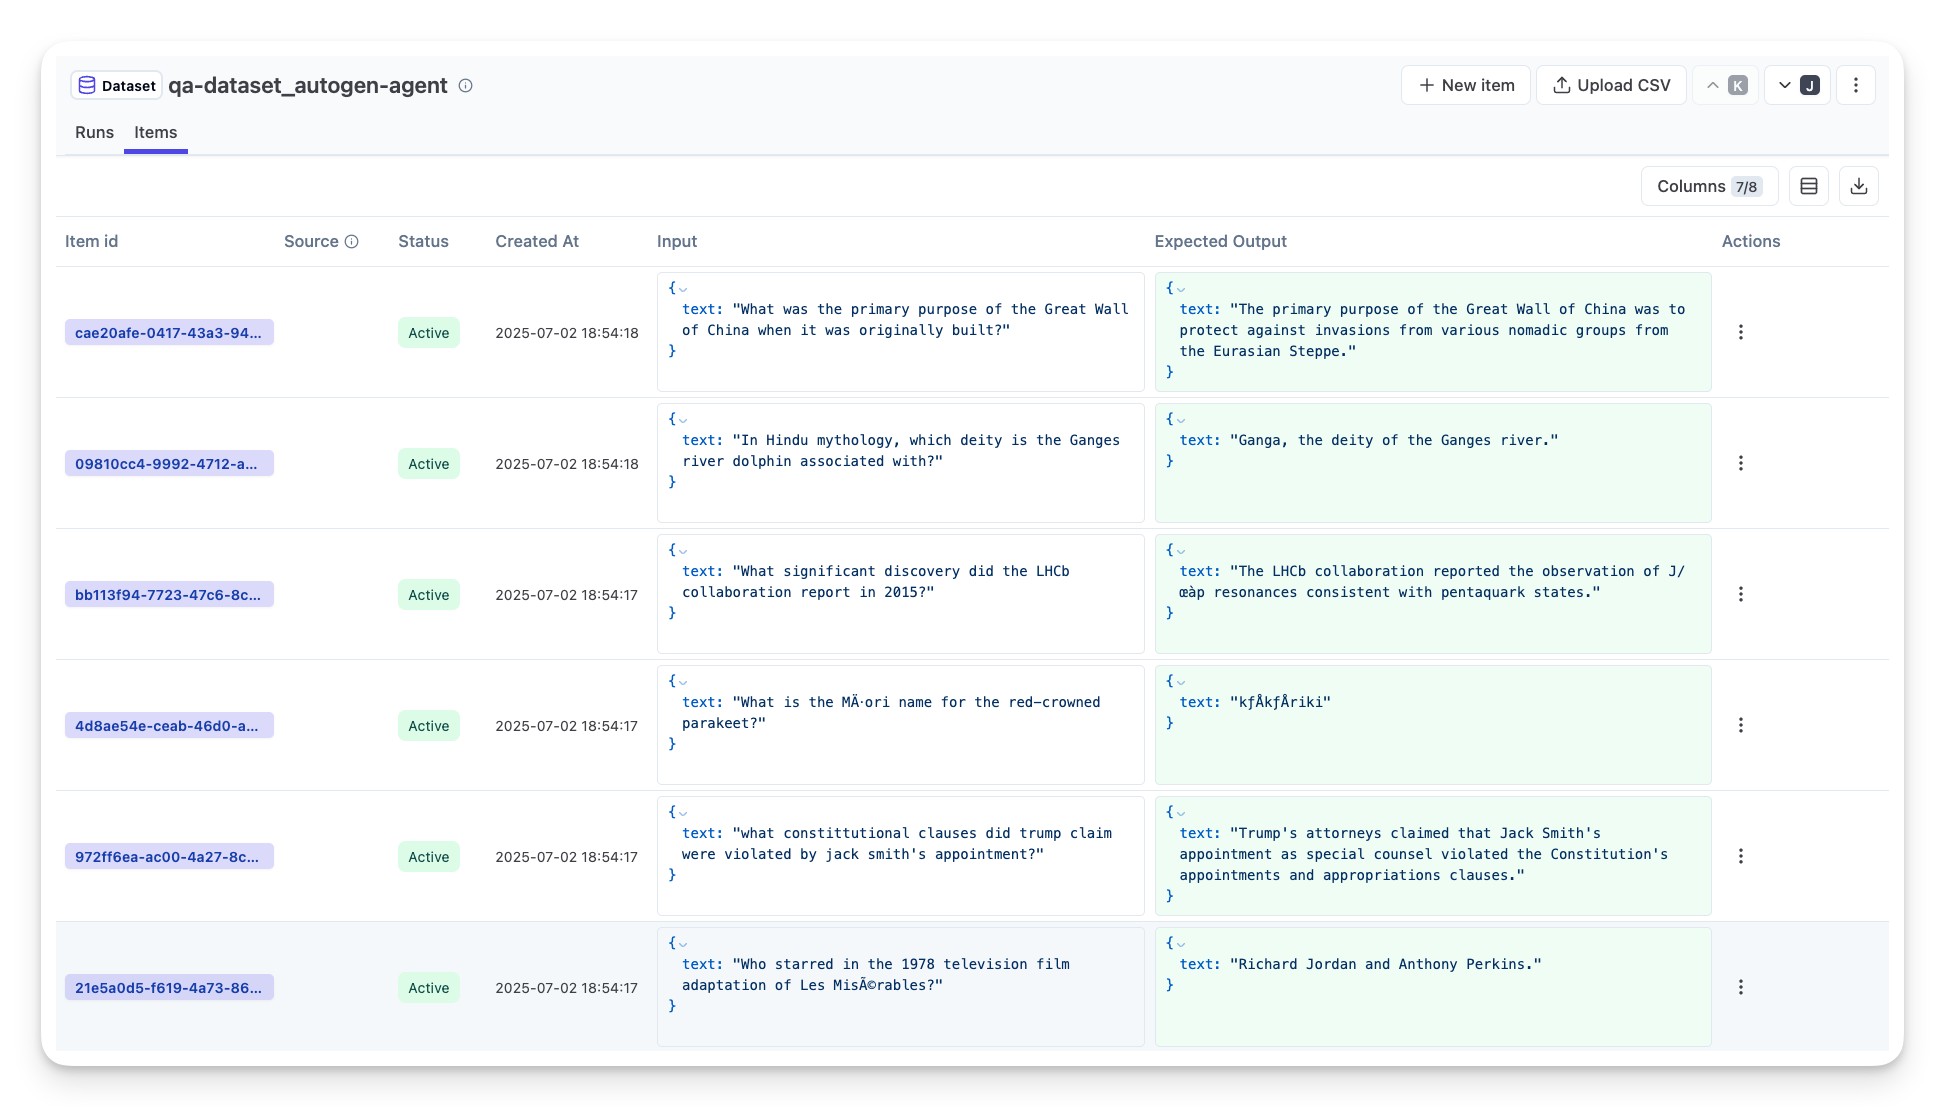
यात एजंटला नियंत्रित वातावरणात मूल्यमापन करणे समाविष्ट आहे, सामान्यतः चाचणी डेटासेट वापरून, थेट वापरकर्ता प्रश्नांचा वापर न करता. तुम्ही नियोजित डेटासेट वापरता जिथे अपेक्षित आउटपुट किंवा योग्य वर्तन माहित असते, आणि नंतर एजंट त्या डेटासेटवर चालवता.
उदाहरणार्थ, जर तुम्ही गणित शब्द-समस्या एजंट तयार केला असेल, तर तुमच्याकडे उत्तर माहित असलेल्या 100 समस्यांचा चाचणी डेटासेट असू शकतो. ऑफलाइन मूल्यमापन विकासादरम्यान (आणि CI/CD पाइपलाइनचा भाग म्हणून) केले जाते सुधारणांची तपासणी करण्यासाठी किंवा मागे गेलेले आढळून टाळण्यासाठी. फायदा असा की हा प्रक्रिया पुन्हा करता येण्यासारखी आहे आणि स्पष्ट अचूकता मेट्रिक्स मिळू शकतात कारण तुम्हाला खरी माहिती माहिती आहे. तुम्ही वापरकर्ता प्रश्नांची नक्कल करू शकता आणि एजंटचे प्रतिसाद आदर्श उत्तरांसोबत मोजू शकता किंवा वरीलप्रमाणे स्वयंचलित मेट्रिक्स वापरू शकता.
ऑफलाइन मूल्यांकनासाठी मुख्य आव्हान म्हणजे चाचणी डेटासेट व्यापक आणि संबंधित राहणे सुनिश्चित करणे – एजंट निश्चित चाचणी संचावर चांगले काम करू शकतो पण उत्पादनात खूप वेगळे प्रश्न येऊ शकतात. त्यामुळे तुम्ही नवीन टोकाशी संबंधित प्रकरणे आणि वास्तविक जगातील उदाहरणांसह चाचणी संच अद्ययावत ठेवायला हवेत. छोट्या “स्मोक टेस्ट” प्रकरणांचा आणि मोठ्या मूल्यांकन संचाचा समतोल उपयुक्त आहे: लवकर तपासासाठी छोटे संच आणि विस्तृत कार्यप्रदर्शन मेट्रिक्ससाठी मोठे संच.
ऑनलाइन मूल्यमापन
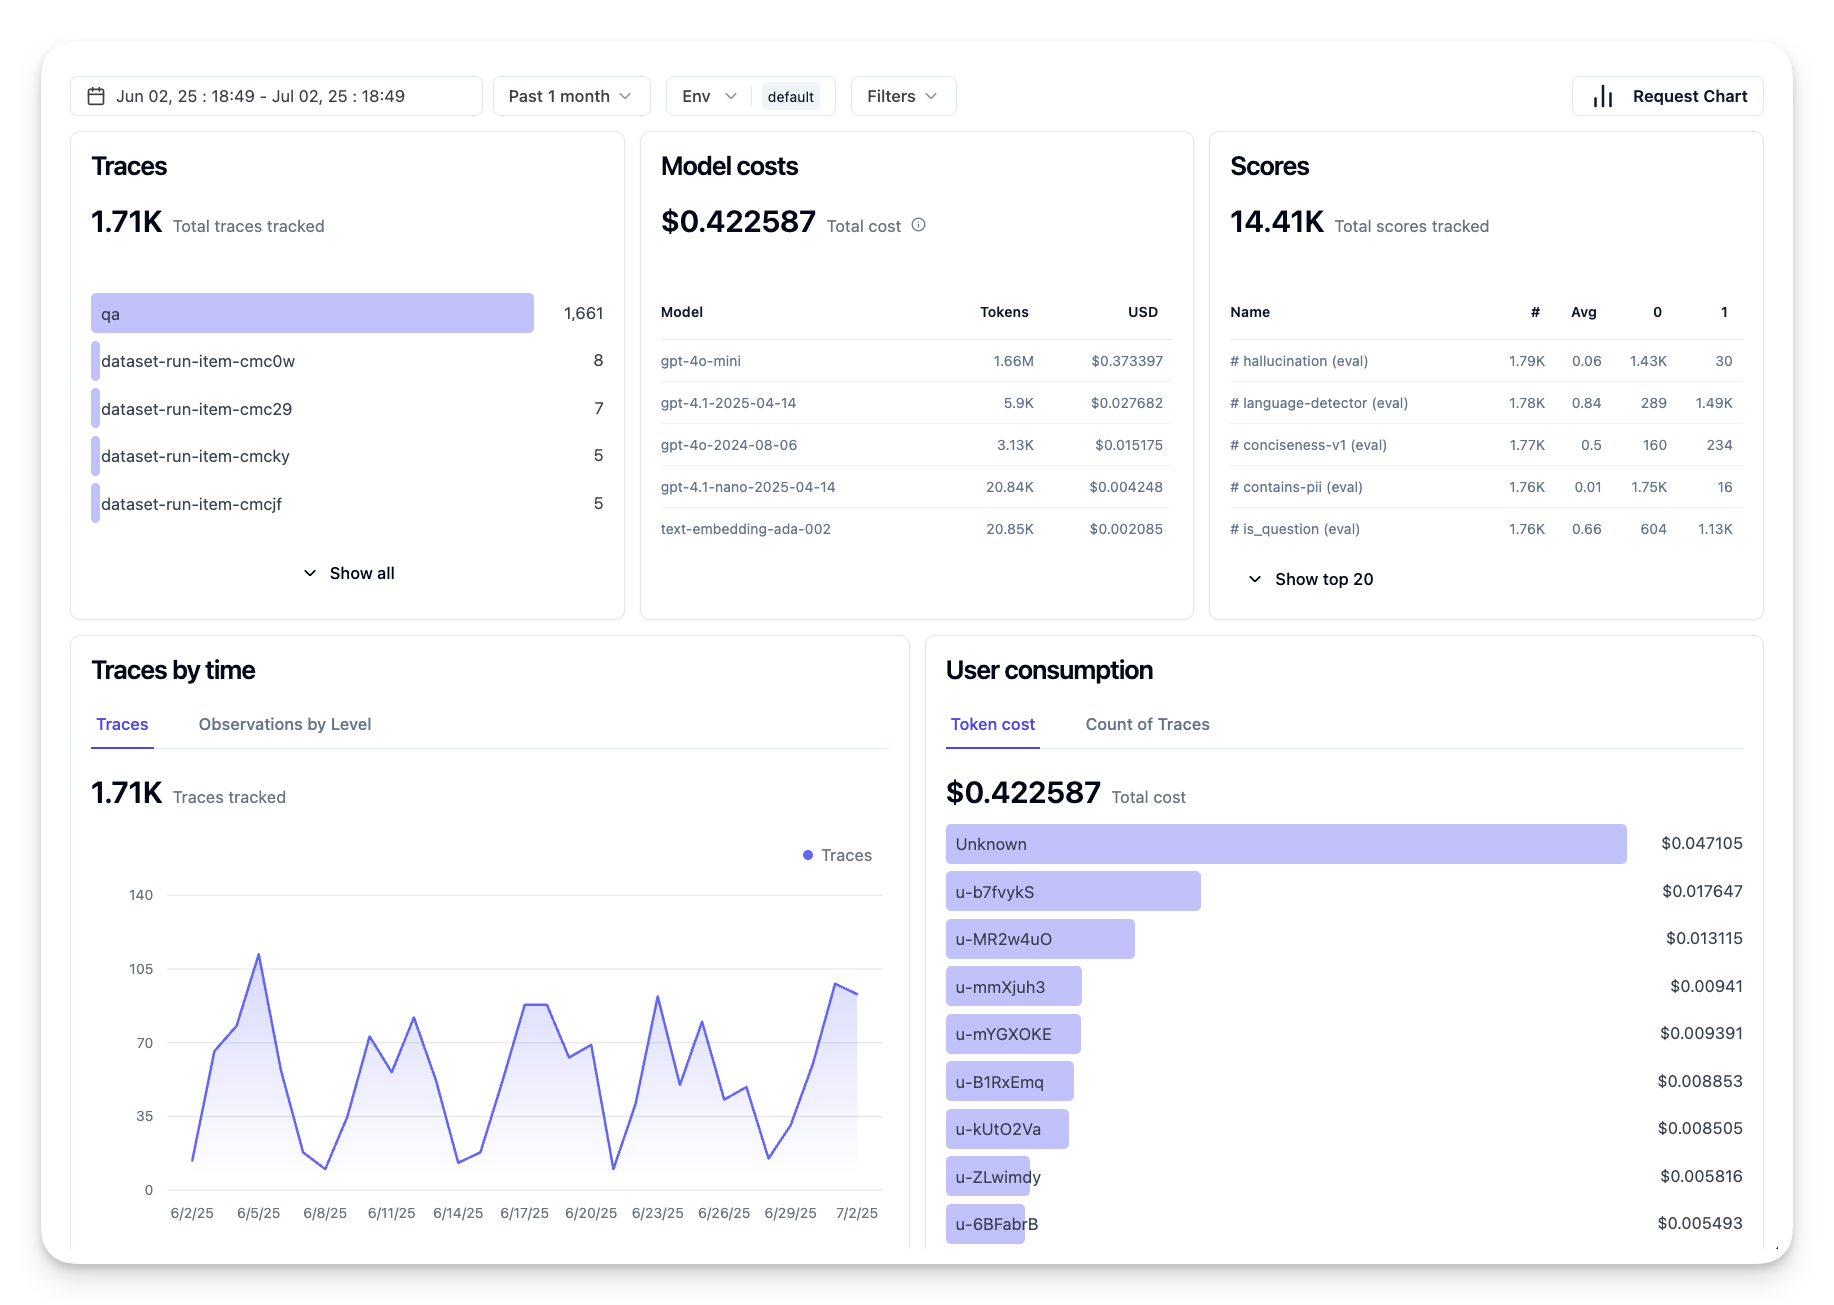
याचा अर्थ एजंटचे मूल्यांकन थेट, वास्तविक जगाच्या वातावरणात करणे, म्हणजे उत्पादनात वास्तविक वापर दरम्यान. ऑनलाइन मूल्यांकन यातून एजंटचे वास्तविक वापरकर्त्यांशी संवादावर कार्यप्रदर्शन सतत निरीक्षण आणि विश्लेषण समाविष्ट आहे.
उदाहरणार्थ, तुम्ही यशस्वी दर, वापरकर्ता समाधान गुणांक किंवा इतर मेट्रिक्स थेट ट्रॅफिकवर ट्रॅक करू शकता. ऑनलाइन मूल्यांकनाचे फायदा असा की हे परीक्षणाच्या प्रयोगशाळेत अपेक्षित नसलेल्या गोष्टी पकडते – तुम्ही वेळोवेळी मॉडेल ड्रिफ्ट पाहू शकता (जर एजंटची कार्यक्षमता इनपुट पॅटर्न्स बद्ल्यामुळे कमी झाली) आणि अनपेक्षित प्रश्न किंवा परिस्थिती देखील पकडू शकता जी तुमच्या चाचणी डेटामध्ये नव्हती. हे तुम्हाला एजंटने वास्तविक जगात कसे वागते ते खरी प्रतिमा देते.
ऑनलाइन मूल्यांकन बहुधा अप्रत्यक्ष आणि स्पष्ट वापरकर्ता अभिप्राय गोळा करते जे वरीलप्रमाणे चर्चिले आहे, आणि कदाचित षडयंत्र चाचण्या किंवा A/B चाचण्या चालवते (जिथे नवीन एजंट आवृत्ती जुनीशी तुलना करण्यासाठी समांतर चालते). आव्हान म्हणजे थेट संवादासाठी विश्वसनीय लेबल किंवा गुणांकन मिळवणे कठीण असू शकते – तुम्ही वापरकर्ता अभिप्राय किंवा खालील मेट्रिक्सवर अवलंबून असू शकता (उदा. वापरकर्त्याने निकालावर क्लिक केला का).
दोन्ही एकत्र करणे
ऑनलाइन आणि ऑफलाइन मूल्यांकन हे एकमेकांना विरोधी नाहीत; ते अत्यंत पूरक आहेत. ऑनलाइन निरीक्षणातून (उदा. नवीन प्रकारचे वापरकर्ता प्रश्न जिथे एजंट खराब काम करतो) प्राप्त झालेली अंतर्दृष्टी ऑफलाइन चाचणी डेटासेट वाढविण्यासाठी आणि सुधारण्यासाठी वापरली जाऊ शकते. उलट, जे एजंट ऑफलाइन चाचण्यांमध्ये चांगले काम करतात ते विश्वासाने ऑनलाइन तैनात आणि निरीक्षण केले जाऊ शकतात.
प्रत्यक्षात, अनेक टीम एक लूप स्वीकारतात:
ऑफलाइन मूल्यांकन -> तैनात करा -> ऑनलाइन निरीक्षण करा -> नवीन अयशस्वी प्रकरणे गोळा करा -> ऑफलाइन डेटासेटमध्ये जोडा -> एजंट सुधारित करा -> पुन्हा करा.
सामान्य समस्या
तुम्ही AI एजंट्स उत्पादनात तैनात करताना विविध आव्हानांना सामोरे जाऊ शकता. येथे काही सामान्य समस्या आणि त्यांचे संभाव्य उपाय दिले आहेत:
| समस्या | संभाव्य उपाय |
|---|---|
| AI एजंट सातत्याने कार्य करत नाही | - AI एजंटला दिलेला प्रॉम्प्ट सुधारा; उद्दिष्टे स्पष्ट करा. - कामे उपकामांमध्ये विभागून त्यांना अनेक एजंट्सने हाताळल्यास फायदेशीर ठरू शकते. |
| AI एजंट सतत लूपमध्ये अडकतो | - एजंटला प्रक्रिया कधी थांबवायची आहे यासाठी स्पष्ट समाप्ती अटी आणि शर्ता द्या. - जटिल कामांसाठी जे तर्क आणि नियोजन मागतात, त्यासाठी युक्तिपूर्ण कार्यासाठी विशिष्ट मोठा मॉडेल वापरा. |
| AI एजंटची टूल कॉल्स चांगल्या प्रकारे काम करत नाहीत | - एजंट सिस्टमच्या बाहेर टूलचे आउटपুট चाचणी करा आणि सत्यापित करा. - टूल्सच्या निर्दिष्ट केलेल्या पॅरामिटर्स, प्रॉम्प्ट्स आणि नावांमध्ये सुधारणा करा. |
| मल्टी-एजंट सिस्टम सातत्याने काम करत नाही | - प्रत्येक एजंटला दिलेल्या प्रॉम्प्ट्सच्या विशिष्टता आणि वेगळेपणाची खात्री करा. - योग्य एजंट ठरविण्यासाठी “राउटिंग” किंवा नियंत्रक एजंट वापरून पदानुक्रमित प्रणाली तयार करा. |
या समस्यांपैकी बरेच निरीक्षणाद्वारे अधिक प्रभावी ओळखता येतात. आम्ही आधी चर्चा केलेले ट्रेसेस आणि मेट्रिक्स एजंट कार्यप्रवाहात नेमके समस्या कुठे आहेत हे शोधण्यास मदत करतात, ज्यामुळे डिबगिंग आणि ऑप्टिमायझेशन अधिक कार्यक्षम होते.
खर्च व्यवस्थापन
AI एजंट्स उत्पादनात तैनात करताना खर्च कसा व्यवस्थापित करायचा यासाठी काही धोरणे:
लहान मॉडेल्स वापरणे: लहान भाषा मॉडेल्स (SLMs) काही एजेंटिक वापराच्या प्रकरणांवर चांगले काम करू शकतात आणि खर्चात लक्षणीय कपात करू शकतात. आधी नमूद केल्याप्रमाणे, एक मूल्यमापन प्रणाली तयार करणे जे कामगिरीची तुलना मोठ्या मॉडेल्सबरोबर करते, हे समजून घेण्याचा उत्तम मार्ग आहे की तुमच्या वापराच्या प्रकरणावर SLM किती चांगले काम करेल. साधे कार्य जसे की उद्दिष्ट वर्गीकरण किंवा परिमाण काढणीसाठी SLMs वापरणे विचारात घ्या, तर जटिल विचार करण्यासाठी मोठ्या मॉडेल्स राखून ठेवा.
राऊटर मॉडेल वापरणे: एकसारखी धोरण म्हणजे मॉडेल्स आणि आकारांच्या विविधतेचा वापर करणे. तुम्ही LLM/SLM किंवा सर्व्हरलेस फंक्शन वापरून जटिलतेनुसार विनंत्या योग्य मॉडेल्सकडे मार्गदर्शित करू शकता. यामुळे खर्च कमी होण्यास मदत होईल तसेच योग्य कामांवर कार्यक्षमता सुनिश्चित होईल. उदाहरणार्थ, सोप्या प्रश्नांना लहान, वेगवान मॉडेल्सकडे मार्गदर्शित करा आणि फक्त जटिल विचारसरणीच्या कार्यांसाठी महागडे मोठे मॉडेल्स वापरा.
प्रतिसाद कॅशिंग: सामान्य विनंत्या आणि कार्ये ओळखणे आणि त्यांना तुमच्या एजेंटिक प्रणालीत जाण्यापूर्वी प्रतिसाद देणे, हे सारख्या विनंत्यांच्या प्रमाणात कपात करण्याचा चांगला मार्ग आहे. तुम्ही अगदी एक प्रवाह देखील अंमलात आणू शकता ज्याद्वारे एक विनंती तुमच्या कॅश केलेल्या विनंत्यांशी किती समान आहे हे अधिक मूलभूत AI मॉडेल्स वापरून ओळखले जाऊ शकते. या धोरणामुळे वारंवार विचारल्या जाणार्या प्रश्नांसाठी किंवा सामान्य कार्यप्रवाहांसाठी खर्चात लक्षणीय कपात होऊ शकते.
चला पाहूया की हे व्यवहारात कसे कार्य करते
या विभागाच्या उदाहरण नोटबुकमध्ये, आपण पाहू की कसे निरीक्षण साधने वापरून आपला एजंट कसे निरीक्षण आणि मूल्यमापन करू शकतो.
उत्पादनातील AI एजंट्सविषयी अधिक प्रश्न आहेत का?
Microsoft Foundry Discord मध्ये सामील व्हा, इतर शिकणाऱ्यांशी भेटा, ऑफिस तासांना उपस्थित रहा आणि तुमचे AI एजंट्सविषयी प्रश्नांची उत्तरे मिळवा.
मागील धडा
पुढील धडा
अस्वीकरण: हा दस्तऐवज AI भाषांतर सेवा Co-op Translator चा वापर करून अनुवादित केला आहे. जरी आम्ही अचूकतेसाठी प्रयत्न करतो, तरी कृपया लक्षात घ्या की स्वयंचलित भाषांतरांमध्ये त्रुटी किंवा अचूकतेची कमतरता असू शकते. मूळ दस्तऐवज त्याच्या मूळ भाषेत अधिकृत स्रोत मानला पाहिजे. महत्त्वाची माहिती असल्यास, व्यावसायिक मानवी भाषांतराची शिफारस केली जाते. या भाषांतराच्या वापरामुळे उद्भवणाऱ्या कोणत्याही गैरसमज किंवा चुकीच्या अर्थलावणीसाठी आम्ही जबाबदार नाही.