ai-agents-for-beginners
Gebruik van Agentic Protocols (MCP, A2A en NLWeb)
(Klik op de bovenstaande afbeelding om de video van deze les te bekijken)
Naarmate het gebruik van AI-agenten toeneemt, groeit ook de behoefte aan protocollen die standaardisatie, beveiliging en open innovatie ondersteunen. In deze les behandelen we 3 protocollen die aan deze behoefte voldoen - Model Context Protocol (MCP), Agent to Agent (A2A) en Natural Language Web (NLWeb).
Introductie
In deze les behandelen we:
• Hoe MCP AI-agenten toegang geeft tot externe tools en data om gebruikersopdrachten uit te voeren.
• Hoe A2A communicatie en samenwerking tussen verschillende AI-agenten mogelijk maakt.
• Hoe NLWeb natuurlijke taalinterfaces aan elke website toevoegt waardoor AI-agenten de inhoud kunnen ontdekken en ermee kunnen interageren.
Leerdoelen
• Identificeer het hoofddoel en de voordelen van MCP, A2A en NLWeb in de context van AI-agenten.
• Leg uit hoe elk protocol communicatie en interactie tussen LLM’s, tools en andere agenten faciliteert.
• Herken de onderscheidende rollen die elk protocol speelt bij het bouwen van complexe agentic-systemen.
Model Context Protocol
Het Model Context Protocol (MCP) is een open standaard die een gestandaardiseerde manier biedt voor applicaties om context en tools aan LLM’s te verstrekken. Dit maakt een “universele adapter” mogelijk voor verschillende databronnen en tools waaraan AI-agenten op een consistente manier kunnen koppelen.
Laten we de componenten van MCP bekijken, de voordelen ten opzichte van directe API-gebruik, en een voorbeeld van hoe AI-agenten een MCP-server zouden kunnen gebruiken.
MCP Kerncomponenten
MCP werkt volgens een client-serverarchitectuur en de kerncomponenten zijn:
• Hosts zijn LLM-applicaties (bijvoorbeeld een code-editor zoals VSCode) die de verbindingen met een MCP-server starten.
• Clients zijn componenten binnen de hostapplicatie die een-een verbindingen met servers onderhouden.
• Servers zijn lichtgewicht programma’s die specifieke mogelijkheden bieden.
In het protocol zitten drie kernprimitieven die de mogelijkheden van een MCP-server vormen:
• Tools: Dit zijn afzonderlijke acties of functies die een AI-agent kan aanroepen om een handeling uit te voeren. Bijvoorbeeld, een weerservice kan een tool “get weather” aanbieden, of een e-commerce server een tool “purchase product”. MCP-servers adverteren de naam, beschrijving en input/output-schema van elke tool in hun mogelijkhedenlijst.
• Resources: Dit zijn lees-only data-items of documenten die een MCP-server kan leveren, en die clients op aanvraag kunnen ophalen. Voorbeelden zijn bestandsinhoud, databankrecords of logbestanden. Resources kunnen tekst zijn (zoals code of JSON) of binair (zoals afbeeldingen of PDF’s).
• Prompts: Dit zijn vooraf gedefinieerde sjablonen die voorgestelde prompts bieden, waardoor complexere workflows mogelijk zijn.
Voordelen van MCP
MCP biedt belangrijke voordelen voor AI-agenten:
• Dynamische Toolontdekking: Agenten kunnen dynamisch een lijst van beschikbare tools van een server ontvangen, inclusief beschrijvingen. Dit in tegenstelling tot traditionele API’s, die vaak statische codering vereisen voor integraties, wat betekent dat elke API-wijziging code-updates vereist. MCP biedt een “eenmalig integreren” aanpak, wat leidt tot meer aanpasbaarheid.
• Interoperabiliteit tussen LLM’s: MCP werkt met verschillende LLM’s, waardoor de flexibiliteit ontstaat om van kernmodel te wisselen voor betere prestaties.
• Gestandaardiseerde Beveiliging: MCP bevat een standaard authenticatiemethode, wat de schaalbaarheid verbetert bij het toevoegen van toegang tot extra MCP-servers. Dit is eenvoudiger dan het beheren van verschillende sleutels en authenticatietypes voor diverse traditionele API’s.
MCP Voorbeeld
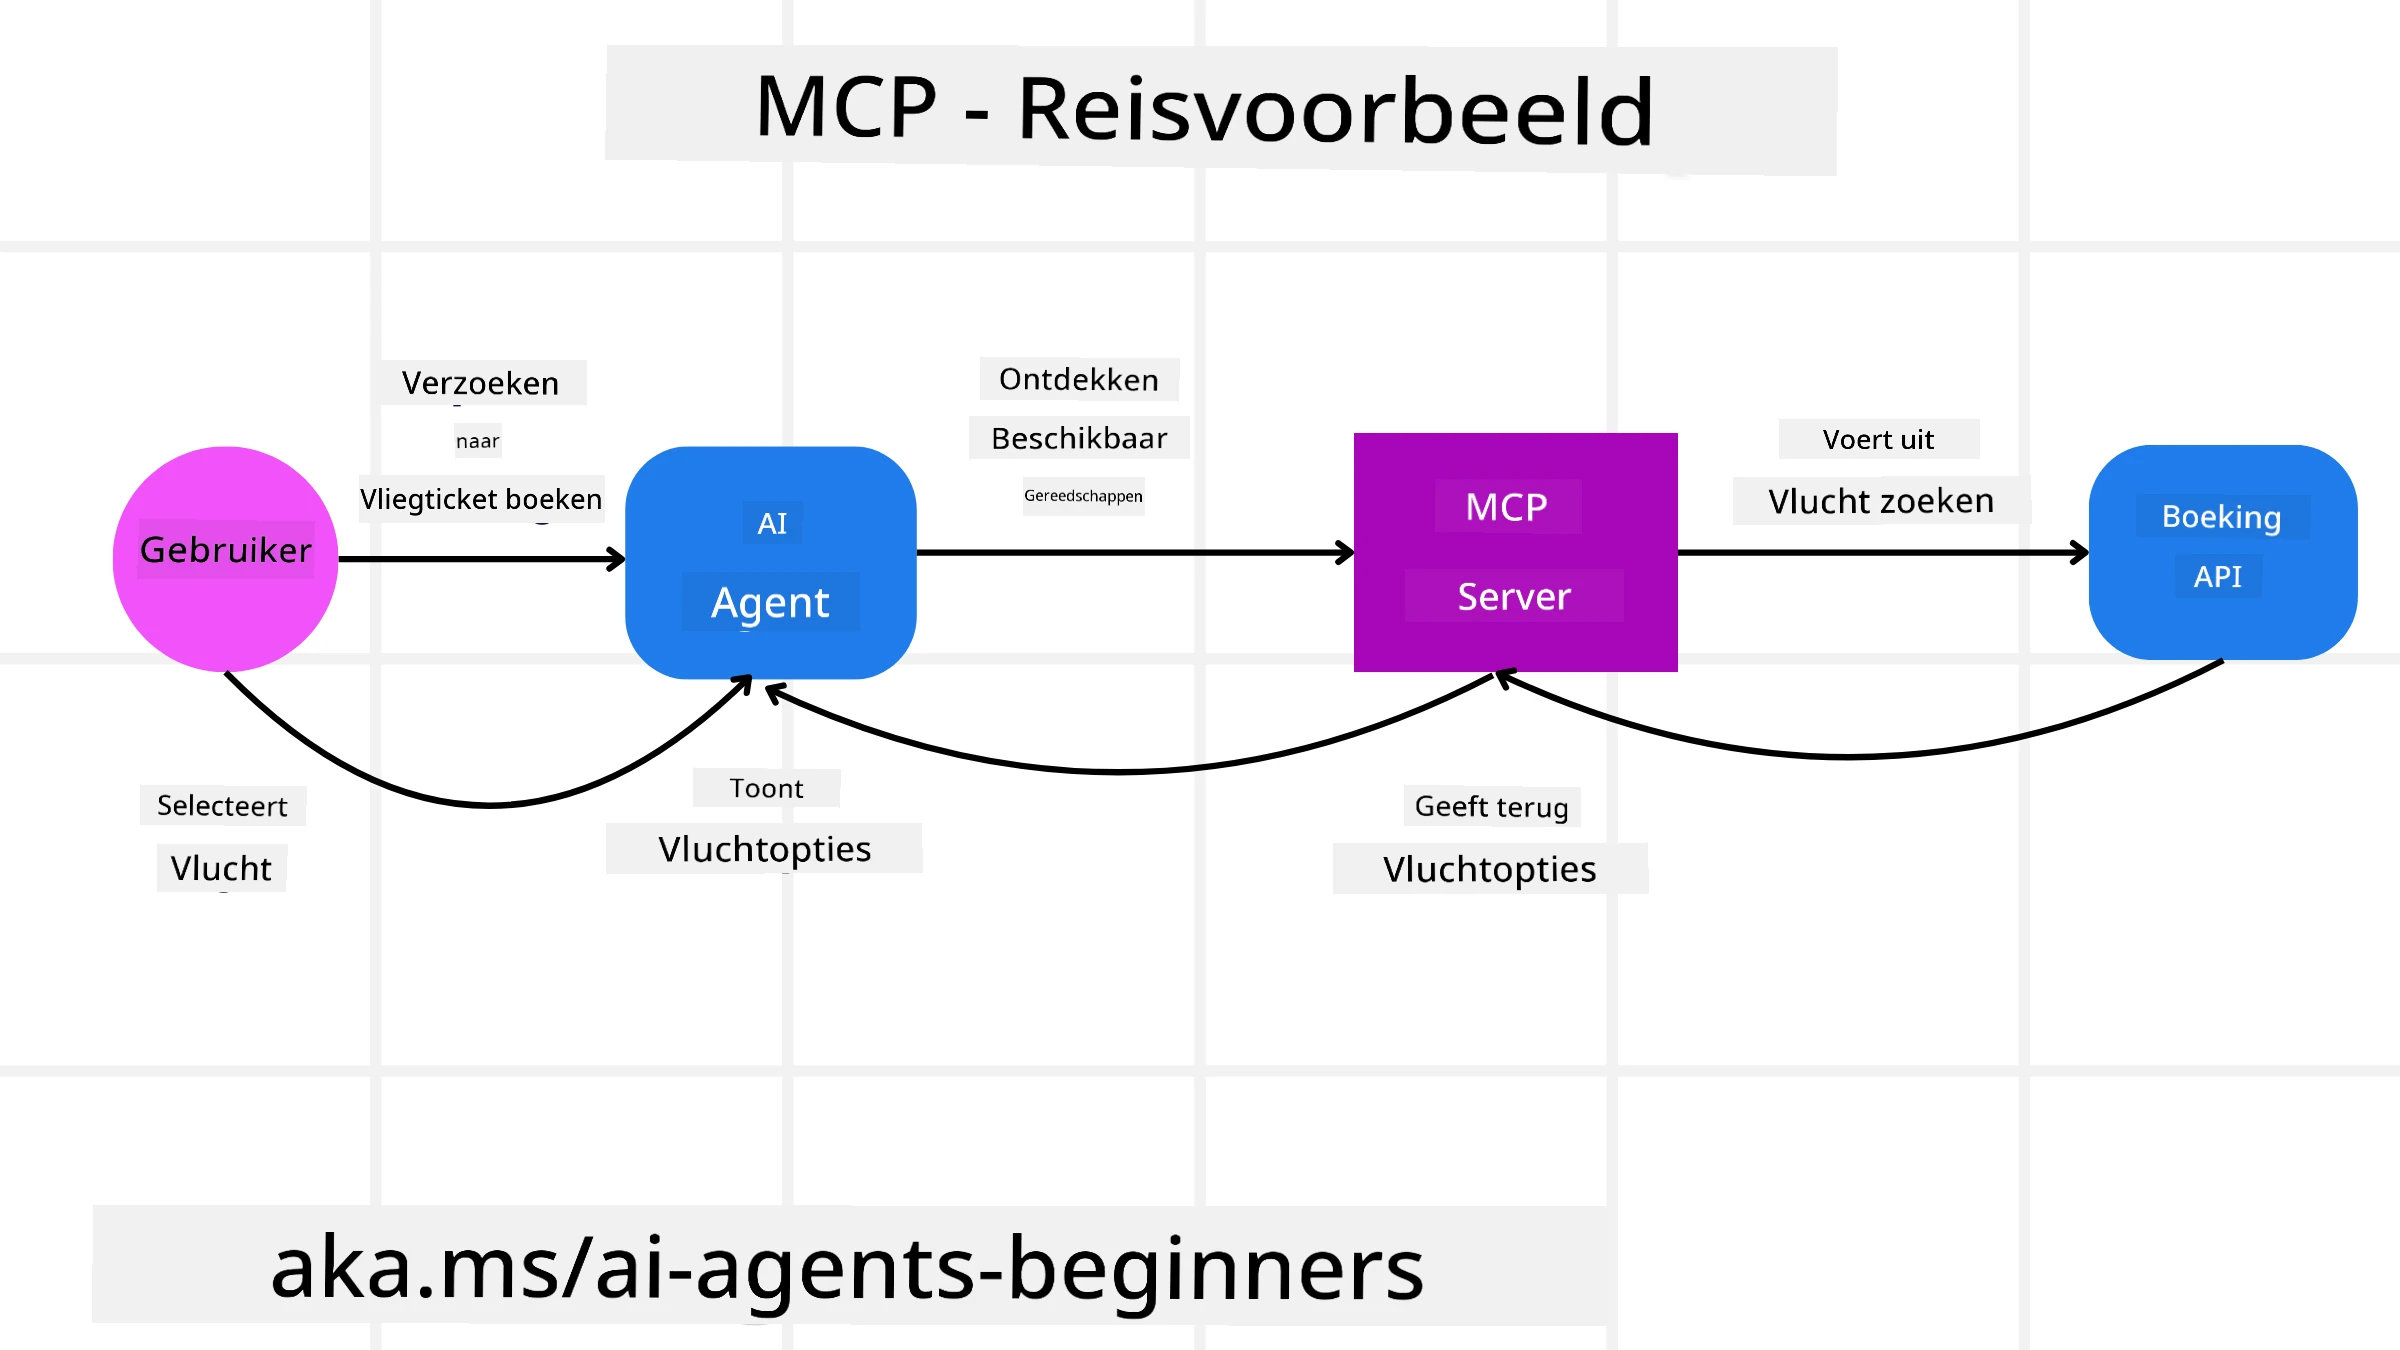
Stel je voor dat een gebruiker een vlucht wil boeken via een AI-assistent die wordt aangedreven door MCP.
-
Verbinding: De AI-assistent (de MCP-client) maakt verbinding met een MCP-server die door een luchtvaartmaatschappij wordt geleverd.
-
Toolontdekking: De client vraagt aan de MCP-server van de luchtvaartmaatschappij: “Welke tools hebben jullie beschikbaar?” De server antwoordt met tools zoals “search flights” en “book flights”.
-
Tool-aanroep: Je vraagt dan aan de AI-assistent: “Zoek een vlucht van Portland naar Honolulu.” De AI-assistent identificeert met zijn LLM dat hij de tool “search flights” moet aanroepen en geeft de relevante parameters (vertrekpunt, bestemming) door aan de MCP-server.
-
Uitvoering en Antwoord: De MCP-server, als wrapper, doet de daadwerkelijke oproep naar de interne boekings-API van de luchtvaartmaatschappij. Hij ontvangt vervolgens de vluchtinformatie (bijv. JSON-data) en stuurt dit terug naar de AI-assistent.
-
Verdere Interactie: De AI-assistent presenteert de vluchtopties. Zodra je een vlucht selecteert, roept de assistent mogelijk de tool “book flight” op dezelfde MCP-server aan om de boeking te voltooien.
Agent-to-Agent Protocol (A2A)
Terwijl MCP zich richt op het verbinden van LLM’s met tools, gaat het Agent-to-Agent (A2A) protocol een stap verder door communicatie en samenwerking tussen verschillende AI-agenten mogelijk te maken. A2A verbindt AI-agenten over verschillende organisaties, omgevingen en technologieën om samen een gedeelde taak te voltooien.
We bekijken de componenten en voordelen van A2A, samen met een voorbeeld van hoe het toegepast kan worden in onze reisapplicatie.
A2A Kerncomponenten
A2A richt zich op communicatie tussen agenten en het samen laten werken om een deeltaak van de gebruiker te voltooien. Elke component van het protocol draagt hieraan bij:
Agent Card
Net zoals een MCP-server een lijst van tools deelt, bevat een Agent Card:
- De naam van de agent.
- Een beschrijving van de algemene taken die de agent uitvoert.
- Een lijst van specifieke vaardigheden met omschrijvingen om andere agenten (of zelfs menselijke gebruikers) te helpen bepalen wanneer en waarom ze die agent zouden willen aanroepen.
- De huidige Endpoint-URL van de agent.
- De versie en mogelijkheden van de agent zoals streaming reacties en push-notificaties.
Agent Executor
De Agent Executor is verantwoordelijk voor het doorgeven van de context van de gebruikerschat aan de externe agent, die deze context nodig heeft om de taak te begrijpen. In een A2A-server gebruikt een agent zijn eigen Large Language Model (LLM) om binnenkomende verzoeken te interpreteren en taken uit te voeren met zijn interne tools.
Artifact
Zodra een externe agent de gevraagde taak heeft afgerond, wordt het werkresultaat als een artifact aangemaakt. Een artifact bevat het resultaat van het werk van de agent, een beschrijving van wat is voltooid, en de tekstuele context die via het protocol wordt verzonden. Na verzending van het artifact wordt de verbinding met de externe agent gesloten totdat die weer nodig is.
Event Queue
Deze component wordt gebruikt voor het afhandelen van updates en het doorgeven van berichten. Dit is vooral belangrijk in productieomgevingen van agentic-systemen om te voorkomen dat de verbinding tussen agenten wordt verbroken voordat een taak is afgerond, vooral als het voltooien van taken langere tijd duurt.
Voordelen van A2A
• Verbeterde Samenwerking: Het stelt agenten van verschillende leveranciers en platforms in staat te communiceren, context te delen en samen te werken, wat naadloze automatisering over traditioneel gescheiden systemen mogelijk maakt.
• Flexibiliteit in Modelkeuze: Elke A2A-agent kan zelf beslissen welk LLM hij gebruikt voor zijn verzoeken, wat optimalisatie of fine-tuning per agent mogelijk maakt, in tegenstelling tot een enkele LLM-verbinding in sommige MCP-scenario’s.
• Ingebouwde Authenticatie: Authenticatie is direct geïntegreerd in het A2A-protocol, wat een robuust beveiligingsraamwerk biedt voor interacties tussen agenten.
A2A Voorbeeld
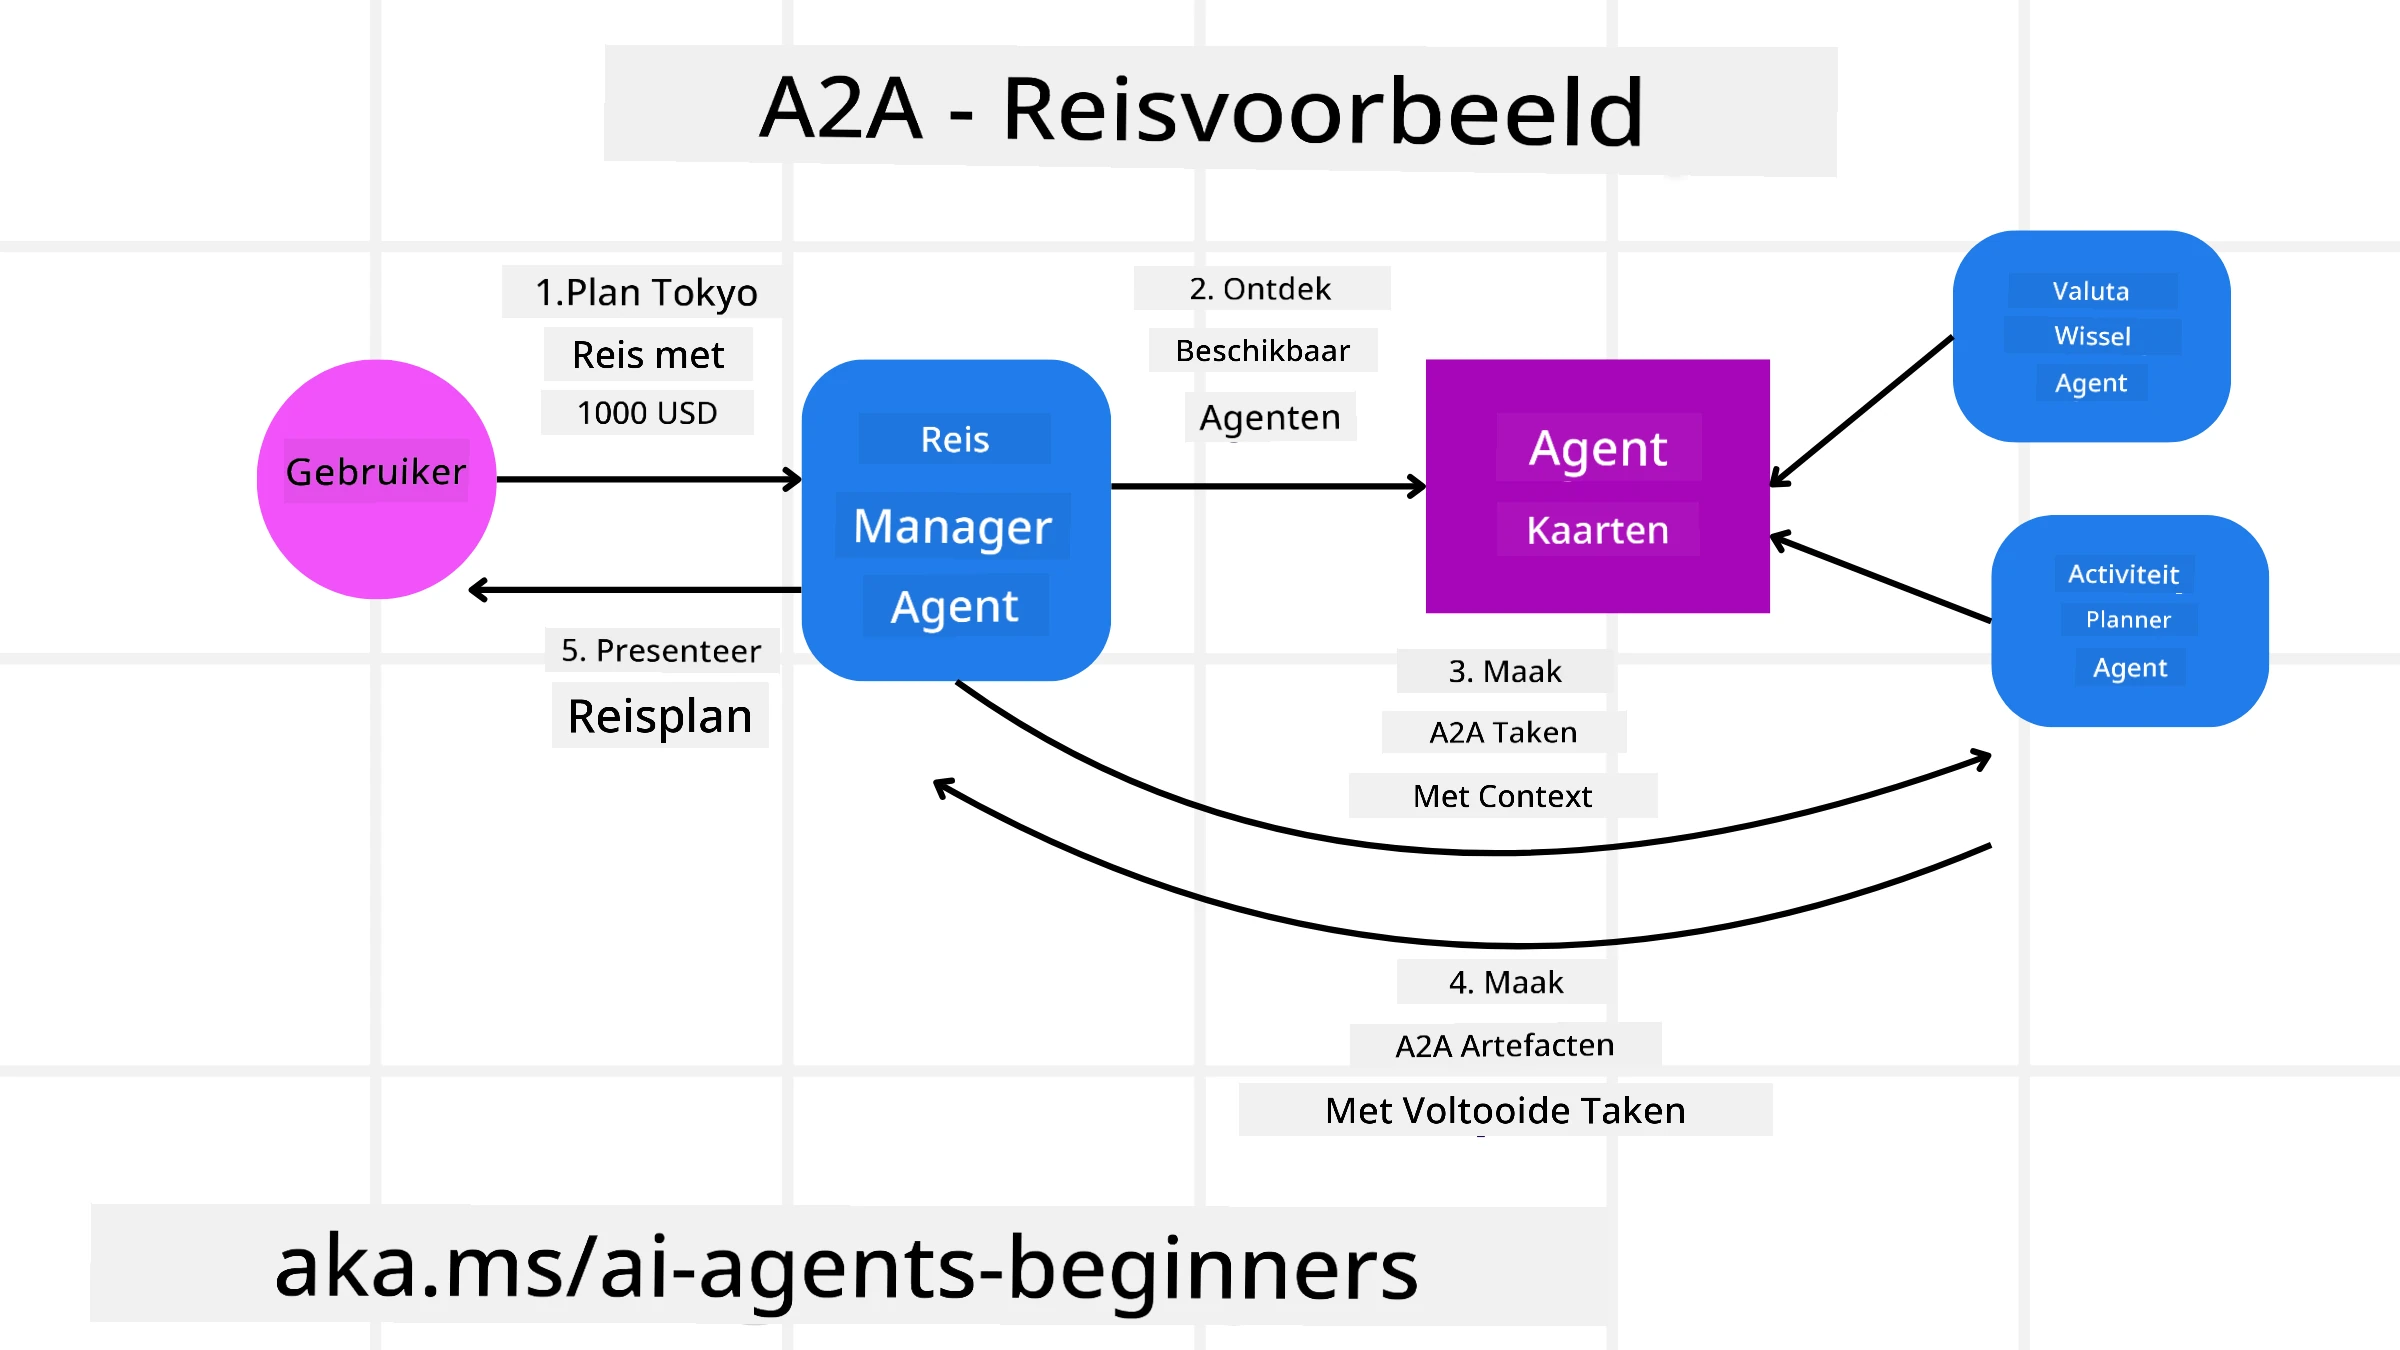
Laten we ons reisboekingsscenario uitbreiden met gebruik van A2A.
-
Gebruikersverzoek aan Multi-Agent: Een gebruiker communiceert met een “Travel Agent” A2A-client/agent, bijvoorbeeld met de opdracht: “Boek alsjeblieft een hele reis naar Honolulu voor volgende week, inclusief vluchten, hotel en huurauto”.
-
Orkestratie door Travel Agent: De Travel Agent ontvangt dit complexe verzoek. Hij gebruikt zijn LLM om na te denken over de taak en te bepalen dat interactie met andere gespecialiseerde agenten nodig is.
-
Inter-Agent Communicatie: De Travel Agent maakt vervolgens via het A2A-protocol verbinding met downstream-agenten, zoals een “Airline Agent,” een “Hotel Agent,” en een “Car Rental Agent” van verschillende bedrijven.
-
Gedecentraliseerde Taakuitvoering: De Travel Agent stuurt specifieke taken naar deze gespecialiseerde agenten (bijv. “Vind vluchten naar Honolulu”, “Boek een hotel”, “Huur een auto”). Elke gespecialiseerde agent, met zijn eigen LLM en interne tools (mogelijk MCP-servers), voert zijn deel van de boeking uit.
-
Geconsolideerd Antwoord: Zodra alle downstream-agenten hun taken hebben voltooid, verzamelt de Travel Agent de resultaten (vluchtdetails, hotelbevestiging, autohuurreservering) en stuurt een uitgebreide, chat-achtige reactie naar de gebruiker.
Natural Language Web (NLWeb)
Websites zijn al lange tijd de primaire manier voor gebruikers om informatie en data via het internet te raadplegen.
Laten we de verschillende componenten van NLWeb bekijken, de voordelen van NLWeb en een voorbeeld van hoe onze NLWeb werkt aan de hand van onze reisapplicatie.
Componenten van NLWeb
-
NLWeb Applicatie (Core Service Code): Het systeem dat natuurlijke taalvragen verwerkt. Het verbindt de verschillende onderdelen van het platform om antwoorden te creëren. Je kunt het zien als de motor achter de natuurlijke taal functionaliteiten van een website.
-
NLWeb Protocol: Dit is een basisset regels voor natuurlijke taal interactie met een website. Het stuurt antwoorden terug in JSON-formaat (vaak met Schema.org). Het doel is een eenvoudige basis te creëren voor het “AI Web,” net zoals HTML het delen van documenten online mogelijk maakte.
-
MCP Server (Model Context Protocol Endpoint): Elke NLWeb-opstelling functioneert ook als een MCP-server. Dit betekent dat het tools (zoals een “ask” methode) en data kan delen met andere AI-systemen. Dit maakt de inhoud en mogelijkheden van de website bruikbaar voor AI-agenten, zodat de site deel wordt van het bredere “agent-ecosysteem.”
-
Embedding Modellen: Deze modellen worden gebruikt om website-inhoud om te zetten in numerieke representaties, vectoren genoemd (embeddings). Deze vectoren vatten betekenis samen op een manier die computers kunnen vergelijken en doorzoeken. Ze worden opgeslagen in een speciale database, en gebruikers kunnen kiezen welke embeddingmodel ze willen gebruiken.
-
Vector Database (Ophaalmechanisme): Deze database slaat de embeddings van de website-inhoud op. Wanneer iemand een vraag stelt, raadpleegt NLWeb de vector database om snel de meest relevante informatie te vinden. Het geeft een snelle lijst mogelijke antwoorden, gerangschikt op overeenkomst. NLWeb werkt met verschillende vectoropslagsystemen zoals Qdrant, Snowflake, Milvus, Azure AI Search en Elasticsearch.
NLWeb door Voorbeeld
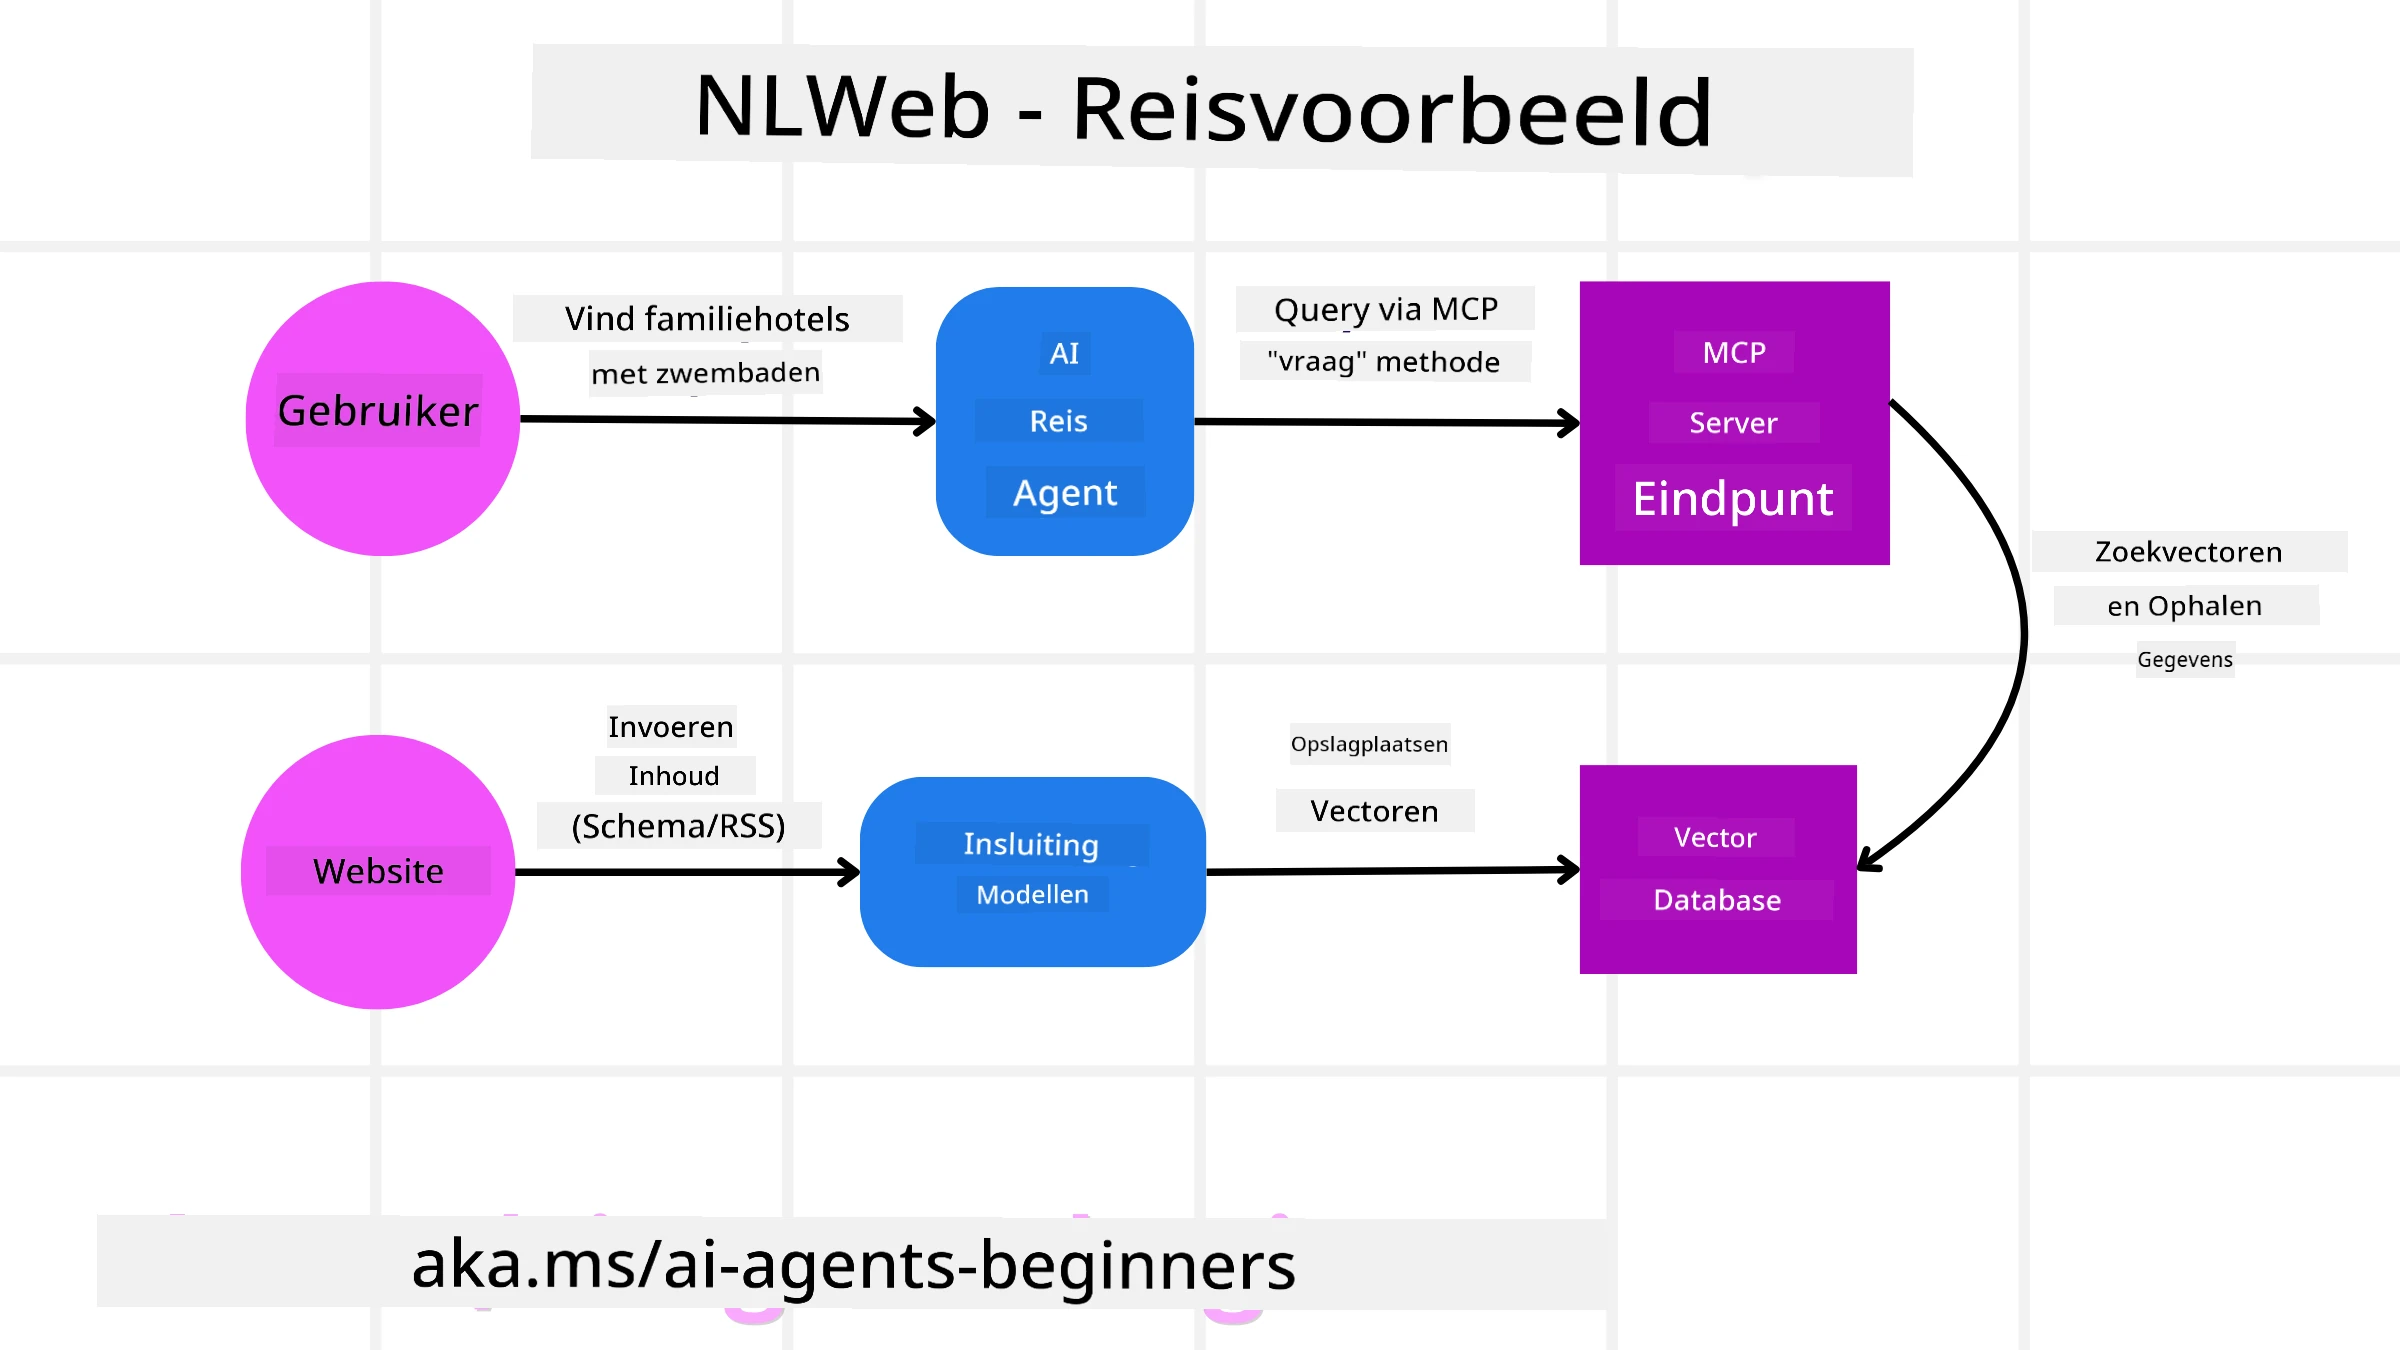
Bekijk onze reisboekingswebsite opnieuw, maar deze keer aangedreven door NLWeb.
-
Data Inname: De bestaande productcatalogi van de reiswebsite (bijv. vluchtlijsten, hotelbeschrijvingen, tourpakketten) worden geformatteerd met Schema.org of geladen via RSS-feeds. NLWeb’s tools nemen deze gestructureerde data in, maken embeddings en slaan deze op in een lokale of externe vectordatabase.
-
Natuurlijke Taalvraag (Mens): Een gebruiker bezoekt de website en typt in een chatinterface: “Vind een gezinsvriendelijk hotel in Honolulu met een zwembad voor volgende week.”
-
NLWeb Verwerking: De NLWeb-applicatie ontvangt deze vraag. Het stuurt de vraag naar een LLM voor begrip en zoekt gelijktijdig in de vectordatabase naar relevante hotelvermeldingen.
-
Nauwkeurige Resultaten: De LLM helpt de zoekresultaten te interpreteren, identificeert de beste overeenkomsten op basis van “gezinsvriendelijk,” “zwembad” en “Honolulu” criteria, en formatteert een natuurlijk taalantwoord. Belangrijk is dat het antwoord verwijst naar echte hotels uit de catalogus van de website, zonder verzonnen informatie.
-
AI Agent Interactie: Omdat NLWeb als een MCP-server functioneert, kan een externe AI-reisbureau agent ook verbinding maken met deze NLWeb-instantie van de website. De AI-agent kan dan de
askMCP-methode gebruiken om direct vragen te stellen aan de website:ask("Zijn er veganistische restaurants in de omgeving van Honolulu aanbevolen door het hotel?"). De NLWeb-instantie verwerkt dit met behulp van zijn database van restaurantinformatie (indien geladen) en stuurt een gestructureerd JSON-antwoorden terug.
Meer vragen over MCP/A2A/NLWeb?
Word lid van de Microsoft Foundry Discord om andere leerlingen te ontmoeten, office hours bij te wonen en je vragen over AI-agenten beantwoord te krijgen.
Bronnen
Vorige Les
Volgende Les
Context Engineering voor AI Agents
Disclaimer: Dit document is vertaald met behulp van de AI vertaaldienst Co-op Translator. Hoewel we streven naar nauwkeurigheid, dient u er rekening mee te houden dat geautomatiseerde vertalingen fouten of onnauwkeurigheden kunnen bevatten. Het originele document in de oorspronkelijke taal moet worden beschouwd als de gezaghebbende bron. Voor kritieke informatie wordt professionele menselijke vertaling aanbevolen. Wij zijn niet aansprakelijk voor eventuele misverstanden of verkeerde interpretaties die voortvloeien uit het gebruik van deze vertaling.