ai-agents-for-beginners
Agent AI w produkcji: Obserwowalność i ewaluacja
W miarę jak agenci AI przechodzą od prototypów eksperymentalnych do zastosowań w świecie rzeczywistym, ważna staje się umiejętność rozumienia ich zachowania, monitorowania ich wydajności oraz systematycznej oceny ich wyników.
Cele nauczania
Po ukończeniu tej lekcji będziesz znać/rozumieć:
- Podstawowe pojęcia związane z obserwowalnością i ewaluacją agentów
- Techniki poprawy wydajności, kosztów i efektywności agentów
- Co i jak systematycznie oceniać w swoich agentach AI
- Jak kontrolować koszty podczas wdrażania agentów AI do produkcji
- Jak instrumentować agentów zbudowanych w Microsoft Agent Framework
Celem jest wyposażenie Cię w wiedzę pozwalającą przekształcić Twoich agentów - “czarne skrzynki” - w systemy przejrzyste, zarządzalne i niezawodne.
Uwaga: Ważne jest wdrażanie agentów AI, którzy są bezpieczni i godni zaufania. Zapoznaj się również z lekcją Budowanie godnych zaufania agentów AI.
Ślady i spany
Narzędzia do obserwowalności takie jak Langfuse lub Microsoft Foundry zwykle przedstawiają uruchomienia agenta jako ślady i spany.
- Ślad to kompletne zadanie agenta od początku do końca (np. obsługa zapytania użytkownika).
- Spany to poszczególne kroki w obrębie śladu (np. wywołanie modelu językowego lub pobranie danych).
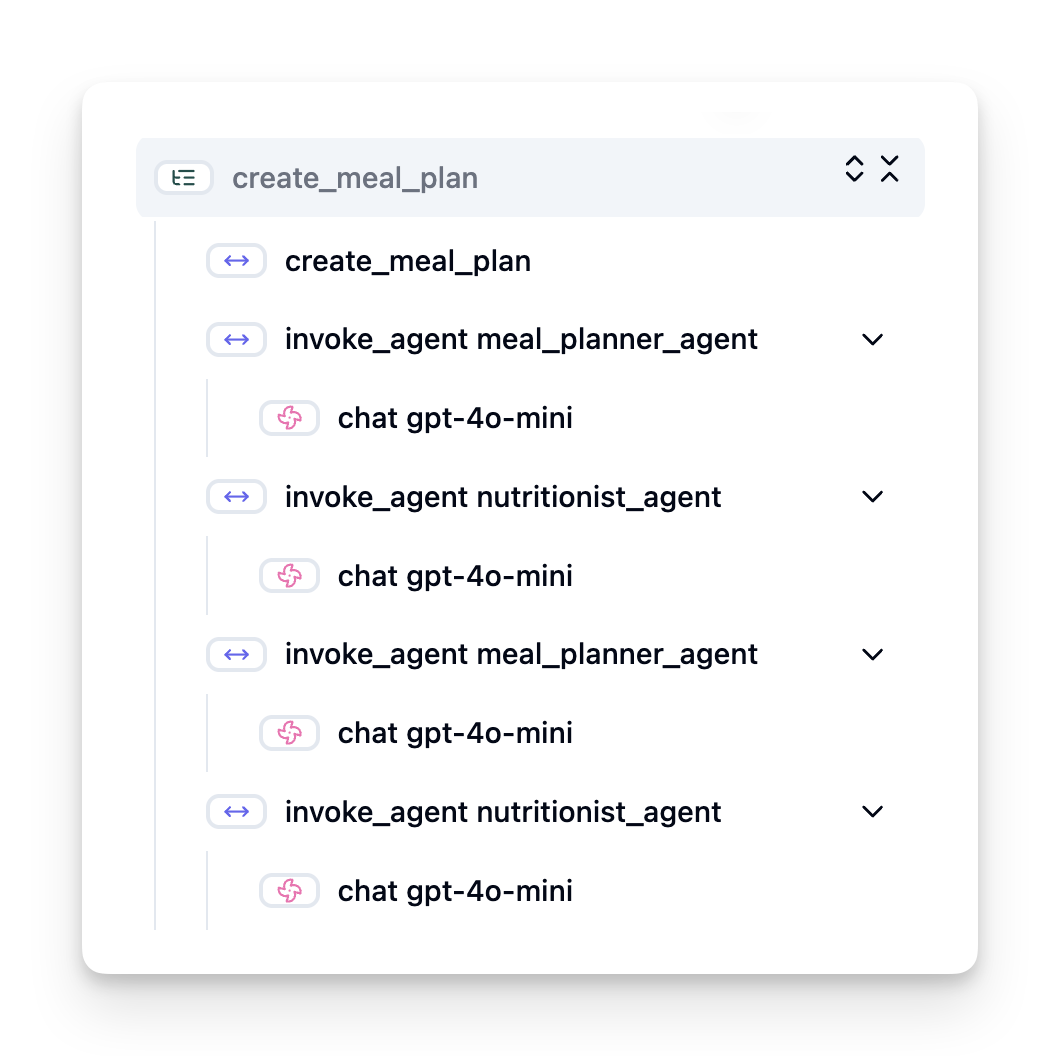
Bez obserwowalności agent AI może sprawiać wrażenie “czarnej skrzynki” — jego stan wewnętrzny i sposób rozumowania są nieprzejrzyste, co utrudnia diagnozowanie problemów lub optymalizację wydajności. Dzięki obserwowalności agenci stają się “szklanymi skrzynkami”, oferując transparentność, która jest kluczowa dla budowania zaufania i zapewnienia, że działają zgodnie z zamierzeniami.
Dlaczego obserwowalność ma znaczenie w środowiskach produkcyjnych
Przenoszenie agentów AI do środowisk produkcyjnych wiąże się z nowym zestawem wyzwań i wymagań. Obserwowalność nie jest już “miłym dodatkiem”, lecz krytyczną zdolnością:
- Debugowanie i analiza przyczyn źródłowych: Gdy agent zawodzi lub generuje nieoczekiwany wynik, narzędzia obserwowalności zapewniają ślady konieczne do zlokalizowania źródła błędu. Jest to szczególnie ważne w złożonych agentach, które mogą obejmować wiele wywołań LLM, interakcje z narzędziami oraz logikę warunkową.
- Zarządzanie opóźnieniami i kosztami: Agenci AI często korzystają z LLM i innych zewnętrznych API rozliczanych za token lub wywołanie. Obserwowalność umożliwia precyzyjne śledzenie tych wywołań, pomagając zidentyfikować operacje nadmiernie wolne lub kosztowne. Pozwala to zespołom optymalizować zapytania, wybierać efektywniejsze modele lub przeprojektowywać przepływy pracy, aby zarządzać kosztami operacyjnymi i zapewnić dobrą obsługę użytkownika.
- Zaufanie, bezpieczeństwo i zgodność: W wielu zastosowaniach ważne jest zapewnienie, że agenci zachowują się bezpiecznie i etycznie. Obserwowalność dostarcza ścieżkę audytu działań i decyzji agenta. Może być używana do wykrywania i łagodzenia problemów takich jak wstrzykiwanie promptów, generowanie szkodliwych treści czy niewłaściwe przetwarzanie danych osobowych (PII). Na przykład, można przejrzeć ślady, by zrozumieć, dlaczego agent udzielił takiej, a nie innej odpowiedzi lub użył konkretnego narzędzia.
- Pętle ciągłej poprawy: Dane z obserwowalności są fundamentem iteracyjnego procesu rozwoju. Monitorując, jak agenci sprawują się w rzeczywistych warunkach, zespoły mogą identyfikować obszary do ulepszenia, gromadzić dane do dopracowywania modeli oraz weryfikować wpływ zmian. Tworzy to pętlę zwrotną, w której produkcyjne spostrzeżenia z oceny online informują eksperymenty offline i udoskonalanie, prowadząc do stopniowej poprawy wydajności agenta.
Kluczowe metryki do śledzenia
Aby monitorować i rozumieć zachowanie agenta, należy śledzić szereg metryk i sygnałów. Chociaż konkretne metryki mogą się różnić w zależności od celu agenta, niektóre są uniwersalnie ważne.
Oto niektóre z najczęściej monitorowanych metryk przez narzędzia obserwowalności:
Opóźnienie: Jak szybko agent odpowiada? Długie czasy oczekiwania negatywnie wpływają na doświadczenie użytkownika. Powinieneś mierzyć opóźnienie dla zadań i poszczególnych kroków, śledząc uruchomienia agenta. Na przykład agent, który potrzebuje 20 sekund na wszystkie wywołania modelu, może zostać przyspieszony przez użycie szybszego modelu lub wykonywanie wywołań modelu równolegle.
Koszty: Jaki jest koszt za uruchomienie agenta? Agenci AI polegają na wywołaniach LLM rozliczanych za token lub zewnętrznych API. Częste korzystanie z narzędzi lub wielokrotne promptowanie może szybko zwiększać koszty. Na przykład, jeśli agent wywołuje LLM pięć razy dla marginalnej poprawy jakości, musisz ocenić, czy koszt jest uzasadniony lub czy możesz zmniejszyć liczbę wywołań albo użyć tańszego modelu. Monitorowanie w czasie rzeczywistym pomaga też wykryć niespodziewane skoki (np. błędy powodujące nadmierne pętle API).
Błędy żądań: Ile żądań agentowi nie powiodło się? Może to obejmować błędy API lub nieudane wywołania narzędzi. Aby agent był bardziej odporny na takie sytuacje w produkcji, można wtedy ustawić mechanizmy zapasowe lub ponowienia. Np. jeśli dostawca LLM A jest niedostępny, przełączasz się na dostawcę B jako backup.
Opinie użytkowników: Implementacja bezpośrednich ocen użytkowników dostarcza cennych informacji. Mogą to być jawne oceny (👍lubię/👎nie lub ⭐1-5 gwiazdek) lub komentarze tekstowe. Systematyczne negatywne opinie powinny Cię zaalarmować jako znak, że agent nie działa zgodnie z oczekiwaniami.
Ukryte opinie użytkowników: Zachowania użytkowników dostarczają pośrednich informacji zwrotnych nawet bez wyraźnych ocen. Mogą to być natychmiastowe przeformułowanie pytania, powtarzane zapytania lub kliknięcie przycisku ponów. Np. jeśli widzisz, że użytkownicy wielokrotnie zadają to samo pytanie, to znak, że agent nie działa poprawnie.
Dokładność: Jak często agent generuje poprawne lub pożądane wyniki? Definicje dokładności różnią się (np. poprawność rozwiązywania problemów, dokładność wyszukiwania informacji, satysfakcja użytkownika). Pierwszym krokiem jest zdefiniowanie, czym sukces jest dla twojego agenta. Możesz śledzić dokładność za pomocą automatycznych kontroli, ocen ewaluacyjnych lub etykiet zakończenia zadania. Na przykład oznaczając ślady jako “powodzenie” lub “niepowodzenie”.
Automatyczne metryki ewaluacyjne: Możesz także ustawić automatyczne ewaluacje. Na przykład można użyć LLM do oceniania wyniku agenta, np. czy jest pomocny, dokładny czy nie. Istnieje też kilka bibliotek open source pomagających w ocenianiu różnych aspektów agentów. Np. RAGAS dla agentów RAG lub LLM Guard do wykrywania szkodliwego języka lub wstrzykiwania promptów.
W praktyce kombinacja tych metryk daje najlepsze pokrycie zdrowia agenta AI. W przykładowym notebooku w tym rozdziale pokażemy, jak te metryki wyglądają na rzeczywistych przykładach, ale najpierw nauczymy się, jak wygląda typowy proces ewaluacji.
Instrumentuj swojego agenta
Aby zbierać dane śledzenia, musisz instrumentować swój kod. Celem jest instrumentacja kodu agenta w taki sposób, aby emitował ślady i metryki, które mogą być przechwytywane, przetwarzane i wizualizowane przez platformę obserwowalności.
OpenTelemetry (OTel): OpenTelemetry stał się standardem branżowym dla obserwowalności LLM. Dostarcza zestaw API, SDK oraz narzędzi do generowania, zbierania i eksportowania danych telemetrycznych.
Istnieje wiele bibliotek instrumentacyjnych owijających istniejące frameworki agentów i ułatwiających eksport spanów OpenTelemetry do narzędzi obserwowalności. Microsoft Agent Framework integruje się natywnie z OpenTelemetry. Poniżej przykład instrumentacji agenta MAF:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
Przykładowy notebook w tym rozdziale pokaże, jak instrumentować swojego agenta MAF.
Ręczne tworzenie spanów: Choć biblioteki instrumentacyjne zapewniają solidną podstawę, często potrzebne są bardziej szczegółowe lub niestandardowe informacje. Możesz ręcznie tworzyć spany, aby dodać własną logikę aplikacji. Co ważniejsze, możesz wzbogacać automatycznie lub ręcznie tworzone spany o niestandardowe atrybuty (znane też jako tagi lub metadane). Te atrybuty mogą zawierać dane specyficzne dla biznesu, obliczenia pośrednie lub każdy kontekst przydatny do debugowania lub analizy, jak user_id, session_id czy model_version.
Przykład ręcznego tworzenia śladów i spanów za pomocą Langfuse Python SDK:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
Ewaluacja agenta
Obserwowalność dostarcza nam metryk, ale ewaluacja to proces analizowania tych danych (oraz przeprowadzania testów), aby określić, jak dobrze agent AI działa i jak można go poprawić. Innymi słowy, gdy masz już te ślady i metryki, jak ich użyć do oceny agenta i podejmowania decyzji?
Regularna ewaluacja jest ważna, ponieważ agenci AI często nie są deterministyczni i mogą się rozwijać (poprzez aktualizacje lub dryf zachowania modelu) – bez ewaluacji nie dowiedziałbyś się, czy Twój „inteligentny agent” faktycznie dobrze spełnia swoją rolę, czy uległ regresji.
Istnieją dwie kategorie ewaluacji agentów AI: ewaluacja online i ewaluacja offline. Obie są wartościowe i się uzupełniają. Zazwyczaj zaczynamy od ewaluacji offline, ponieważ jest to minimalny niezbędny krok przed wdrożeniem agenta.
Ewaluacja offline
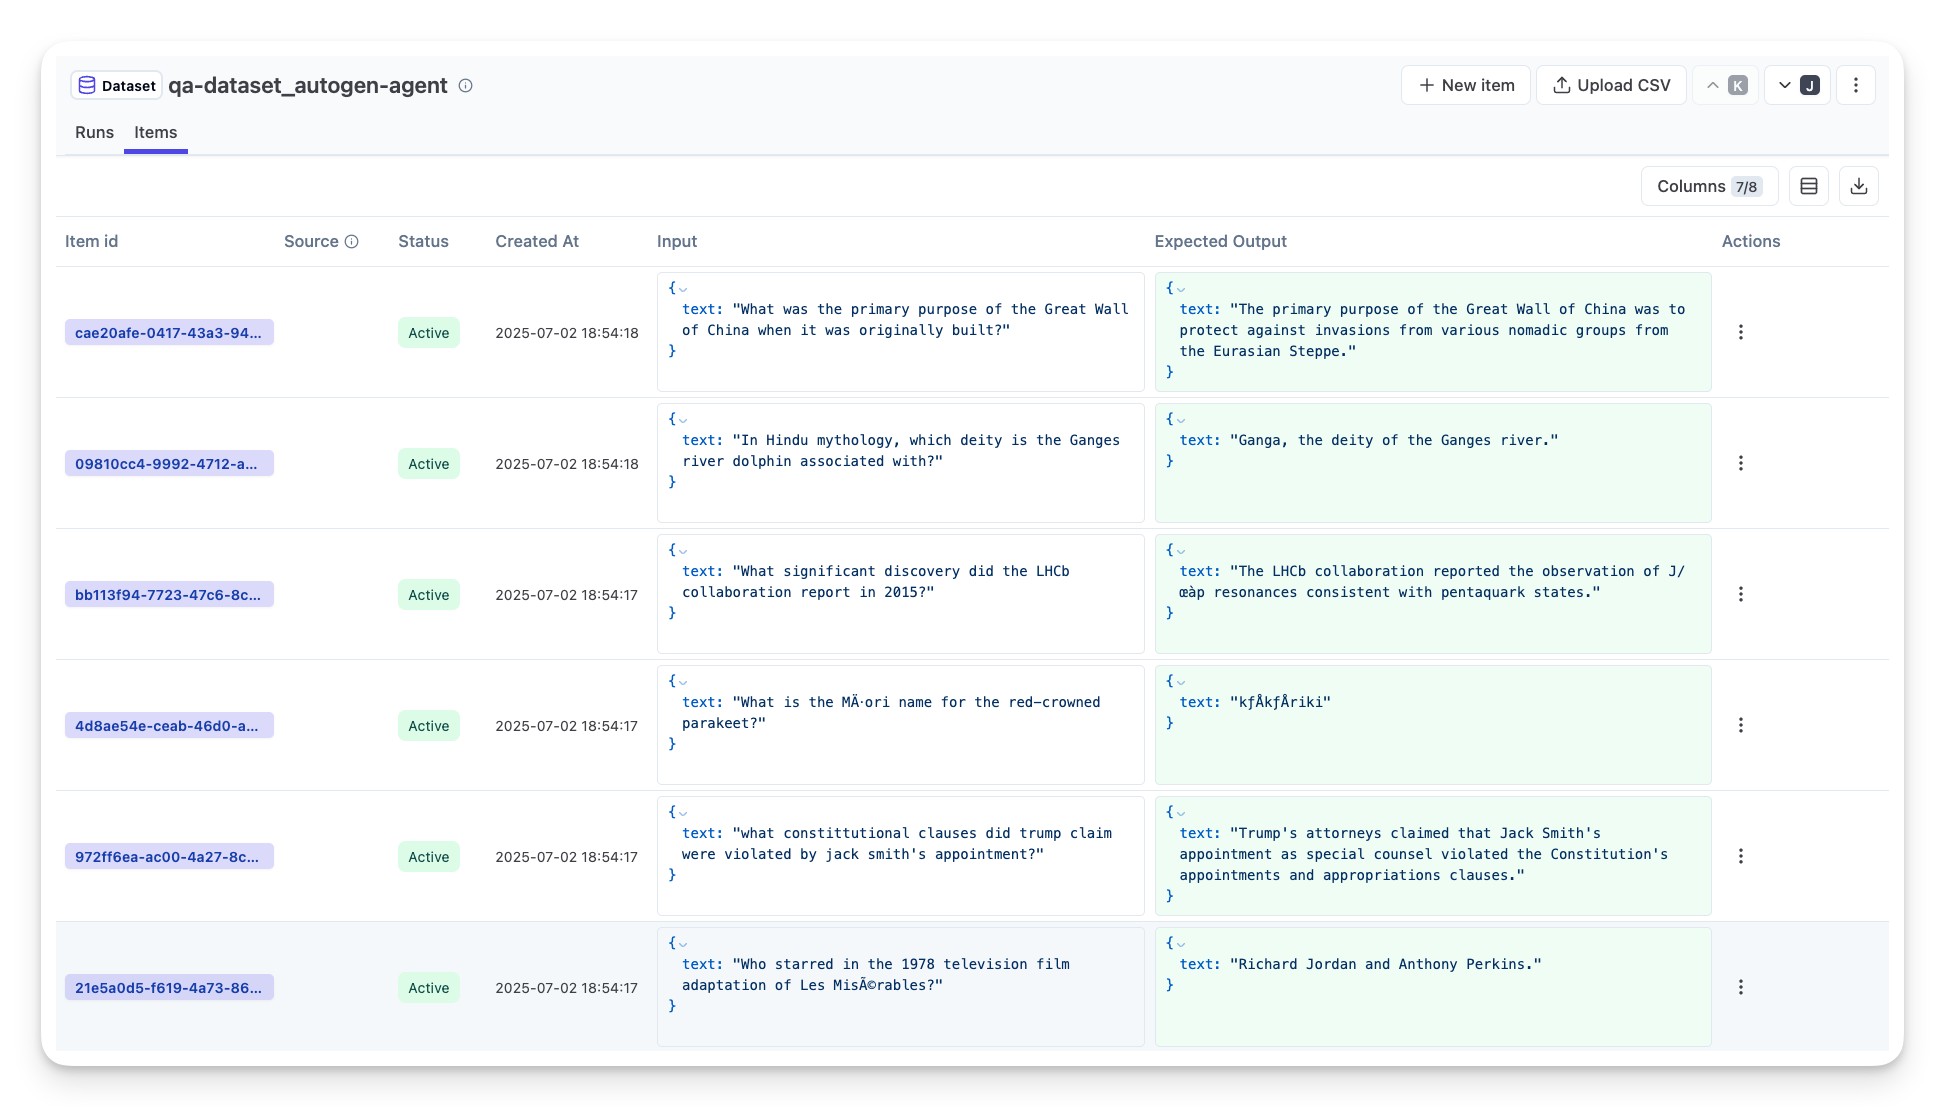
Polega na ocenie agenta w kontrolowanym środowisku, zwykle z użyciem zestawów testowych, a nie zapytań na żywo od użytkowników. Używasz wyselekcjonowanych zbiorów danych, gdzie znany jest oczekiwany wynik lub prawidłowe zachowanie, a następnie uruchamiasz na nich swojego agenta.
Na przykład, jeśli zbudowałeś agenta do rozwiązywania zadań tekstowych z matematyki, możesz mieć zestaw testowy 100 problemów z znanymi odpowiedziami. Ewaluacja offline jest często wykonywana podczas rozwoju (i może być częścią pipeline CI/CD) w celu sprawdzania poprawy lub zapobiegania regresjom. Korzyścią jest, że jest powtarzalna i możesz uzyskać jasne metryki dokładności, ponieważ masz prawdę podstawową. Możesz też symulować zapytania użytkowników i mierzyć odpowiedzi agenta względem idealnych odpowiedzi lub używać automatycznych metryk opisanych wcześniej.
Kluczowym wyzwaniem ewaluacji offline jest zapewnienie, że twój zestaw testowy jest wszechstronny i pozostaje aktualny – agent może dobrze działać na stałym zestawie testowym, ale natrafić na bardzo inne zapytania w produkcji. Dlatego powinieneś aktualizować zestawy testowe o nowe przypadki krawędziowe i przykłady odzwierciedlające rzeczywiste scenariusze. Przydatne jest mieszanie małych „testów dymnych” i większych zestawów ewaluacyjnych: małe do szybkich kontroli i większe do szerszych metryk wydajności.
Ewaluacja online
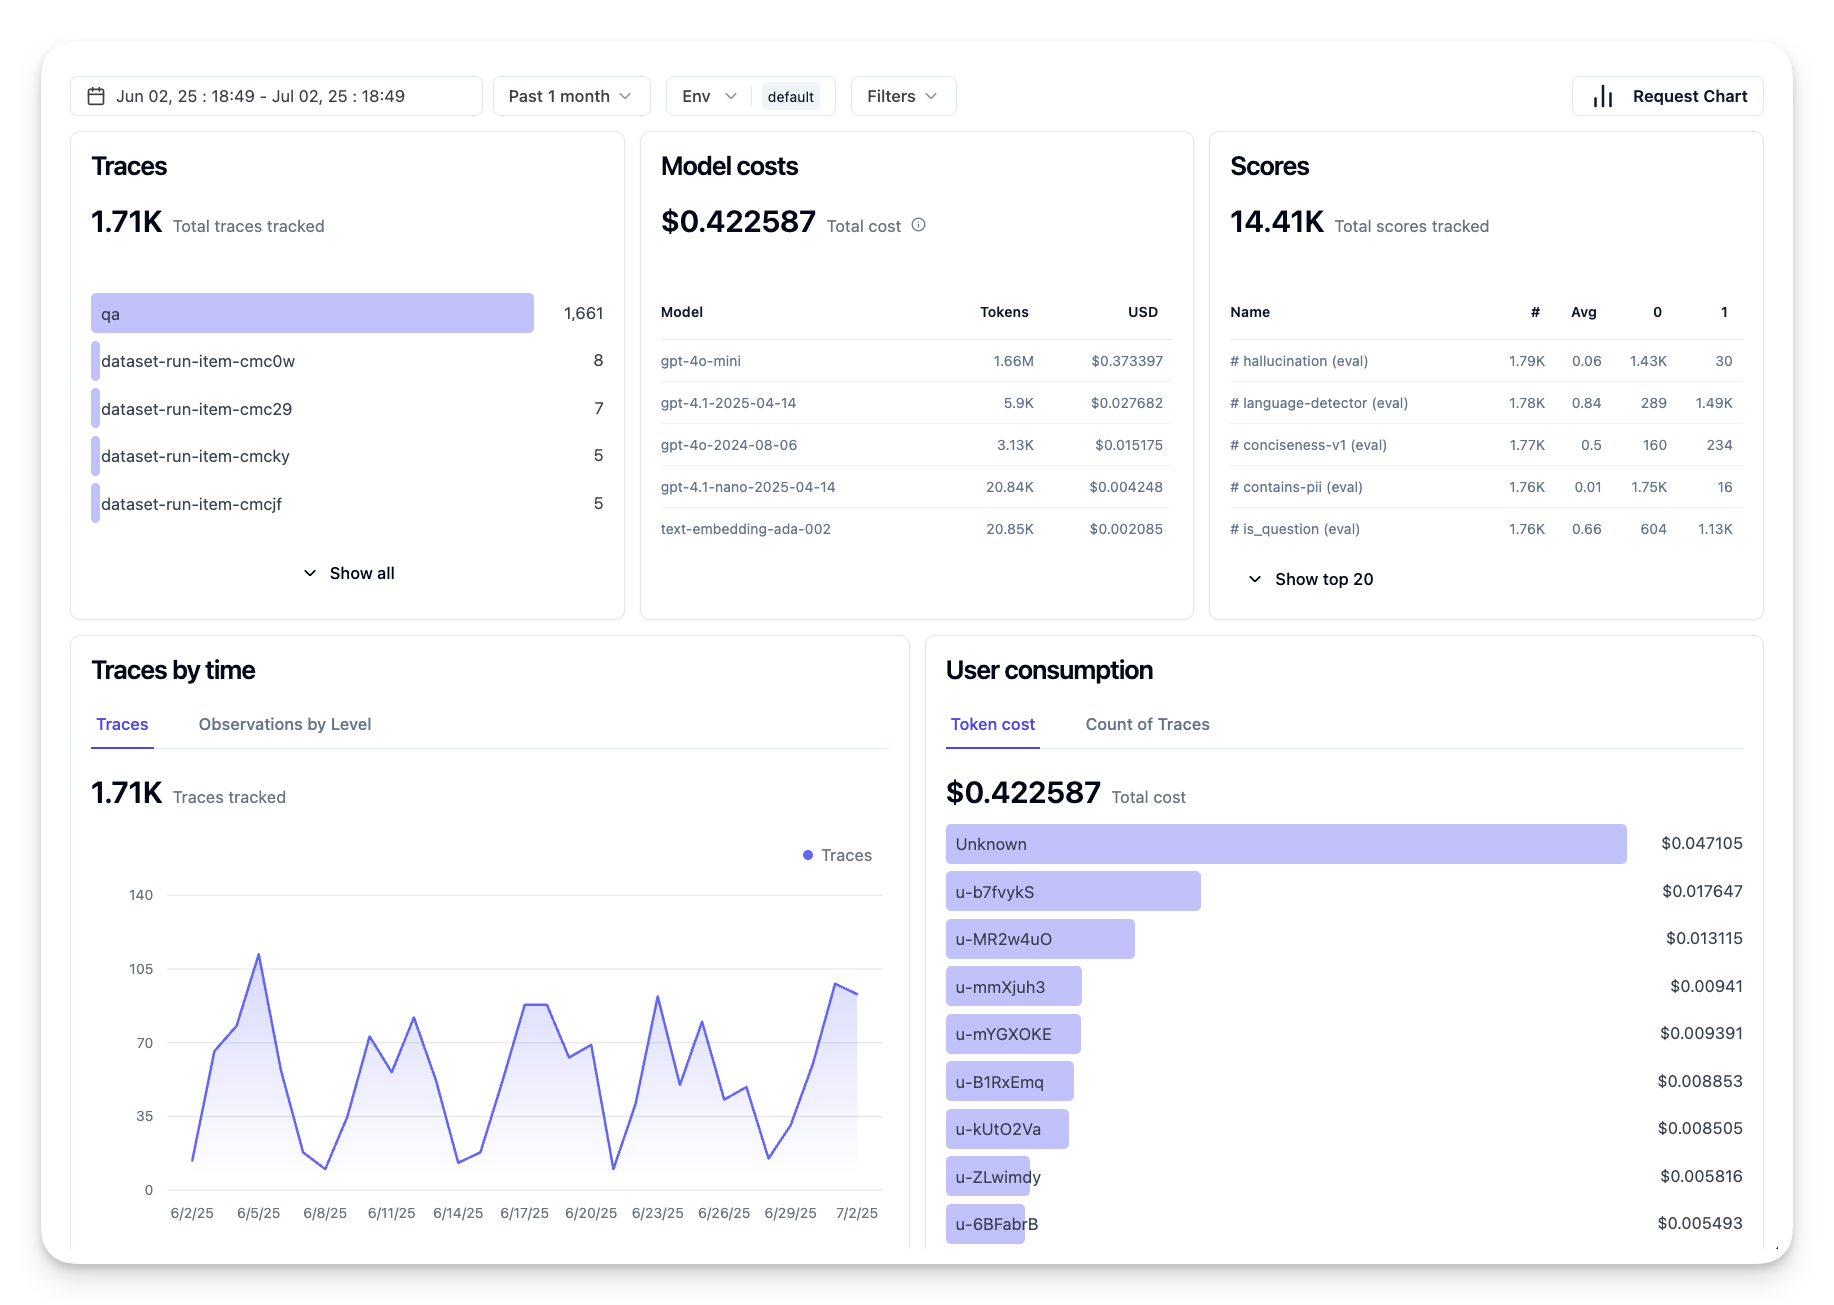
Odnosi się do oceny agenta w środowisku na żywo, czyli podczas rzeczywistego użytkowania w produkcji. Ewaluacja online polega na ciągłym monitorowaniu wydajności agenta w interakcjach z użytkownikami i analizowaniu wyników.
Na przykład możesz śledzić wskaźniki sukcesu, oceny satysfakcji użytkowników lub inne metryki na ruchu na żywo. Zaleta ewaluacji online jest taka, że uwzględnia kwestie, których możesz nie przewidzieć w warunkach laboratoryjnych – możesz obserwować dryf modelu w czasie (jeśli skuteczność agenta spada wraz ze zmianą wzorców danych wejściowych) oraz wychwytywać niespodziewane zapytania lub sytuacje, które nie były w twoich danych testowych. Dostarcza to rzeczywistego obrazu zachowania agenta na polu.
Ewaluacja online często obejmuje zbieranie jawnych i ukrytych opinii użytkowników, jak omówiono wcześniej, oraz ewentualne uruchamianie testów cieniowych lub testów A/B (gdzie nowa wersja agenta działa równolegle do starej, by porównać wyniki). Wyzwanie polega na tym, że trudno jest uzyskać wiarygodne etykiety lub oceny dla interakcji na żywo – możesz polegać na opiniach użytkowników lub metrykach pochodnych (np. czy użytkownik kliknął wynik).
Łączenie obu podejść
Ewaluacje online i offline nie są wykluczające się; są wysoce uzupełniające. Wnioski z monitoringu online (np. nowe typy zapytań użytkowników, w których agent radzi sobie słabo) mogą być wykorzystane do rozszerzenia i poprawienia zestawów testowych offline. Natomiast agenci, którzy dobrze wypadną w testach offline, mogą być potem z większym zaufaniem wdrażani i monitorowani online.
W praktyce wiele zespołów stosuje pętlę:
ocena offline -> wdrażanie -> monitoring online -> zbieranie nowych przypadków błędów -> dodawanie do zestawu offline -> ulepszanie agenta -> powtarzanie.
Typowe problemy
W miarę wdrażania agentów AI do produkcji możesz napotkać różne wyzwania. Oto niektóre typowe problemy i ich potencjalne rozwiązania:
| Problem | Potencjalne rozwiązanie |
|---|---|
| Agent AI nie wykonuje zadań konsekwentnie | - Udoskonal prompt podany agentowi AI; bądź jasny co do celów. - Zidentyfikuj miejsce, gdzie podział zadań na podzadania realizowane przez wielu agentów może pomóc. |
| Agent AI wpada w ciągłe pętle | - Upewnij się, że masz jasne warunki zakończenia, żeby agent wiedział, kiedy zatrzymać proces. - Dla złożonych zadań wymagających rozumowania i planowania, użyj większego modelu specjalizowanego w tego typu zadania. |
| Wywołania narzędzi przez agenta AI nie działają dobrze | - Testuj i weryfikuj wynik narzędzia poza systemem agenta. - Ulepsz parametry definiowane, promptowanie i nazewnictwo narzędzi. |
| System wieloagentowy nie działa spójnie | - Udoskonal promptowanie podane każdemu agentowi, aby były specyficzne i odróżniały się od siebie. - Zbuduj system hierarchiczny wykorzystujący agenta “routera” lub kontrolera do określenia, który agent jest odpowiedni. |
Wiele z tych problemów można skuteczniej wykryć dzięki wprowadzonej obserwowalności. Omówione wcześniej ślady i metryki pomagają precyzyjnie zlokalizować, gdzie w przepływie pracy agenta występują problemy, co znacznie ułatwia debugowanie i optymalizację.
Zarządzanie kosztami
Oto kilka strategii zarządzania kosztami wdrażania agentów AI w produkcji:
Używanie mniejszych modeli: Małe modele językowe (SLM) mogą dobrze sprawdzać się w niektórych agentowych przypadkach użycia i znacznie obniżą koszty. Jak wspomniano wcześniej, budowa systemu oceny do ustalenia i porównania wydajności względem większych modeli to najlepszy sposób, aby zrozumieć, jak dobrze SLM poradzi sobie w Twoim przypadku użycia. Rozważ użycie SLM do prostszych zadań, takich jak klasyfikacja intencji czy ekstrakcja parametrów, pozostawiając większe modele do złożonego rozumowania.
Używanie modelu routera: Podobną strategią jest użycie różnorodności modeli i ich rozmiarów. Możesz użyć LLM/SLM lub funkcji bezserwerowej do kierowania zapytań w zależności od złożoności do najlepiej dopasowanych modeli. To również pomoże zredukować koszty, jednocześnie zapewniając wydajność w odpowiednich zadaniach. Na przykład kieruj proste zapytania do mniejszych, szybszych modeli, a drogie, duże modele wykorzystuj tylko do złożonych zadań rozumowania.
Buforowanie odpowiedzi: Identyfikowanie częstych zapytań i zadań oraz dostarczanie odpowiedzi zanim przejdą przez twój system agentowy to dobry sposób na zmniejszenie liczby podobnych zapytań. Możesz nawet wdrożyć przepływ umożliwiający ocenę, jak bardzo zapytanie jest podobne do tych już zbuforowanych, używając prostszych modeli AI. Ta strategia może znacząco obniżyć koszty dla często zadawanych pytań lub typowych procesów.
Zobaczmy, jak to działa w praktyce
W przykładowym notatniku tej sekcji zobaczymy przykłady użycia narzędzi do obserwowalności w celu monitorowania i oceny naszego agenta.
Masz więcej pytań dotyczących agentów AI w produkcji?
Dołącz do Microsoft Foundry Discord, aby spotkać się z innymi uczącymi się, uczestniczyć w godzinach konsultacji i uzyskać odpowiedzi na pytania dotyczące agentów AI.
Poprzednia lekcja
Wzorzec projektowy metapoznawczy
Następna lekcja
Zastrzeżenie: Niniejszy dokument został przetłumaczony za pomocą usługi tłumaczenia AI Co-op Translator. Choć dążymy do dokładności, prosimy pamiętać, że automatyczne tłumaczenia mogą zawierać błędy lub niedokładności. Oryginalny dokument w jego języku źródłowym należy uznawać za autorytatywne źródło. W przypadku informacji krytycznych zalecane jest skorzystanie z profesjonalnego tłumaczenia wykonanego przez człowieka. Nie ponosimy odpowiedzialności za jakiekolwiek nieporozumienia lub błędne interpretacje wynikające z użycia tego tłumaczenia.