ai-agents-for-beginners
Agenți AI în producție: Observabilitate și evaluare
Pe măsură ce agenții AI trec de la prototipuri experimentale la aplicații din lumea reală, devine importantă capacitatea de a înțelege comportamentul lor, de a monitoriza performanța și de a evalua în mod sistematic rezultatele acestora.
Obiective de învățare
După parcurgerea acestei lecții, vei ști cum să/vei înțelege:
- Conceptele de bază ale observabilității și evaluării agenților
- Tehnici pentru îmbunătățirea performanței, costurilor și eficacității agenților
- Ce și cum să evaluezi agenții AI în mod sistematic
- Cum să controlezi costurile la implementarea agenților AI în producție
- Cum să instrumentezi agenții construiți cu Microsoft Agent Framework
Scopul este să te echipezi cu cunoștințele necesare pentru a transforma agenții tăi „cutie neagră” în sisteme transparente, gestionabile și de încredere.
Notă: Este important să implementezi agenți AI care sunt siguri și de încredere. Consultă și lecția Construirea agenților AI de încredere.
Urmăriri și intervale
Unelte de observabilitate precum Langfuse sau Microsoft Foundry reprezintă de obicei execuțiile agenților ca urmăriri (traces) și intervale (spans).
- Urmărirea (Trace) reprezintă o sarcină completă a agentului de la început până la sfârșit (precum gestionarea unei interogări utilizator).
- Intervalele (Spans) sunt pași individuali în cadrul urmăririi (precum apelarea unui model lingvistic sau preluarea de date).
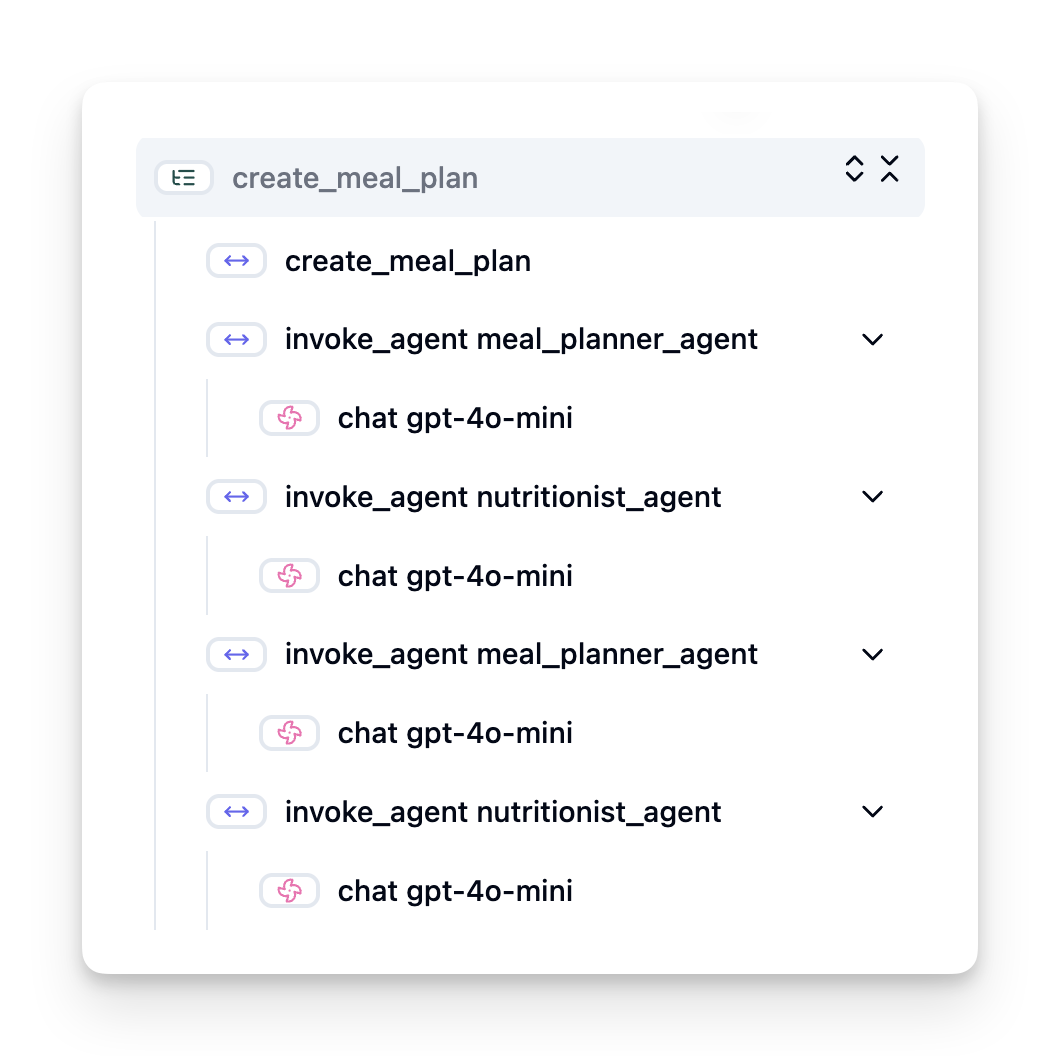
Fără observabilitate, un agent AI poate părea o “cutie neagră” – starea sa internă și raționamentul sunt opace, ceea ce face dificilă diagnosticarea problemelor sau optimizarea performanței. Cu observabilitate, agenții devin “cutii de sticlă”, oferind transparența vitală pentru a construi încredere și a asigura funcționarea conform intenției.
De ce este importantă observabilitatea în mediile de producție
Tranziția agenților AI către mediile de producție introduce un set nou de provocări și cerințe. Observabilitatea nu mai este un „nice-to-have”, ci o capacitate critică:
- Depanare și analiză a cauzelor rădăcină: Când un agent eșuează sau produce un rezultat neașteptat, uneltele de observabilitate oferă urmăririle necesare pentru a identifica sursa erorii. Acest aspect este esențial în agenții complecși care pot implica multiple apeluri LLM, interacțiuni cu instrumente și logică condițională.
- Gestionarea latenței și costurilor: Agenții AI se bazează adesea pe LLM-uri și alte API-uri externe facturate per token sau apel. Observabilitatea permite urmărirea precisă a acestor apeluri, ajutând la identificarea operațiunilor excesiv de lente sau costisitoare. Acest lucru permite echipelor să optimizeze promt-urile, să aleagă modele mai eficiente sau să reconfigureze fluxurile de lucru pentru a gestiona costurile operaționale și a asigura o experiență bună pentru utilizator.
- Încredere, siguranță și conformitate: În multe aplicații, este important să te asiguri că agenții se comportă în mod sigur și etic. Observabilitatea oferă o pistă de audit a acțiunilor și deciziilor agentului. Aceasta poate fi folosită pentru detectarea și atenuarea problemelor precum injecția de prompturi, generarea de conținut dăunător sau manipularea greșită a informațiilor personale identificabile (PII). De exemplu, poți analiza urmăririle pentru a înțelege de ce un agent a oferit un răspuns anume sau a folosit un anumit instrument.
- Bucle de îmbunătățire continuă: Datele de observabilitate sunt baza unui proces iterativ de dezvoltare. Prin monitorizarea performanței agenților în lumea reală, echipele pot identifica zone de îmbunătățire, pot colecta date pentru reglarea fină a modelelor și pot valida impactul schimbărilor. Aceasta creează o buclă de feedback unde informațiile din producție obținute prin evaluări online informează experimentarea și perfecționarea offline, conducând la o performanță progresiv mai bună a agenților.
Metrice cheie de urmărit
Pentru a monitoriza și înțelege comportamentul agentului, trebuie urmărit un set de metrice și semnale. Deși metricele specifice pot varia în funcție de scopul agentului, unele sunt universale.
Iată câteva dintre cele mai comune metrice monitorizate de uneltele de observabilitate:
Latență: Cât de rapid răspunde agentul? Timpii mari de așteptare afectează negativ experiența utilizatorului. Ar trebui să măsori latența pentru sarcini și pași individuali urmărind execuțiile agentului. De exemplu, un agent care durează 20 de secunde pentru toate apelurile la model poate fi accelerat folosind un model mai rapid sau rulând apelurile în paralel.
Costuri: Care este cheltuiala per execuție a agentului? Agenții AI se bazează pe apeluri la LLM facturate per token sau API-uri externe. Utilizarea frecventă a instrumentelor sau multiple promp-uri pot crește rapid costurile. De exemplu, dacă un agent apelează un LLM de cinci ori pentru o îmbunătățire marginală a calității, trebuie să evaluezi dacă costul este justificat sau dacă poți reduce numărul apelurilor sau folosi un model mai ieftin. Monitorizarea în timp real poate ajuta de asemenea la identificarea spike-urilor neașteptate (ex. bug-uri care cauzează bucle API excesive).
Erori la cereri: Câte cereri a eșuat agentul să proceseze? Acest lucru poate include erori API sau apeluri către instrumente care au eșuat. Pentru a face agentul mai robust în producție, poți configura măsuri de rezervă sau reîncercări. De ex., dacă furnizorul LLM A este indisponibil, poți comuta la furnizorul LLM B ca backup.
Feedback utilizator: Implementarea evaluărilor directe din partea utilizatorilor oferă informații valoroase. Aceasta poate include evaluări explicite (👍de acord/👎nu, ⭐1-5 stele) sau comentarii text. Feedback-ul negativ constant trebuie să te alerteze deoarece este un semn că agentul nu funcționează conform așteptărilor.
Feedback implicit al utilizatorului: Comportamentele utilizatorilor oferă feedback indirect chiar și fără evaluări explicite. Acest lucru poate include reformularea imediată a întrebării, interogări repetate sau apăsarea butonului de retry. De ex., dacă observi că utilizatorii pun repetat aceeași întrebare, acesta este un semn că agentul nu funcționează corespunzător.
Acuratețe: Cât de frecvent produce agentul rezultate corecte sau dorite? Definițiile acurateții variază (de ex., corectitudinea rezolvării problemelor, acuratețea recuperării informațiilor, satisfacția utilizatorului). Primul pas este să definești ce înseamnă succes pentru agentul tău. Poți urmări acuratețea prin verificări automate, scoruri de evaluare sau etichete de finalizare a sarcinii. De exemplu, marcând urmăririle ca „reusite” sau „eșuate”.
Metrici automate de evaluare: Poți configura și evaluări automate. De exemplu, poți folosi un LLM pentru a evalua rezultatul agentului, ex. dacă este util, precis sau nu. Există și câteva biblioteci open source care te ajută să evaluezi diferite aspecte ale agentului. De ex. RAGAS pentru agenți RAG sau LLM Guard pentru detectarea limbajului dăunător sau a injecțiilor de prompturi.
În practică, o combinație a acestor metrice oferă cea mai bună acoperire a sănătății unui agent AI. În notebook-ul exemplu din acest capitol, îți vom arăta cum arată aceste metrice în exemple reale, dar mai întâi vom învăța cum arată un flux tipic de evaluare.
Instrumentează agentul
Pentru a colecta date de urmărire, trebuie să instrumentezi codul. Scopul este să instrumentezi codul agentului pentru a emite urmăririle și metricele ce pot fi capturate, procesate și vizualizate de o platformă de observabilitate.
OpenTelemetry (OTel): OpenTelemetry a devenit un standard industrial pentru observabilitatea LLM. Oferă un set de API-uri, SDK-uri și unelte pentru generarea, colectarea și exportul datelor telemetrice.
Există multe biblioteci de instrumentare care înfășoară cadrele de agenți existente și facilitează exportul de intervale OpenTelemetry către un tool de observabilitate. Microsoft Agent Framework se integrează nativ cu OpenTelemetry. Mai jos este un exemplu de instrumentare a unui agent MAF:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
Notebook-ul exemplu din acest capitol va demonstra cum să-ți instrumentezi agentul MAF.
Crearea manuală a intervalelor: Deși bibliotecile de instrumentare oferă o bază bună, sunt adesea cazuri când este nevoie de informații mai detaliate sau personalizate. Poți crea manual intervale pentru a adăuga logică personalizată în aplicație. Mai mult, poți îmbogăți intervalele create automat sau manual cu atribute personalizate (cunoscute și ca etichete sau metadate). Aceste atribute pot include date specifice afacerii, calcule intermediare sau orice context util pentru depanare sau analiză, cum ar fi user_id, session_id, sau model_version.
Exemplu de creare manuală a urmăririlor și intervalelor cu Langfuse Python SDK:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
Evaluarea agenților
Observabilitatea ne oferă metrice, dar evaluarea este procesul de analiză a acestor date (și efectuarea de teste) pentru a determina cât de bine performează un agent AI și cum poate fi îmbunătățit. Cu alte cuvinte, odată ce ai urmăririle și metricele, cum le folosești pentru a judeca agentul și a lua decizii?
Evaluarea regulată este importantă deoarece agenții AI sunt adesea non-deterministici și pot evolua (prin actualizări sau schimbarea comportamentului modelului) – fără evaluare, nu ai ști dacă „agentul inteligent” își face bine treaba sau dacă a regresat.
Există două categorii de evaluări pentru agenții AI: evaluare online și evaluare offline. Ambele sunt valoroase și se completează reciproc. De obicei începem cu evaluarea offline, fiind pasul minim necesar înainte de a implementa orice agent.
Evaluare offline
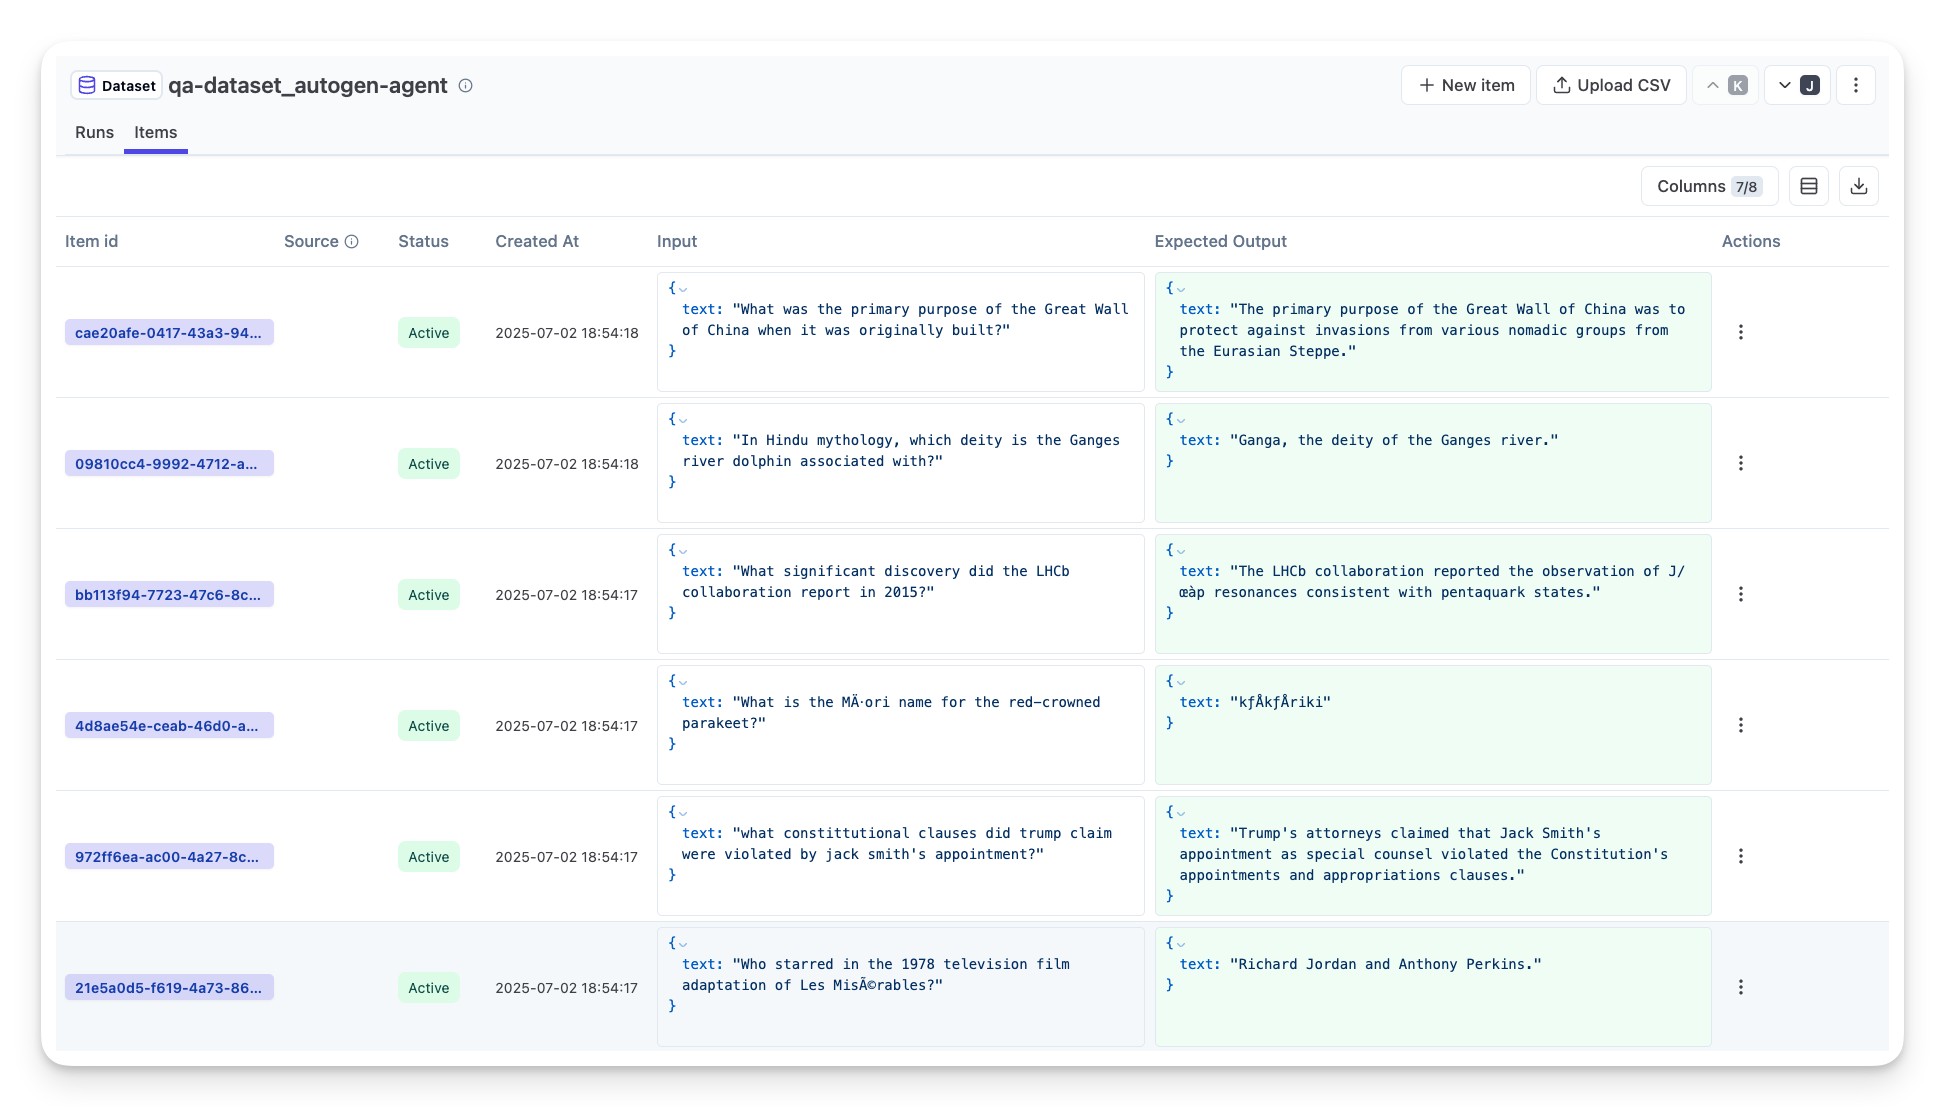
Aceasta implică evaluarea agentului într-un mediu controlat, de obicei folosind seturi de date de test, nu interogări reale ale utilizatorilor. Folosești seturi de date curate unde știi care este rezultatul așteptat sau comportamentul corect și apoi rulezi agentul pe acestea.
De exemplu, dacă ai construit un agent pentru probleme matematice, ai putea avea un set de date de test cu 100 de probleme cu răspunsuri cunoscute. Evaluarea offline se face adesea în timpul dezvoltării (și poate fi parte a pipe-linelor CI/CD) pentru a verifica îmbunătățiri sau a preveni regresii. Avantajul este că este repetabilă și poți obține metrice clare de acuratețe deoarece ai adevărul de referință. Poți de asemenea simula întrebări de utilizator și măsura răspunsurile agentului față de răspunsuri ideale sau folosi metrice automate așa cum s-a descris mai sus.
Provocarea cheie la evaluarea offline este asigurarea că setul tău de date de test este cuprinzător și rămâne relevant – agentul poate performa bine pe un set fix de teste, dar întâmpină interogări foarte diferite în producție. Prin urmare, ar trebui să ții seturile de teste actualizate cu cazuri noi și exemple care reflectă scenarii din lumea reală. Un mix de cazuri mici pentru „smoke test” și seturi mai mari de evaluare este util: seturi mici pentru verificări rapide și altele mai mari pentru metrici de performanță mai largi.
Evaluare online
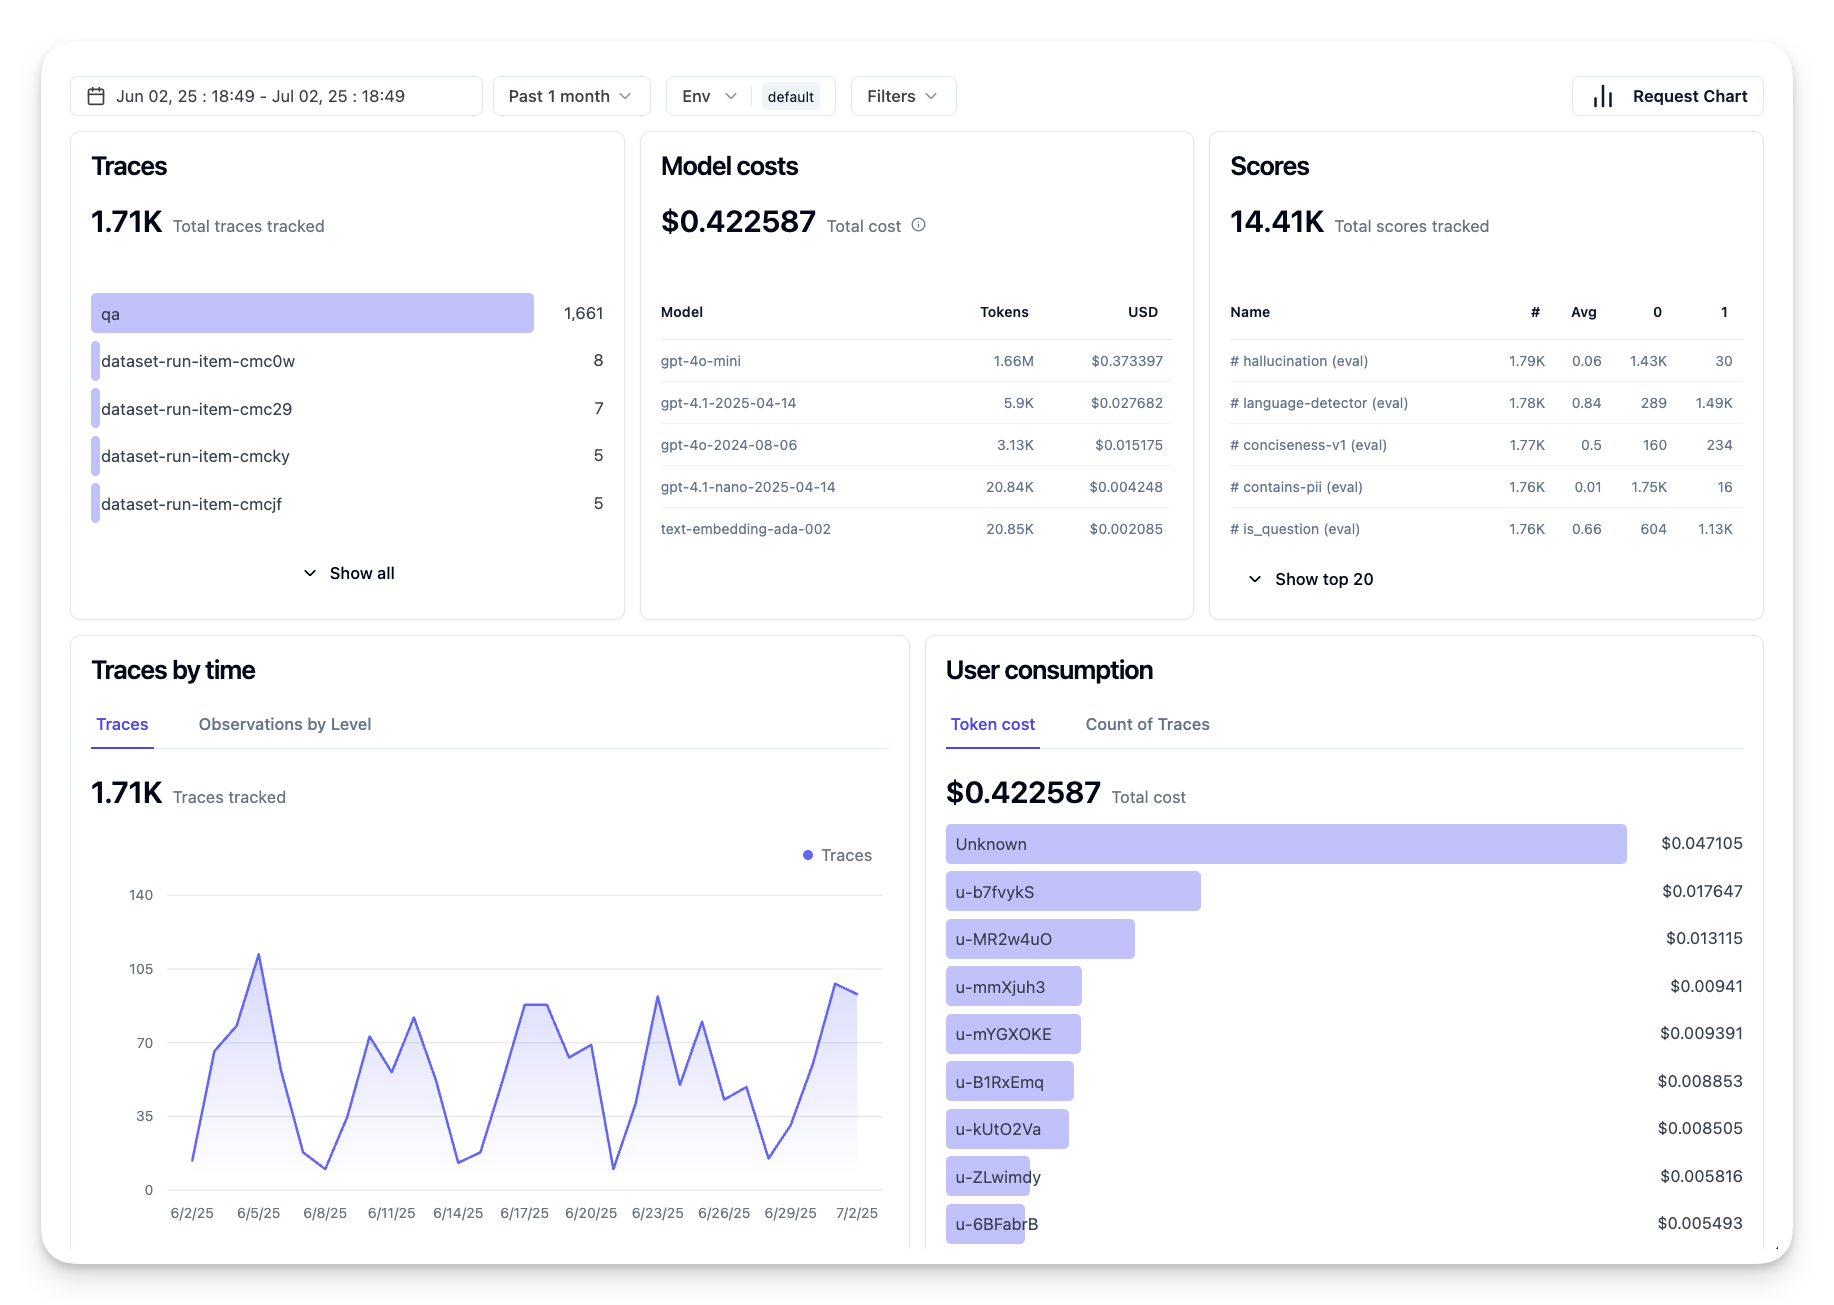
Aceasta se referă la evaluarea agentului într-un mediu live, real, adică în timpul utilizării reale în producție. Evaluarea online implică monitorizarea performanței agentului în interacțiunile reale cu utilizatorii și analiza continuă a rezultatelor.
De exemplu, poți urmări ratele de succes, scorurile de satisfacție ale utilizatorilor sau alte metrice din traficul live. Avantajul evaluării online este că prinde lucruri pe care nu le-ai putea anticipa într-un laboratior – poți observa deriva modelului în timp (dacă eficacitatea agentului scade pe măsură ce modelele de intrare se schimbă) și surprinde interogări neașteptate sau situații care nu erau în datele tale de test. Oferă o imagine adevărată a modului în care agentul se comportă în condiții reale.
Evaluarea online implică adesea colectarea feedback-ului implicit și explicit al utilizatorilor, după cum s-a discutat, și poate include efectuarea de teste shadow sau A/B (unde o versiune nouă a agentului rulează paralel pentru comparație cu versiunea veche). Provocarea este că poate fi dificil să obții etichete sau scoruri fiabile pentru interacțiunile live – s-ar putea să te bazezi pe feedback-ul utilizatorilor sau pe metricile downstream (de ex. dacă utilizatorul a făcut click pe rezultat).
Combinarea celor două
Evaluările online și offline nu se exclud reciproc; sunt complementare. Informațiile din monitorizarea online (ex. noi tipuri de interogări unde agentul performează slab) pot fi folosite pentru a îmbunătăți și suplimenta seturile de teste offline. Invers, agenții care performează bine în teste offline pot fi implementați cu mai multă încredere și monitorizați online.
De fapt, multe echipe adoptă o buclă:
evaluare offline -> implementare -> monitorizare online -> colectare de cazuri de eșec noi -> adăugare în setul offline -> rafinare agent -> repetă.
Probleme comune
Pe măsură ce implementezi agenți AI în producție, poți întâmpina diverse provocări. Iată câteva probleme comune și posibile soluții:
| Problemă | Soluție potențială |
|---|---|
| Agent AI care nu realizează sarcinile consecvent | - Perfecționează promptul oferit agentului AI; fii clar asupra obiectivelor. - Identifică dacă împărțirea sarcinilor în sub-sarcini și gestionarea lor de către mai mulți agenți poate ajuta. |
| Agentul AI intră în bucle continue | - Asigură-te că ai termeni și condiții clare de terminare astfel încât agentul să știe când să oprească procesul. - Pentru sarcini complexe care necesită raționament și planificare, folosește un model mai mare specializat în sarcini de raționament. |
| Apelurile către instrumentele agentului AI nu funcționează bine | - Testează și validează ieșirea instrumentului în afara sistemului agent. - Perfecționează parametrii definiți, prompturile și denumirea instrumentelor. |
| Sistem multi-agent care nu funcționează consecvent | - Perfecționează prompturile pentru fiecare agent pentru a te asigura că sunt specifice și distincte unul față de altul. - Construiește un sistem ierarhic folosind un agent de „rutare” sau controler pentru a determina care agent este cel corect. |
Multe dintre aceste probleme pot fi identificate mai eficient cu observabilitatea activă. Urmările și metricele discutate anterior ajută la localizarea exactă a punctelor problematice din fluxul agentului, făcând depanarea și optimizarea mult mai eficiente.
Gestionarea costurilor
Iată câteva strategii pentru a gestiona costurile implementării agenților AI în producție:
Folosirea modelelor mai mici: Modelele mici de limbaj (SLM) pot performa bine în anumite cazuri agentice și vor reduce semnificativ costurile. După cum am menționat mai devreme, construirea unui sistem de evaluare pentru a determina și compara performanța față de modelele mai mari este cea mai bună metodă de a înțelege cât de bine va performa un SLM pentru cazul tău de utilizare. Ia în considerare folosirea SLM-urilor pentru sarcini mai simple, cum ar fi clasificarea intențiilor sau extragerea parametrilor, în timp ce păstrezi modelele mai mari pentru raționamente complexe.
Folosirea unui model router: O strategie similară este să folosești o diversitate de modele și dimensiuni. Poți utiliza un LLM/SLM sau o funcție serverless pentru a direcționa cererile în funcție de complexitate către modelele cele mai potrivite. Acest lucru va ajuta, de asemenea, la reducerea costurilor, asigurând în același timp performanță la sarcinile potrivite. De exemplu, direcționează întrebările simple către modele mai mici, mai rapide și folosește modelele mari și costisitoare numai pentru sarcini complexe de raționament.
Cache-uirea răspunsurilor: Identificarea cererilor și a sarcinilor comune și oferirea răspunsurilor înainte ca acestea să treacă prin sistemul tău agentic este o metodă bună de a reduce volumul cererilor similare. Poți chiar implementa un flux pentru a identifica cât de asemănătoare este o cerere cu cererile tale cache-uite folosind modele AI mai simple. Această strategie poate reduce semnificativ costurile pentru întrebările frecvente sau fluxurile de lucru comune.
Să vedem cum funcționează asta în practică
În notebook-ul exemplu din această secțiune, vom vedea exemple despre cum putem folosi unelte de observabilitate pentru a monitoriza și evalua agentul nostru.
Ai mai multe întrebări despre Agenții AI în producție?
Alătură-te Microsoft Foundry Discord pentru a întâlni alți cursanți, a participa la orele de consultații și a-ți rezolva întrebările despre Agenții AI.
Lecția precedentă
Pattern-ul de design Metacognition
Lecția următoare
Declinare a responsabilității: Acest document a fost tradus folosind serviciul de traducere AI Co-op Translator. În timp ce ne străduim pentru acuratețe, vă rugăm să rețineți că traducerile automate pot conține erori sau inexactități. Documentul original în limba sa nativă trebuie considerat sursa autorizată. Pentru informații critice, se recomandă traducerea profesională realizată de un om. Nu ne asumăm responsabilitatea pentru eventualele neînțelegeri sau interpretări greșite care decurg din utilizarea acestei traduceri.