ai-agents-for-beginners
AI agenti v produkcii: pozorovateľnosť a hodnotenie
Ako AI agenti prechádzajú z experimentálnych prototypov do reálnych aplikácií, stáva sa dôležitou schopnosť porozumieť ich správaniu, sledovať ich výkon a systematicky vyhodnocovať ich výstupy.
Ciele učenia
Po absolvovaní tejto lekcie budete vedieť/pochopíte:
- Základné koncepty pozorovateľnosti a hodnotenia agentov
- Techniky na zlepšenie výkonu, nákladov a efektívnosti agentov
- Čo a ako systematicky hodnotiť vašich AI agentov
- Ako kontrolovať náklady pri nasadzovaní AI agentov do produkcie
- Ako instrumentovať agentov vybudovaných s Microsoft Agent Framework
Cieľom je vybaviť vás znalosťami, aby ste vedeli premeniť vaše “čierne skrinky” agentov na transparentné, spravovateľné a spoľahlivé systémy.
Poznámka: Je dôležité nasadzovať AI agentov, ktorí sú bezpeční a dôveryhodní. Pozrite si tiež lekciu Budovanie dôveryhodných AI agentov.
Trasy a span-y
Nástroje na pozorovateľnosť ako Langfuse alebo Microsoft Foundry zvyčajne predstavujú behy agentov ako trasy a span-y.
- Trasa (Trace) predstavuje kompletnú úlohu agenta od začiatku do konca (napríklad spracovanie používateľského dopytu).
- Span-y sú jednotlivé kroky v trase (napríklad volanie jazykového modelu alebo získavanie dát).
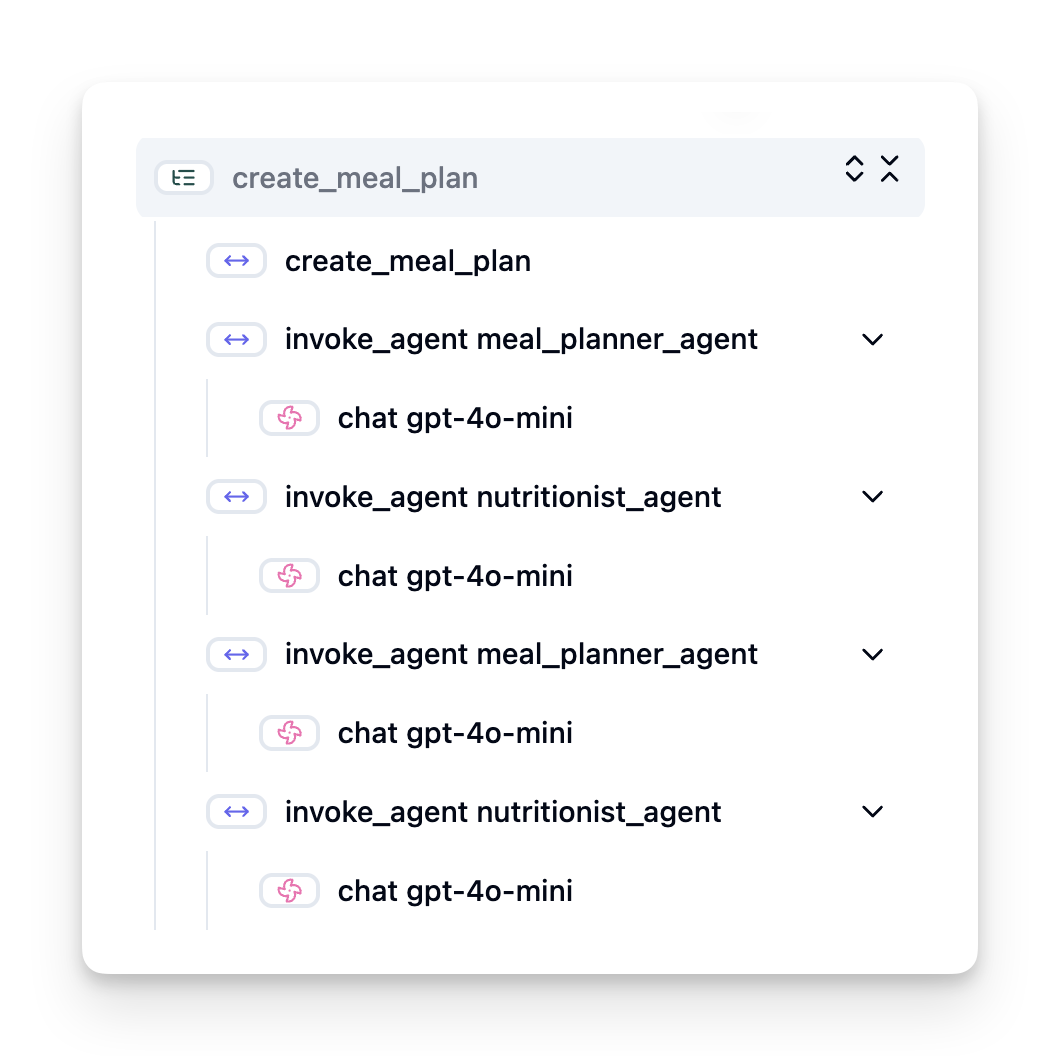
Bez pozorovateľnosti môže AI agent pôsobiť ako “čierna skrinka” - jeho vnútorný stav a uvažovanie sú nepriehľadné, čo sťažuje diagnostiku problémov alebo optimalizáciu výkonu. S pozorovateľnosťou sa agenti stávajú “sklenenými skrinkami”, ktoré ponúkajú transparentnosť nevyhnutnú na budovanie dôvery a zabezpečenie správnej prevádzky.
Prečo je pozorovateľnosť dôležitá v produkčných prostrediach
Prechod AI agentov do produkcie prináša novú sadu výziev a požiadaviek. Pozorovateľnosť už nie je “len pekná vlastnosť”, ale kľúčová schopnosť:
- Ladenie a analýza príčin problémov: Keď agent zlyhá alebo vyprodukuje neočakávaný výstup, nástroje pozorovateľnosti poskytujú trasy potrebné na lokalizáciu zdroja chyby. Toto je obzvlášť dôležité pri zložitých agentoch, ktoré môžu využívať viacnásobné volania LLM, interakcie s nástrojmi a podmienenú logiku.
- Riadenie latencie a nákladov: AI agenti často využívajú LLM a iné externé API, ktoré sú účtované za token alebo volanie. Pozorovateľnosť umožňuje presné sledovanie týchto volaní, pomáhajúc identifikovať operácie, ktoré sú príliš pomalé alebo nákladné. Tímu to umožňuje optimalizovať prompt-y, vybrať efektívnejšie modely alebo prepracovať pracovné toky na riadenie nákladov a zabezpečenie dobrého používateľského zážitku.
- Dôvera, bezpečnosť a súlad: V mnohých aplikáciách je dôležité zabezpečiť bezpečné a etické správanie agentov. Pozorovateľnosť poskytuje auditnú stopu akcií a rozhodnutí agenta. Túto stopu môžete využiť na detekciu a zmiernenie problémov, ako je injektovanie promptov, generovanie škodlivého obsahu alebo nesprávne zaobchádzanie s osobnými údajmi (PII). Napríklad môžete skontrolovať trasy, aby ste pochopili, prečo agent poskytol určitú odpoveď alebo použil konkrétny nástroj.
- Kontinuálne zlepšovanie: Dáta z pozorovateľnosti sú základom iteratívneho vývojového procesu. Monitorovaním výkonu agentov v reálnom svete môžu tímy identifikovať oblasti na zlepšenie, zbierať dáta na doladenie modelov a overovať dopady zmien. To vytvára spätnú väzbu, kde produkčné poznatky z online hodnotenia informujú offline experimentovanie a vylepšovanie, čo vedie k postupne lepšiemu výkonu agentov.
Kľúčové metriky na sledovanie
Na monitorovanie a pochopenie správania agenta je potrebné sledovať rôzne metriky a signály. Hoci sa špecifické metriky môžu líšiť v závislosti od účelu agenta, niektoré sú univerzálne dôležité.
Tu je niekoľko najčastejších metrík, ktoré nástroje na pozorovateľnosť monitorujú:
Latencia: Ako rýchlo agent odpovedá? Dlhé čakacie doby negatívne ovplyvňujú používateľský zážitok. Mali by ste merať latenciu pre úlohy a jednotlivé kroky sledovaním behov agenta. Napríklad agent, ktorý na všetky volania modelu potrebuje 20 sekúnd, by mohol byť zrýchlený použitím rýchlejšieho modelu alebo paralelným spustením volaní modelu.
Náklady: Aké sú náklady na jeden beh agenta? AI agenti využívajú LLM volania účtované za token alebo externé API. Časté používanie nástrojov alebo viacnásobné prompt-y môžu rýchlo zvýšiť náklady. Napríklad ak agent volá LLM päťkrát pre marginálne zlepšenie kvality, musíte zhodnotiť, či je to oprávnené, alebo či by ste mohli znížiť počet volaní alebo použiť lacnejší model. Monitorovanie v reálnom čase tiež pomáha identifikovať neočakávané špicatá zvýšenia (napr. chyby spôsobujúce nadmerné API slučky).
Chyby požiadaviek: Koľko požiadaviek agent nezvládol? Môže to zahŕňať chyby API alebo neúspešné volania nástrojov. Pre zvýšenie odolnosti vášho agenta v produkcii môžete nastaviť náhradné riešenia alebo opakovania. Napríklad ak poskytovateľ LLM A je nedostupný, prejdete na poskytovateľa B ako zálohu.
Používateľská spätná väzba: Implementácia priameho hodnotenia používateľmi prináša cenné poznatky. Môže ísť o explicitné hodnotenia (👍páči/👎nepáči, ⭐1-5 hviezdičiek) alebo textové komentáre. Konzistentná negatívna spätná väzba by vás mala upozorniť, pretože je to znak, že agent nefunguje podľa očakávaní.
Implicitná používateľská spätná väzba: Používateľské správanie poskytuje nepriamu spätnú väzbu aj bez explicitného hodnotenia. Môže ísť o okamžité preformulovanie otázky, opakované dopyty alebo kliknutie na tlačidlo opakovania. Napríklad ak vidíte, že používatelia opakovane kladú tú istú otázku, je to znak, že agent nefunguje podľa očakávaní.
Presnosť: Ako často agent produkuje správne alebo želané výstupy? Definície presnosti sa líšia (napr. správnosť riešenia problémov, presnosť vyhľadávania informácií, spokojnosť používateľa). Prvým krokom je definovať, čo pre váš agent znamená úspech. Presnosť môžete sledovať pomocou automatizovaných kontrol, hodnotení alebo označovania dokončenia úloh. Napríklad označovanie trás ako “úspešné” alebo “neúspešné”.
Automatizované hodnotiace metriky: Môžete tiež nastaviť automatizované hodnotenia. Napríklad môžete použiť LLM na ohodnotenie výstupu agenta, či je užitočný, presný alebo nie. Existuje tiež niekoľko open source knižníc, ktoré pomáhajú hodnotiť rôzne aspekty agenta. Napríklad RAGAS pre RAG agentov alebo LLM Guard na detekciu škodlivého jazyka alebo injekcie promptov.
V praxi poskytuje kombinácia týchto metrik najlepšiu pokrytie zdravotného stavu AI agenta. V príkladovom notebooku v tejto kapitole vám ukážeme, ako tieto metriky vyzerajú na reálnych príkladoch, ale najprv sa naučíme, ako vyzerá typický pracovný postup hodnotenia.
Instrumentujte svojho agenta
Na zber údajov o trasovaní budete musieť instrumentovať svoj kód. Cieľom je instrumentovať kód agenta tak, aby emitoval trasy a metriky, ktoré môžu byť zachytené, spracované a vizualizované na pozorovateľnej platforme.
OpenTelemetry (OTel): OpenTelemetry sa stalo priemyselným štandardom pre pozorovateľnosť LLM. Poskytuje sadu API, SDK a nástrojov na generovanie, zber a export telemetrických dát.
Existuje mnoho knižníc na instrumentáciu, ktoré obalia existujúce rámce agentov a uľahčujú export OpenTelemetry span-ov do nástroja na pozorovateľnosť. Microsoft Agent Framework sa nativne integruje s OpenTelemetry. Nižšie je príklad instrumentácie agenta MAF:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
Príkladový notebook v tejto kapitole demonštruje, ako instrumentovať váš MAF agent.
Manuálne vytváranie span-ov: Kým knižnice na instrumentáciu poskytujú dobrý základ, často sú prípady, kde je potrebná podrobnejšia alebo vlastná informácia. Môžete manuálne vytvárať span-y pre pridanie vlastnej aplikačnej logiky. Významné je, že môžu obohacovať automaticky alebo manuálne vytvorené span-y vlastnými atribútmi (známymi aj ako tagy alebo metaúdaje). Tieto atribúty môžu obsahovať biznisovo špecifické dáta, medziľahlé výpočty alebo kontext, ktorý môže byť užitočný pri ladení alebo analýze, ako napríklad user_id, session_id alebo model_version.
Príklad manuálneho vytvárania trás a span-ov pomocou Langfuse Python SDK:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
Hodnotenie agenta
Pozorovateľnosť nám poskytuje metriky, ale hodnotenie je proces analýzy týchto dát (a vykonávania testov), ktorým určujeme, ako dobre AI agent funguje a ako by sa mohol zlepšiť. Inými slovami, akonáhle máte tieto trasy a metriky, ako ich použijete na posúdenie agenta a rozhodovanie?
Pravidelné hodnotenie je dôležité, pretože AI agenti často nie sú deterministickí a môžu sa vyvíjať (prostredníctvom aktualizácií alebo posunu správania modelu) – bez hodnotenia by ste nevedeli, či váš „chytrý agent“ skutočne plní svoju úlohu dobre alebo či sa zhoršil.
Existujú dve kategórie hodnotení pre AI agentov: online hodnotenie a offline hodnotenie. Obe sú cenné a navzájom sa dopĺňajú. Zvyčajne začíname offline hodnotením, pretože je to minimálny potrebný krok pred nasadením akéhokoľvek agenta.
Offline hodnotenie
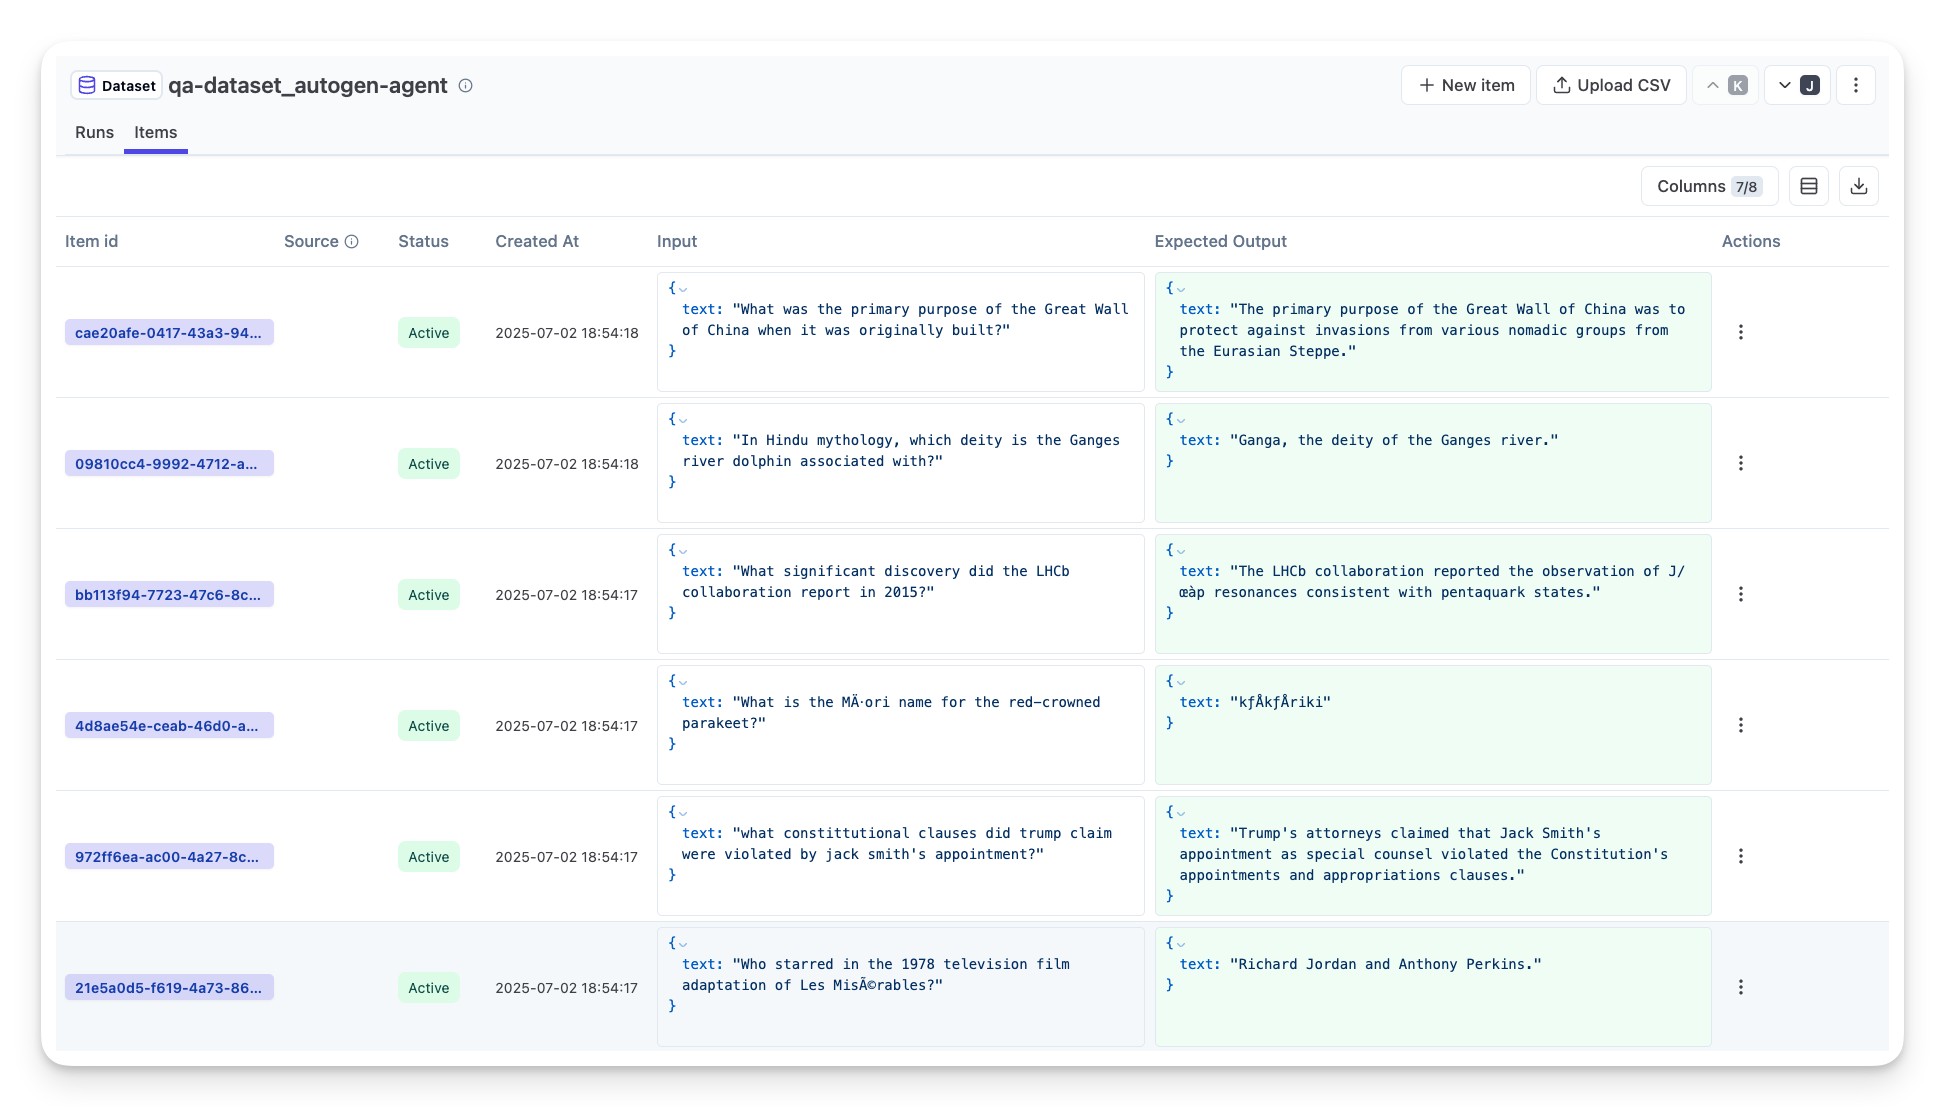
Toto zahŕňa hodnotenie agenta v kontrolovanom prostredí, zvyčajne s použitím testovacích datasetov, nie živých používateľských dopytov. Používate starostlivo vybrané datasety, kde viete, aký je očakávaný výstup alebo správne správanie, a potom na nich spustíte agenta.
Napríklad, ak ste vytvorili agenta na riešenie slovných matematických úloh, môžete mať testovací dataset 100 úloh so známymi odpoveďami. Offline hodnotenie sa často vykonáva počas vývoja (a môže byť súčasťou CI/CD pipeline) na kontrolu zlepšení alebo ochranu proti regresiám. Výhodou je, že je opakované a môžete dostať jasné metriky presnosti, pretože máte referenčnú pravdu. Môžete tiež simulovať používateľské dopyty a merať odpovede agenta oproti ideálnym odpovediam alebo použiť automatizované metriky, ako bolo popísané vyššie.
Kľúčovou výzvou pri offline hodnotení je zabezpečiť, aby bol váš testovací dataset komplexný a zostával relevantný – agent môže vykazovať dobrý výkon na pevnom testovacom sete, ale v produkcii sa stretnúť s veľmi odlišnými dopytmi. Preto by ste mali testovacie sety aktualizovať o nové hraničné prípady a príklady, ktoré odrážajú reálne scenáre. Miešanie malých “smoke test” prípadov a väčších evaluačných setov je užitočné: malé sety na rýchle kontroly a väčšie na širšie výkonnostné metriky.
Online hodnotenie
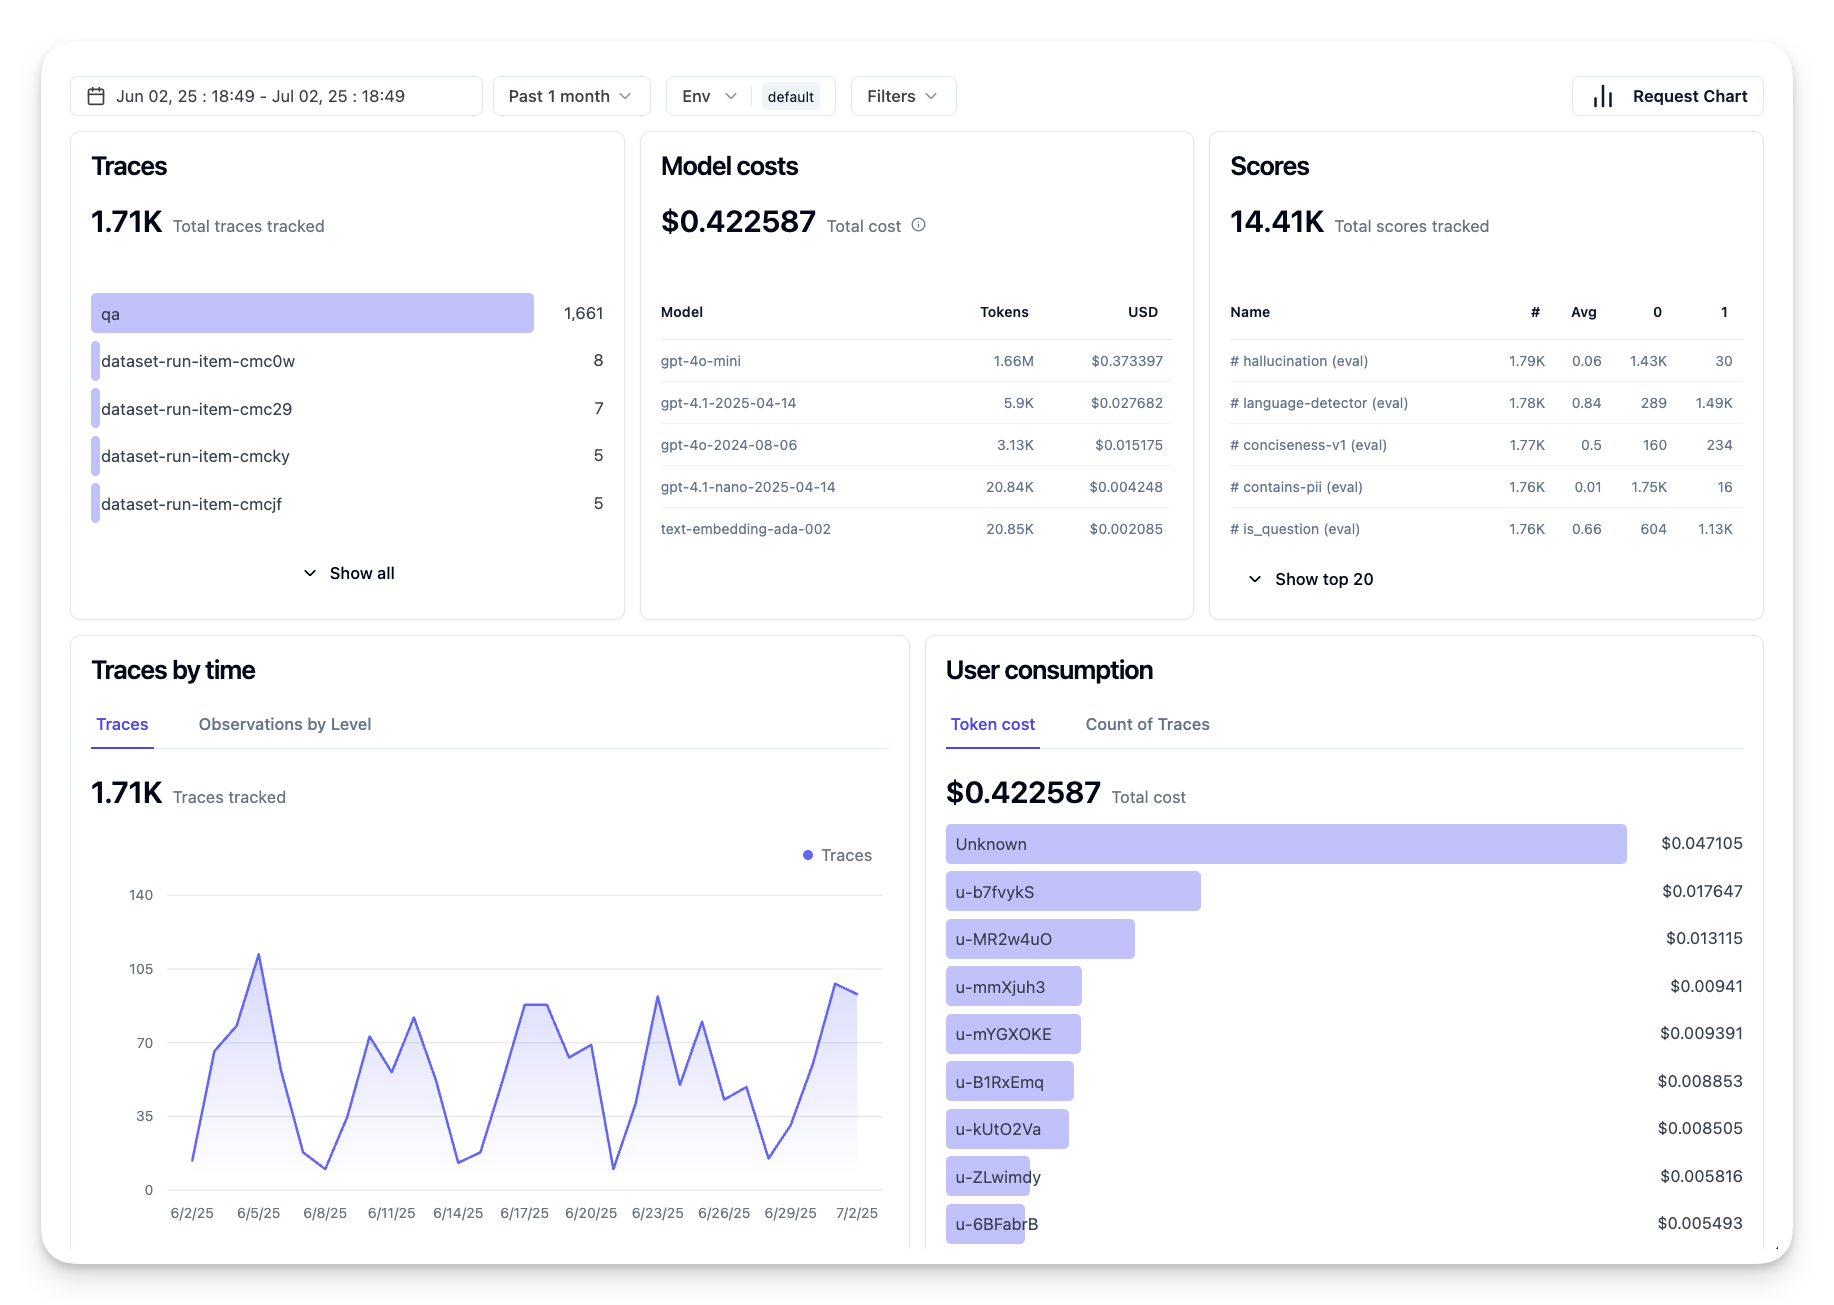
Toto sa vzťahuje na hodnotenie agenta v živom reálnom prostredí, teda počas skutočného používania v produkcii. Online hodnotenie zahŕňa sledovanie výkonu agenta pri reálnych interakciách používateľov a neustálu analýzu výsledkov.
Napríklad môžete sledovať úspešnosť, skóre spokojnosti používateľov alebo iné metriky na živom prevádzkovom toku. Výhodou online hodnotenia je, že zachytáva veci, ktoré by ste v laboratórnom nastavení nemuseli predvídať – môžete pozorovať posun modelu v čase (ak účinnosť agenta klesá s meniacimi sa vstupnými vzormi) a zachytiť neočakávané dopyty či situácie, ktoré v testovacích dátach neboli. Poskytuje skutočný obraz o správaní agenta v reálnom svete.
Online hodnotenie často zahŕňa zber implicitnej i explicitnej spätnej väzby od používateľov, ako aj prípadné spúšťanie shadow testov alebo A/B testov (kde nová verzia agenta beží paralelne pre porovnanie s predchádzajúcou). Výzvou je získať spoľahlivé označenia alebo skóre pre živé interakcie – často sa spoliehate na používateľskú spätnú väzbu alebo následné metriky (napr. či používateľ klikol na výsledok).
Kombinácia oboch
Online a offline hodnotenia nie sú výlučné; navzájom sa výborne dopĺňajú. Poznatky z online monitorovania (napr. nové typy používateľských dopytov, kde agent nevykazuje dobrý výkon) môžu byť využité na rozšírenie a zlepšenie offline testovacích datasetov. Naopak, agenti, ktorí dobre fungujú v offline testoch, môžu byť následne s väčšou dôverou nasadzovaní a monitorovaní online.
Mnohé tímy v skutočnosti prijímajú tento cyklus:
offline hodnotenie -> nasadenie -> online monitorovanie -> zbieranie nových prípadov zlyhaní -> pridanie do offline datasetu -> doladenie agenta -> opakovanie.
Bežné problémy
Pri nasadzovaní AI agentov do produkcie môžete naraziť na rôzne výzvy. Tu sú niektoré bežné problémy a ich možné riešenia:
| Problém | Možné riešenie |
|---|---|
| AI agent nevykonáva úlohy konzistentne | - Vylepšiť prompt daný AI agentovi; byť jasný v cieľoch. - Určiť, kde môže pomôcť rozdelenie úloh na podúlohy a ich spracovanie viacerými agentmi. |
| AI agent sa dostane do nekonečných slučiek | - Zabezpečiť jasné podmienky ukončenia, aby agent vedel, kedy proces zastaviť. - Pre komplexné úlohy vyžadujúce uvažovanie a plánovanie použiť väčší model špecializovaný na rozumové úlohy. |
| Volania nástrojov AI agenta nevykazujú dobrý výkon | - Testovať a validovať výstupy nástrojov mimo systému agenta. - Vylepšiť definované parametre, prompt-y a pomenovania nástrojov. |
| Viacagentový systém nefunguje konzistentne | - Vylepšiť prompt-y pre jednotlivých agentov, aby boli špecifické a odlišné. - Vytvoriť hierarchický systém s “routingovým” alebo kontrolným agentom, ktorý určí správneho agenta. |
Mnohé z týchto problémov je možné efektívnejšie identifikovať pomocou pozorovateľnosti. Trasy a metriky, o ktorých sme už hovorili, pomáhajú presne lokalizovať miesto problémov v pracovnom toku agenta, čo výrazne zefektívňuje ladenie a optimalizáciu.
Riadenie nákladov
Tu sú niektoré stratégie na riadenie nákladov pri nasadzovaní AI agentov do produkcie:
Používanie menších modelov: Malé jazykové modely (SLM) môžu dobre fungovať pri niektorých agentových prípadoch použitia a výrazne znížia náklady. Ako bolo spomenuté vyššie, najlepším spôsobom, ako pochopiť, ako dobre bude SLM fungovať vo vašom prípade použitia, je vybudovať hodnotiaci systém na určenie a porovnanie výkonu oproti väčším modelom. Zvážte použitie SLM pre jednoduchšie úlohy, ako je klasifikácia zámerov alebo extrakcia parametrov, zatiaľ čo väčšie modely si nechajte na zložité uvažovanie.
Použitie modelu smerovača: Podobnou stratégiou je používanie rôznych modelov a veľkostí. Môžete využiť LLM/SLM alebo serverless funkciu na smerovanie požiadaviek podľa zložitosti na najvhodnejšie modely. To tiež pomôže znížiť náklady a zároveň zabezpečiť výkon pri správnych úlohách. Napríklad jednoduché dotazy smerujte na menšie, rýchlejšie modely a nákladné veľké modely používajte len na zložité úlohy uvažovania.
Kešovanie odpovedí: Identifikácia bežných požiadaviek a úloh a poskytovanie odpovedí skôr, než prejdú vaším agentovým systémom, je dobrý spôsob, ako znížiť objem podobných požiadaviek. Môžete dokonca implementovať tok na identifikáciu, ako veľmi je požiadavka podobná vašim kešovaným požiadavkám pomocou základnejších AI modelov. Táto stratégia môže výrazne znížiť náklady pri často kladených otázkach alebo bežných pracovných postupoch.
Pozrime sa, ako to funguje v praxi
V príkladovom zošite tejto sekcie uvidíme príklady toho, ako môžeme použiť nástroje na pozorovateľnosť na sledovanie a vyhodnocovanie nášho agenta.
Máte ďalšie otázky o AI agentoch v produkcii?
Pridajte sa do Microsoft Foundry Discord a stretnite sa s ďalšími študentmi, zúčastnite sa hodín konzultácií a získajte odpovede na svoje otázky o AI agentoch.
Predchádzajúca lekcia
Nasledujúca lekcia
Vyhlásenie o zodpovednosti: Tento dokument bol preložený pomocou AI prekladateľskej služby Co-op Translator. Hoci sa snažíme o presnosť, vezmite prosím na vedomie, že automatické preklady môžu obsahovať chyby alebo nepresnosti. Pôvodný dokument v jeho natívnom jazyku by mal byť považovaný za autoritatívny zdroj. Pre kritické informácie sa odporúča profesionálny ľudský preklad. Nie sme zodpovední za žiadne nedorozumenia alebo nesprávne interpretácie vyplývajúce z použitia tohto prekladu.