ai-agents-for-beginners
AI агенти у продукцији: Опсервабилност и Евалуација
Како AI агенти прелазе из експерименталних прототипова у реалне примене, способност разумевања њиховог понашања, праћења њиховог учинка и систематског вредновања њихових резултата постаје важна.
Циљеви учења
Након завршетка овог часа, знаћете како да/разумете:
- Основне концепте опсервабилности и евалуације агената
- Технике за побољшање перформанси, трошкова и ефикасности агената
- Шта и како систематски вредновати ваше AI агенте
- Како контролисати трошкове при имплементацији AI агената у продукцију
- Како инструментализовати агенте изграђене помоћу Microsoft Agent Framework-а
Циљ је да вас опремимо знањем како да трансформишете своје „црне кутије“ агенте у транспарентне, управљиве и поуздане системе.
Напомена: Важно је примењивати AI агенте који су безбедни и поуздани. Погледајте и лекцију Изградња поузданих AI агената.
Трагови и Спенс
Алати за опсервабилност као што су Langfuse или Microsoft Foundry обично представљају извршења агената као трагове и спенс.
- Траг представља комплетан задатак агента од почетка до краја (на пример, обрада корисничког упита).
- Спенс су појединачни кораци унутар трага (на пример, позивање језичког модела или преузимање података).
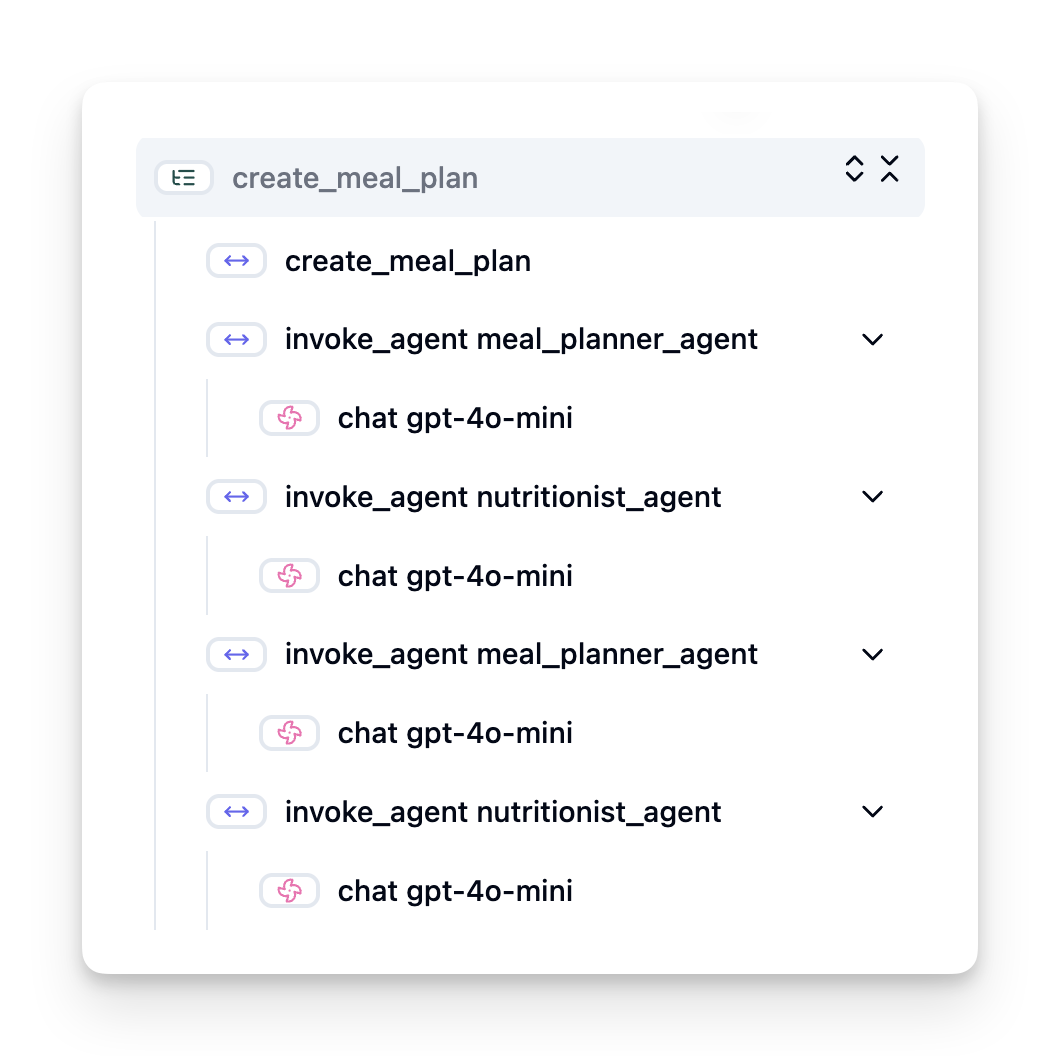
Без опсервабилности, AI агент може деловати као „црна кутија“ – његов унутрашњи статус и разлози су нејасни, што отежава дијагнозу проблема или оптимизацију учинка. Са опсервабилношћу, агенти постају „стаклене кутије“, нудећи транспарентност која је витална за изградњу поверења и осигуравање да функционишу како је дозвољено.
Зашто је опсервабилност важна у продукционим окружењима
Прелазак AI агената у продукциона окружења уводи нови скуп изазова и захтева. Опсервабилност више није „пожељна“ већ критична способност:
- Дебаговање и Анализа корена проблема: Када агент не успе или произведе неочекивани резултат, алати за опсервабилност пружају трагове потребне за идентификовање извора грешке. Ово је посебно важно код сложених агената који могу укључивати више позива LLM, интеракцију са алатима и условну логику.
- Управљање латенцијом и трошковима: AI агенти често зависе од LLM и других спољашњих API-ја који се наплаћују по токену или позиву. Опсервабилност омогућава прецизно праћење ових позива, помажући у идентификовању операција које су прекомерно споре или скупе. Ово омогућава тимовима да оптимизују упите, одаберу ефикасније моделе или редизајнирају токове рада како би управљали оперативним трошковима и осигурали добар кориснички доживљај.
- Пoвeрeњe, бeзбeднoст и усклaђeнoст: У многим применама је важно да агенти понашају безбедно и етички. Опсервабилност пружа аудиторски траг акција и одлука агента. Ово се може користити за откривање и ублажавање проблема као што су убацивање упита, генерисање штетног садржаја или неправилно руковање лично идентификационим информацијама (PII). На пример, можете прегледати трагове да разумете зашто је агент дао одређени одговор или користио одређени алат.
- Континуиране петље побољшања: Податци опсервабилности су основа итеративног развојног процеса. Праћењем перформанси агената у реалном свету, тимови могу идентификовати области за побољшање, прикупити податке за фино подешавање модела и проверити утицај измена. Ово ствара повратну петљу где увиди из продукције из онлајн евалуације информишу офлајн експериментацију и дораду, што води ка постепено бољим перформансама агента.
Кључне метрике за праћење
Да бисте пратили и разумели понашање агента, треба пратити низ метрика и сигнала. Иако специфичне метрике могу варирати у зависности од сврхе агента, неке су универзално важне.
Ево неких од најчешћих метрика које алати за опсервабилност прате:
Латенција: Колико брзо агент одговара? Дуга времена чекања негативно утичу на корисничко искуство. Треба мерити латенцију за задатке и појединачне кораке праћењем извршења агента. На пример, агент који сва позива модела обави за 20 секунди може се убрзати коришћењем бржег модела или паралелним извршавањем позива модела.
Трошкови: Колика је цена по извршењу агента? AI агенти зависе од LLM позива који се наплаћују по токену или спољашњим API-јима. Честа употреба алата или више упита може брзо повећати трошкове. На пример, ако агент пет пута позива LLM ради маргиналног побољшања квалитета, мора се проценити да ли је трошак оправдан или да ли се број позива може смањити или користити јефтинији модел. Праћење у реалном времену може помоћи у откривању непредвиђених скокова (нпр. багови који узрокују прекомерне API петље).
Грешке захтева: Колико захтева је агент није успео да обради? Ово може укључивати API грешке или неуспеле позиве алата. Да бисте свој агент учинили робуснијим у продукцији, можете поставити резервне механизме или поновне покушаје. На пример, ако LLM добављач А није доступан, прелазите на добављача Б као резерву.
Кориснички повратни информације: Имплементација директних корисничких евалуација пружа вредне увиде. Ово може укључивати експлицитне оцене (👍палац горе/👎доле, ⭐1-5 звездица) или текстуалне коментаре. Конзистентно негативне повратне информације треба да вас упозоре јер су знак да агент не ради како је очекивано.
Индиректне корисничке повратне информације: Понашања корисника пружају индиректне повратне информације чак и без експлицитних оцена. Ово може укључивати тренутно преобликовање питања, понављање упита или кликање на дугме за поновни покушај. На пример, ако видите да корисници више пута постављају исто питање, то је знак да агент не ради како је очекивано.
Тачност: Колико често агент производи исправне или жељене резултате? Дефиниције тачности се разликују (нпр. исправност решавања проблема, тачност информационог проналажења, задовољство корисника). Први корак је дефинисати шта успех значи за вашег агента. Тачност можете мерити аутоматизованим провером, оценама евалуације или ознакама завршетка задатка. На пример, означавањем трагова као „успешно“ или „неуспешно“.
Аутоматизоване метрике евалуације: Такође можете поставити аутоматизоване евалуације. На пример, можете користити LLM за оцењивање излаза агента, нпр. да ли је користан, тачан или није. Постоје и бројне open-source библиотеке које вам помажу да оцењујете различите аспекте агента. Нпр. RAGAS за RAG агенте или LLM Guard за детекцију штетног језика или убацивања упита.
У пракси, комбинација ових метрика даје најбољи преглед здравља AI агента. У овом поглављу у примеру ноутбука показаћемо вам како ове метрике изгледају у реалним примерима, али најпре ћемо научити како типичан процес евалуације изгледа.
Инструментализација вашег агента
Да бисте прикупили податке о праћењу, мораћете да инструментализујете ваш код. Циљ је да инструментализујете код агента да емитује трагове и метрике које може да ухвати, обради и визуелизује платформа за опсервабилност.
OpenTelemetry (OTel): OpenTelemetry постао је индустријски стандард за опсервабилност LLM. Пружа сет API-ја, SDK-а и алата за генерисање, прикупљање и извоз телеметријских података.
Постоји много библиотека за инструментализацију које обавијају постојеће фрејмворке агената и олакшавају извоз OpenTelemetry спенсова у алате за опсервабилност. Microsoft Agent Framework се нативно интегрише са OpenTelemetry. Испод је пример инструментализације MAF агента:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
У примеру ноутбука овог поглавља показаћемо како да инструментализујете свог MAF агента.
Ручно креирање спенсова: Док библиотеке за инструментализацију пружају добру основу, често су потребни детаљнији или прилагођени подаци. Можете ручно креирати спенсове да бисте додали прилагођену апликациону логику. Штавише, они могу обогатити аутоматски или ручно креиране спенсове прилагођеним атрибутима (познатим као тагови или метаподаци). Ови атрибути могу укључивати пословне специфичне податке, посредне прорачуне или било који контекст који може бити користан при дебаговању или анализи, као што су user_id, session_id, или model_version.
Пример мануелног креирања трагова и спенсова са Langfuse Python SDK:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
Евалуација агента
Опсервабилност нам даје метрике, али евалуација је процес анализе тих података (и извођења тестова) да се утврди колико добро AI агент ради и како може бити побољшан. Другим речима, када имате те трагове и метрике, како их користите да оцењујете агента и доносите одлуке?
Редовна евалуација је важна јер AI агенти често нису детерминистички и могу еволуирати (кроз ажурирања или промене понашања модела) – без евалуације не бисте знали да ли ваш „паметни агент“ заиста добро ради свој посао или је регресирао.
Постоје две категорије евалуација за AI агенте: онлајн евалуација и офлајн евалуација. Обе су вредне и допуњују се. Обично почнемо са офлајн евалуацијом, јер је то минимални неопходан корак пре употребе било ког агента у продукцији.
Офлајн евалуација
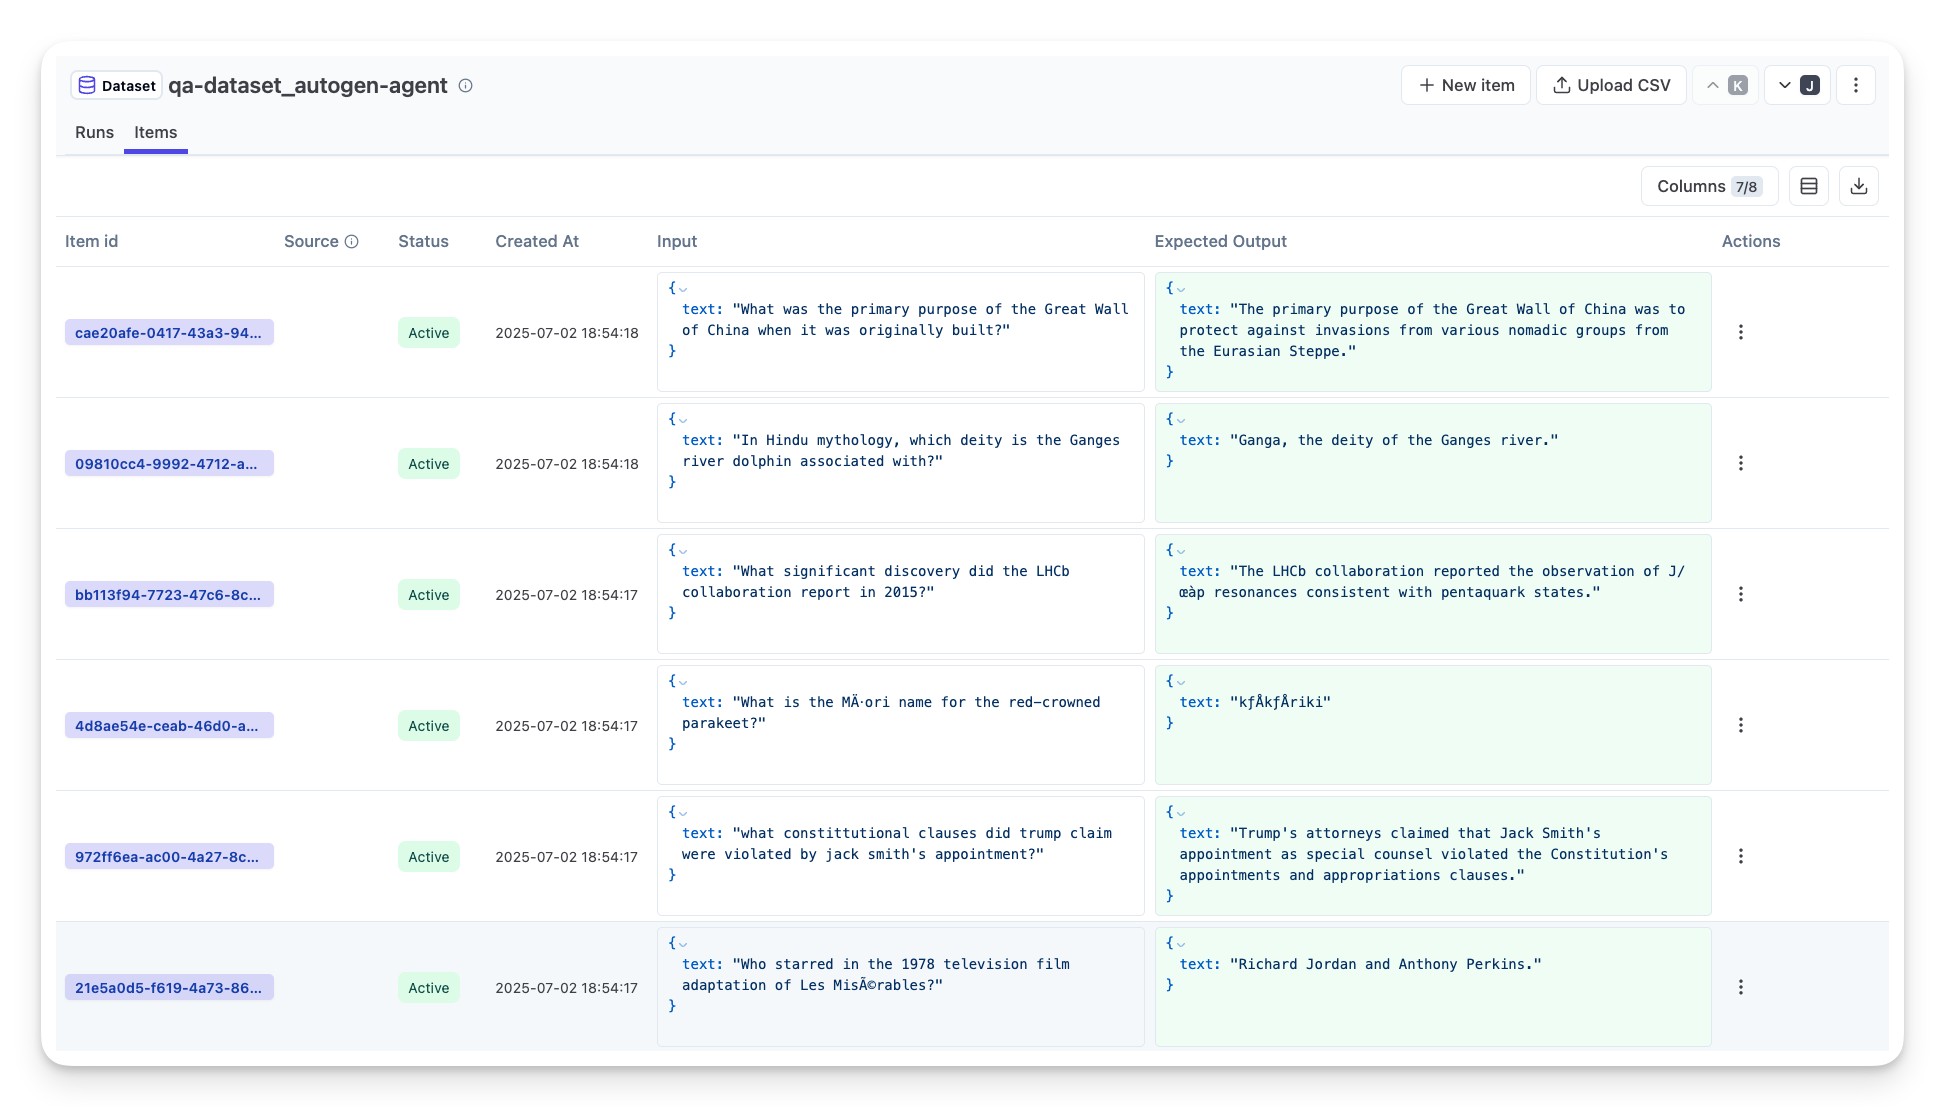
Ово подразумева вредновање агента у контролисаном окружењу, обично коришћењем тест датасетова, а не живих корисничких упита. Користите куративне датасете где знате шта је очекивани излаз или исправно понашање, и онда покрећете агента на тим скупинама.
На пример, ако сте изградили агента за решавање математичких речених задатака, можете имати тест скуп података од 100 задатака са познатим одговорима. Офлајн евалуација се често ради током развоја (и може бити део CI/CD цевовода) ради провере побољшања или заштите од регресија. Предност је што је поновљива и даје јасне метрике тачности јер имате ground truth. Такође можете симулирати корисничке упите и мерити одговоре агента у односу на идеалне одговоре или користити аутоматизоване метрике као што је описано горе.
Кључни изазов офлајн евалуације је обезбедити да ваш тест скуп буде свеобухватан и да остане релевантан – агент може добро радити на фиксном тест сету али у продукцији се сусрести са веома другачијим упитима. Због тога треба држати тест сетове ажурираним са новим ивичним случајевима и примерима који одражавају стварне сценарије. Погодна је комбинација малих „смок тест“ случајева и већих скупина за евалуацију: мали сетови за брзу проверу и већи за шире метрике перформанси.
Онлајн евалуација
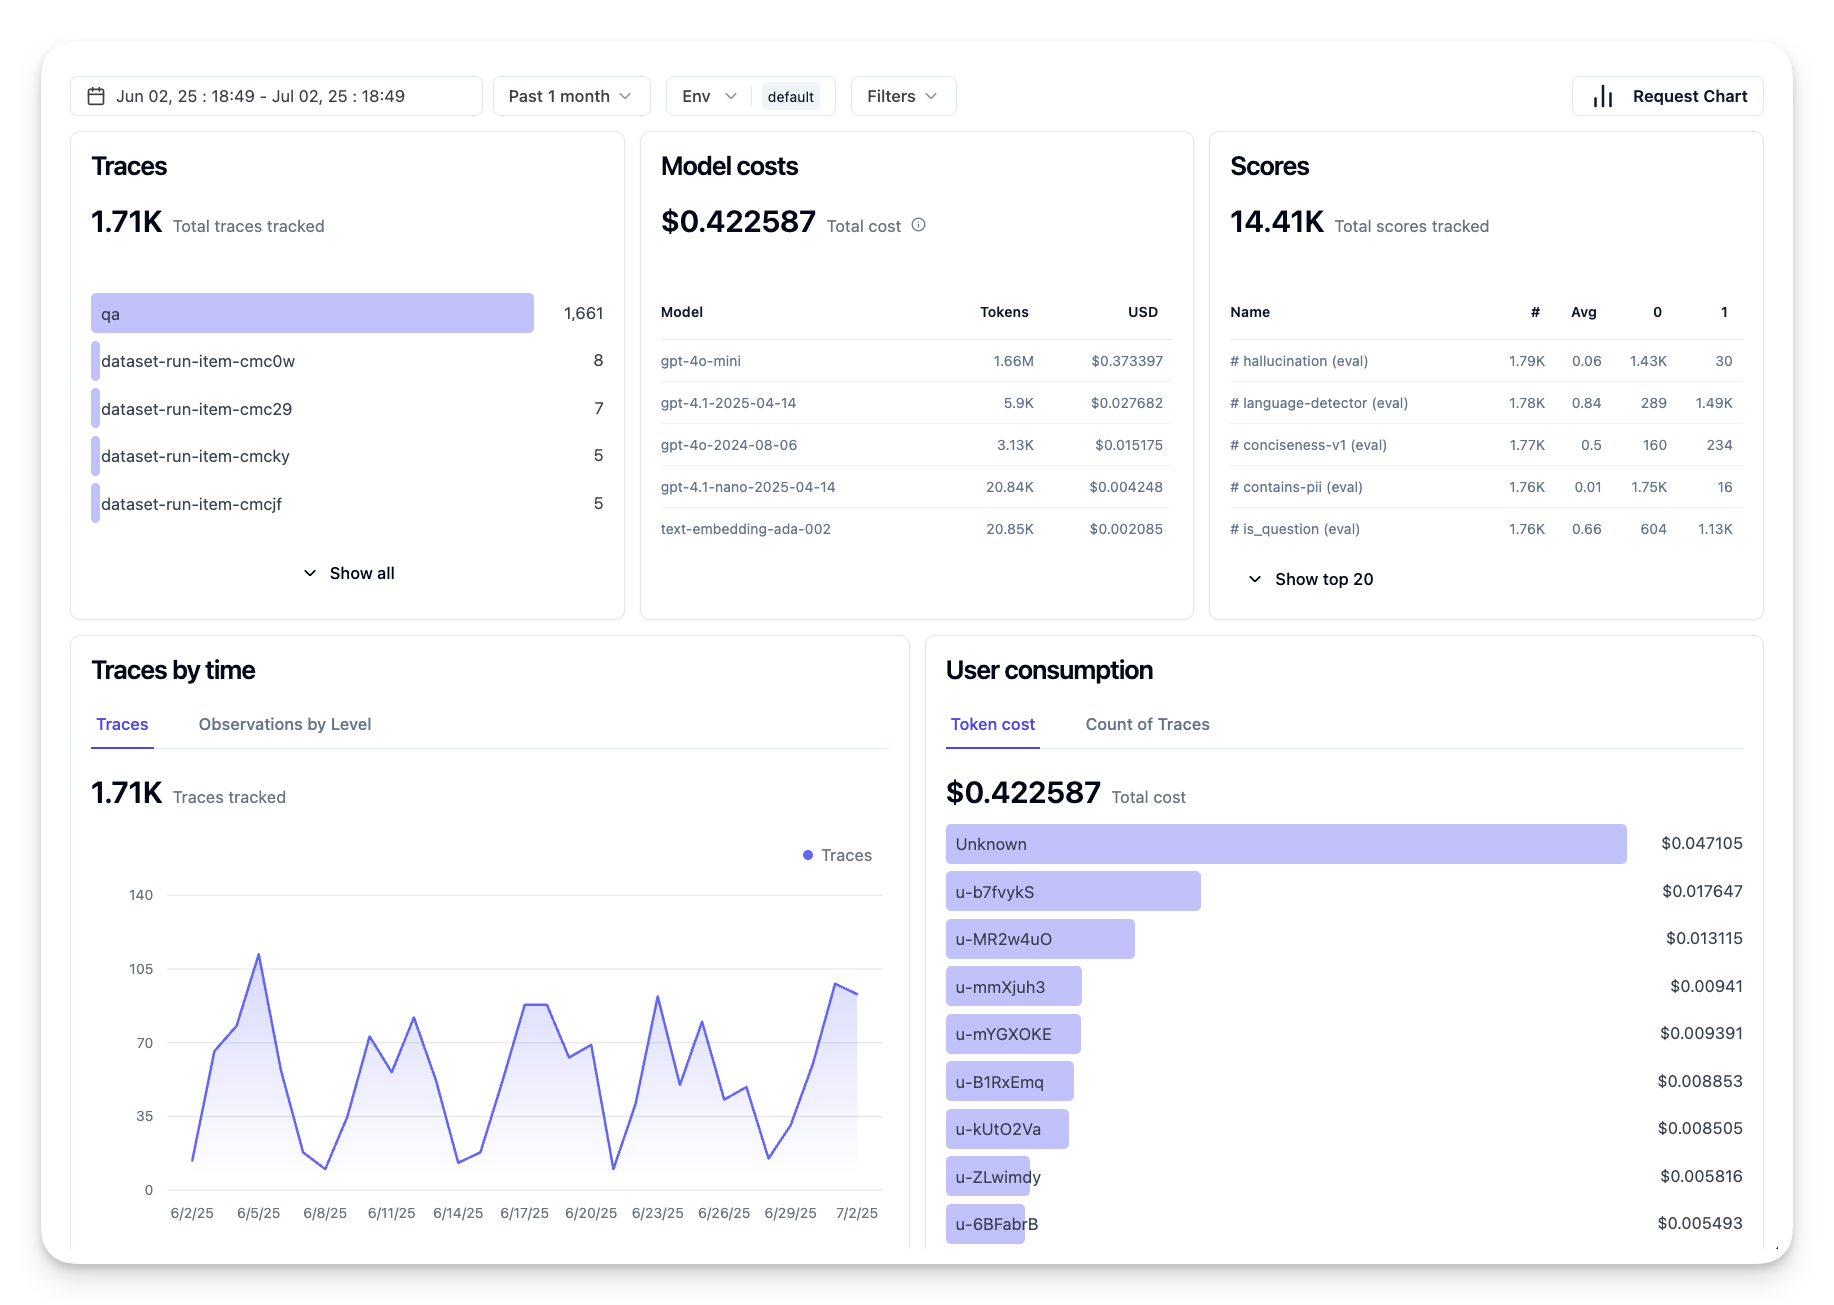
Ово се односи на вредновање агента у живом, реалном окружењу, тј. током стварне употребе у продукцији. Онлајн евалуација подразумева праћење перформанси агента на реалним корисничким интеракцијама и континуирано анализирање резултата.
На пример, можете пратити стопе успеха, оцену задовољства корисника или друге метрике на живом саобраћају. Предност онлајн евалуације је што ухвата ствари које не бисте могли предвидети у лабораторијским условима – можете посматрати померање модела током времена (ако ефикасност агента опада како се промене узорци уноса) и ухватити неочекиване упите или ситуације које нису биле у вашем тест датасету. Оне пружају истиниту слику како се агент понаша у стварном свету.
Онлајн евалуација често укључује прикупљање индиректних и експлицитних корисничких повратних информација, као што је раније објашњено, и могуће извођење сјенкастих или A/B тестова (где нова верзија агента ради паралелно ради упоређења са старом). Изазов је што може бити тешко добити поуздане ознаке или оцене за живе интеракције – можда ћете се ослањати на повратне информације корисника или метрике из изворних података (нпр. да ли је корисник кликнуо на резултат).
Комбинација два приступа
Онлајн и офлајн евалуације нису међусобно искључујуће; веома се допуњују. Увиди из онлајн праћења (нпр. нове врсте корисничких упита где агент слабо ради) могу се користити за допуну и побољшање офлајн тест датасета. Супротно, агенти који добро раде у офлајн тестовима могу онда бити са више поверења имплементирани и праћени онлајн.
Заправо, многи тимови усвајају петљу:
евалуација офлајн -> имплементација -> праћење онлајн -> прикупљање нових неуспелих случајева -> додавање офлајн датасету -> доношење измена агента -> понављање.
Уобичајени проблеми
При имплементацији AI агената у продукцију можете наићи на различите изазове. Ево неких уобичајених проблема и потенцијалних решења:
| Проблем | Потенцијално решење |
|---|---|
| AI агент не изводи задатке доследно | - Унапредите упит (prompt) дат AI агенту; будите јасни у циљевима. - Идентификујте где делити задатке на подзадатке и обрадити их са више агената може помоћи. |
| AI агент упада у непрекидне петље | - Осигурајте јасне услове за завршетак тако да агент зна када да заврши процес. - За сложене задатке који захтевају размишљање и планирање, користите већи модел специјализован за задатке резоновања. |
| Позиви алатима AI агента не раде добро | - Тестирајте и верификујте излаз алата ван агената. - Унапредите дефинисане параметре, упите и именовање алата. |
| Мулти-Агент систем не ради доследно | - Унапредите упите дате сваком агенту да буду специфични и различити. - Изградите хијерархијски систем користећи „рутирање“ или контролни агент да одреди који је агент исправан. |
Многи од ових проблема се могу ефикасније идентификовати ако постоји опсервабилност. Трагови и метрике о којима смо говорили помажу у прецизном проналажењу места у радном току агената где долази до проблема, што чини дебаговање и оптимизацију много ефикаснијим.
Управљање трошковима
Ево неких стратегија за управљање трошковима имплементације AI агената у продукцију:
Коришћење мањих модела: Мали језички модели (SLMs) могу добро функционисати у одређеним агентским случајевима употребе и значајно ће смањити трошкове. Као што је раније поменуто, изградња система за евалуацију који ће одредити и упоредити перформансе у односу на веће моделе је најбољи начин да се схвати колико добро ће SLM функционисати у вашем случају употребе. Размотрите коришћење SLM-ова за једноставније задатке као што су класификација намера или извлачење параметара, док резервишете веће моделе за сложено размишљање.
Коришћење рутирајућег модела: Слична стратегија је коришћење шире лепезе модела и величина. Можете користити LLM/SLM или серверлес функцију да рутирате захтеве на основу сложености ка најприкладнијим моделима. Ово такође помаже у смањењу трошкова уз обезбеђивање перформанси на правим задацима. На пример, рутирајте једноставне упите ка мањим, бржим моделима, и користите скупе велике моделе само за сложене задатке размишљања.
Кеширање одговора: Идентификовање уобичајених захтева и задатака и пружање одговора пре него што прођу кроз ваш агентски систем је добар начин да се смањи обим сличних захтева. Можете чак имплементирати ток који идентификује колико је захтев сличан вашим кешираним захтевима користећи једноставније AI моделе. Ова стратегија може значајно смањити трошкове за често постављана питања или уобичајене радне токове.
Хајде да видимо како ово функционише у пракси
У примеру бележнице из овог одељка, видећемо примере како можемо користити алате за посматрање и евалуацију нашег агента.
Имате још питања о AI агентима у продукцији?
Придружите се Microsoft Foundry Discord да упознате друге учеснике, присуствујете радним часовима и добијете одговоре на ваша питања о AI агентима.
Претходна лекција
Следећа лекција
Изјава о одрицању одговорности: Овај документ је преведен коришћењем услуге за аутоматски превод Co-op Translator. Иако тежимо тачности, имајте у виду да аутоматски преводи могу садржати грешке или нетачности. Оригинални документ на његовом изворном језику треба сматрати ауторитативним извором. За критичне информације препоручује се професионални људски превод. Нисмо одговорни за било каква неспоразума или погрешна тумачења која произилазе из коришћења овог превода.