ai-agents-for-beginners
پیداوار میں AI ایجنٹس: نگرانی اور جائزہ
جیسے جیسے AI ایجنٹس تجرباتی نمونوں سے حقیقی دنیا کی ایپلیکیشنز کی طرف بڑھتے ہیں، ان کے رویے کو سمجھنے، ان کی کارکردگی کی نگرانی کرنے، اور ان کے نتائج کا منظم جائزہ لینے کی صلاحیت اہمیت اختیار کر جاتی ہے۔
سیکھنے کے مقاصد
اس سبق کو مکمل کرنے کے بعد، آپ جانیں گے کہ/how سمجھیں گے:
- ایجنٹ کی نگرانی اور جائزہ کے بنیادی تصورات
- ایجنٹس کی کارکردگی، لاگت اور مؤثریت کو بہتر بنانے کی تکنیکیں
- اپنے AI ایجنٹس کا منظم طریقے سے جائزہ لینے کا کیا اور کیسے
- پیداوار میں AI ایجنٹس کے تعیناتی کے دوران لاگتوں کو کنٹرول کیسے کیا جائے
- Microsoft Agent Framework سے بنے ایجنٹس کو انسٹرومنٹ کرنے کا طریقہ
مقصد یہ ہے کہ آپ کو علم سے لیس کیا جائے تاکہ آپ کے “بلیک باکس” ایجنٹس کو شفاف، قابلِ انتظام، اور قابلِ اعتماد نظام میں تبدیل کیا جا سکے۔
نوٹ: یہ اہم ہے کہ AI ایجنٹس کو محفوظ اور قابلِ اعتماد تناظر میں تعینات کیا جائے۔ اعتماد ساز AI ایجنٹس بنانے کا سبق بھی ملاحظہ کریں۔
ٹریسز اور اسپینز
نگرانی کے ٹولز جیسے Langfuse یا Microsoft Foundry عام طور پر ایجنٹ کے رنز کو ٹریس اور اسپین کے طور پر ظاہر کرتے ہیں۔
- ٹریس ایک مکمل ایجنٹ کام کی نمائندگی کرتا ہے شروع سے آخر تک (مثلاً، صارف کی استفسار کو سنبھالنا)۔
- اسپینز ٹریس کے اندر الگ الگ مراحل ہوتے ہیں (جیسے زبان کے ماڈل کو کال کرنا یا ڈیٹا بازیافت کرنا)۔
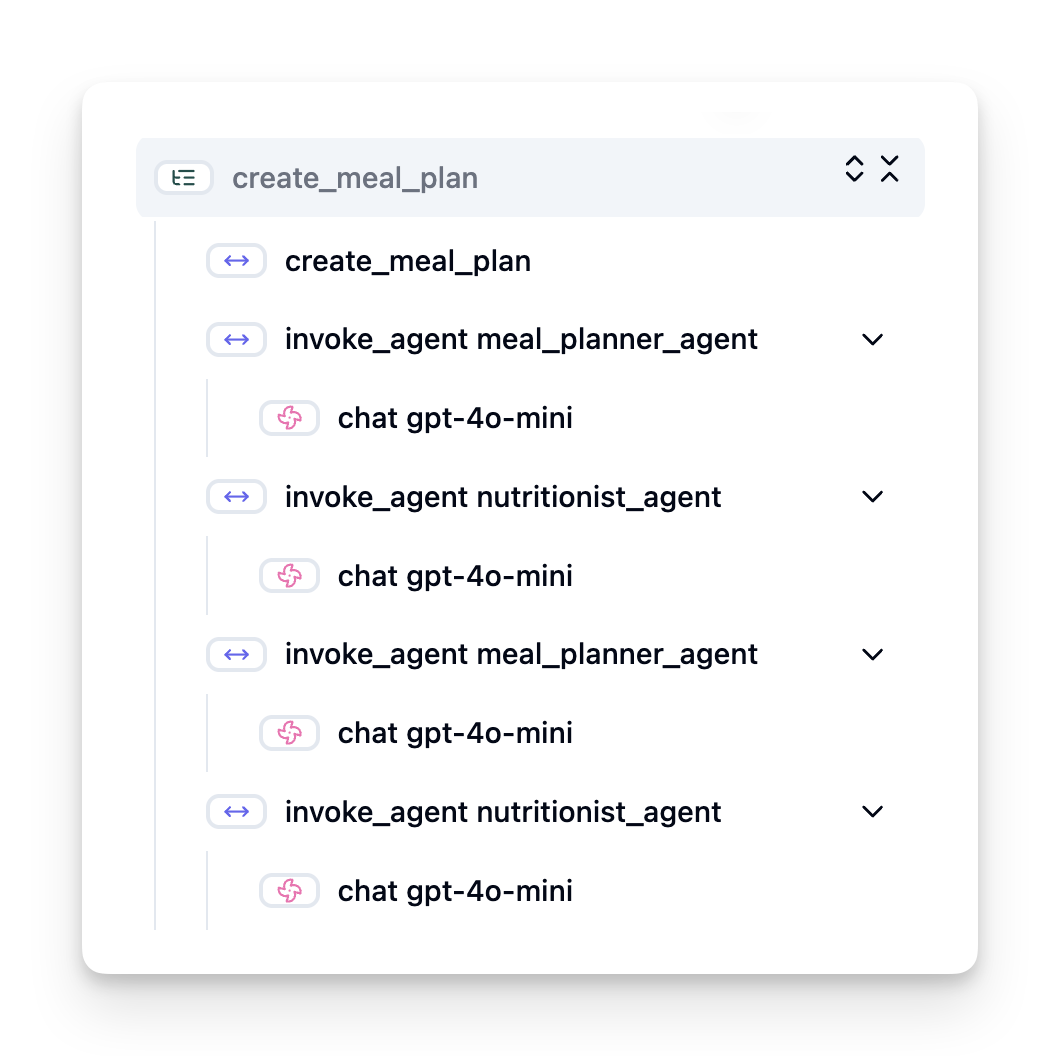
نگرانی کے بغیر، AI ایجنٹ “بلیک باکس” جیسا محسوس ہو سکتا ہے - اس کی داخلی حالت اور منطق مبہم ہوتی ہے، جس کی وجہ سے مسائل کی تشخیص یا کارکردگی کی بہتری مشکل ہو جاتی ہے۔ نگرانی کے ساتھ، ایجنٹس “گلاس باکس” بن جاتے ہیں، جو شفافیت فراہم کرتے ہیں جو اعتماد قائم کرنے اور ان کی متوقع طریقے سے کام کرنے کو یقینی بنانے کے لیے لازمی ہے۔
پیداوار کے ماحول میں نگرانی کی اہمیت کیوں ہے
AI ایجنٹس کو پیداوار کے ماحول میں منتقل کرنے سے نئی چیلنجز اور ضروریات سامنے آتی ہیں۔ نگرانی اب صرف “اچھا ہو” نہیں بلکہ ایک اہم صلاحیت ہے:
- خرابی کی جانچ اور جڑ کی وجہ کا تجزیہ: جب ایجنٹ ناکام ہو یا غیر متوقع نتیجہ دے، نگرانی کے ٹولز وہ ٹریس فراہم کرتے ہیں جو غلطی کے ماخذ کی نشاندہی کرتے ہیں۔ یہ خاص طور پر پیچیدہ ایجنٹس کے لیے اہم ہے جن میں کثیر LLM کالز، ٹولز کی انٹرایکشن اور شرطی منطق شامل ہو سکتی ہے۔
- تاخیر اور لاگت کا نظم: AI ایجنٹس اکثر LLMs اور دیگر بیرونی APIs پر انحصار کرتے ہیں جو فی ٹوکن یا فی کال بل کیے جاتے ہیں۔ نگرانی ان کالز کا درست سراغ لگانے کی اجازت دیتی ہے، جو سست یا مہنگی آپریشن کو شناخت کرنے میں مدد دیتی ہے۔ اس سے ٹیموں کو پرامپٹس کو بہتر بنانے، مؤثر ماڈلز منتخب کرنے، یا ورک فلو کو دوبارہ ڈیزائن کرنے میں مدد ملتی ہے تاکہ آپریشنز کی لاگت کنٹرول کی جا سکے اور اچھا صارف تجربہ یقینی بنایا جا سکے۔
- اعتماد، حفاظت، اور تعمیل: کئی ایپلیکیشنز میں یہ ضروری ہے کہ ایجنٹس محفوظ اور اخلاقی طرز عمل کریں۔ نگرانی ایجنٹ کی کارروائیوں اور فیصلوں کا آڈٹ ٹریل فراہم کرتی ہے۔ یہ مسائل جیسے پرامپٹ انجیکشن، نقصان دہ مواد کی تخلیق، یا ذاتی شناخت کے قابل معلومات (PII) کے غلط ہینڈلنگ کو پکڑنے اور کم کرنے کے لیے استعمال ہو سکتی ہے۔ مثال کے طور پر، آپ ٹریسز کا جائزہ لے سکتے ہیں کہ ایجنٹ نے کوئی مخصوص جواب کیوں دیا یا کسی خاص ٹول کا استعمال کیوں کیا۔
- مسلسل بہتری کے سلسلے: نگرانی کا ڈیٹا ایک تکراری ترقیاتی عمل کی بنیاد ہے۔ حقیقی دنیا میں ایجنٹس کی کارکردگی کی نگرانی کر کے ٹیمیں بہتری کے لیے جگہیں شناخت کر سکتی ہیں، ماڈلز کی فائن ٹوننگ کے لیے ڈیٹا جمع کر سکتی ہیں، اور تبدیلیوں کے اثرات کی تصدیق کر سکتی ہیں۔ یہ ایک فیڈبیک لوپ تخلیق کرتا ہے جہاں آن لائن جائزے سے حاصل شدہ پیداواری بصیرت آف لائن تجربات اور بہتری کو مطلع کرتی ہے، جس سے ایجنٹس کی کارکردگی میں مسلسل بہتری آتی ہے۔
اہم میٹرکس کی نگرانی
ایجنٹ کے رویے کی نگرانی اور سمجھ بوجھ کے لیے متعدد میٹرکس اور سگنلز کو ٹریک کیا جانا چاہیے۔ اگرچہ مخصوص میٹرکس ایجنٹ کے مقصد پر منحصر ہو سکتے ہیں، چند میٹرکس عالمی حیثیت رکھتے ہیں۔
نگرانی کے ٹولز جو کچھ عام میٹرکس مانیٹر کرتے ہیں وہ درج ذیل ہیں:
تاخیر: ایجنٹ کتنی تیزی سے جواب دیتا ہے؟ طویل انتظار کا وقت صارف کے تجربے کو منفی طور پر متاثر کرتا ہے۔ آپ کو ایجنٹ رنز کی ٹریسنگ کے ذریعہ کاموں اور انفرادی مراحل کے لیے تاخیر کو ماپنا چاہیے۔ مثال کے طور پر، اگر کوئی ایجنٹ تمام ماڈل کالز کے لیے 20 سیکنڈ لیتا ہے، تو اسے تیز ماڈل استعمال کر کے یا ماڈل کالز کو متوازی چلانا کر تیز کیا جا سکتا ہے۔
لاگت: ایجنٹ کے ایک رن کی قیمت کیا ہے؟ AI ایجنٹس LLM کالز پر انحصار کرتے ہیں جنہیں فی ٹوکن بل کیا جاتا ہے یا بیرونی APIs کو۔ کثرت سے ٹول کے استعمال یا متعدد پرامپٹس لاگت کو تیزی سے بڑھا سکتے ہیں۔ مثال کے طور پر، اگر کسی ایجنٹ نے معمولی معیار کی بہتری کے لیے LLM کو پانچ بار کال کیا، تو آپ کو جائزہ لینا ہوگا کہ آیا یہ لاگت جائز ہے یا آپ کالز کی تعداد کم کر سکتے ہیں یا سستا ماڈل استعمال کر سکتے ہیں۔ حقیقی وقت کی نگرانی اچانک بڑھے ہوئے استعمال (جیسے بگز کی وجہ سے API لوپس) کی شناخت میں بھی مدد کر سکتی ہے۔
درخواست کی غلطیاں: ایجنٹ نے کتنی درخواستیں ناکام کیں؟ اس میں API کی غلطیاں یا ناکام ٹول کالز شامل ہو سکتی ہیں۔ پیداوار میں اپنے ایجنٹ کو ان کے خلاف زیادہ مضبوط بنانے کے لیے، آپ فالبیک یا ریٹری سیٹ اپ کر سکتے ہیں۔ مثال کے طور پر، اگر LLM فراہم کنندہ A بند ہے تو آپ بیک اپ کے طور پر LLM فراہم کنندہ B استعمال کر سکتے ہیں۔
صارف کی رائے: براہِ راست صارف کی تشخیصات لاجواب بصیرت فراہم کرتی ہیں۔ اس میں واضح درجہ بندی (👍تھمز اپ/👎نیچے، ⭐1-5 ستارے) یا متنی تبصرے شامل ہو سکتے ہیں۔ مستقل منفی رائے آپ کو خبردار کرے گی کیونکہ یہ اس بات کی علامت ہے کہ ایجنٹ توقع کے مطابق کام نہیں کر رہا۔
بالواسطہ صارف کی رائے: صارف کے رویے بلواسطہ فیڈبیک فراہم کرتے ہیں حتیٰ کہ واضح درجہ بندیاں نہ ہونے پر بھی۔ اس میں فوری سوال کی دوبارہ ترمیم، بار بار سوالات، یا ری ٹرائی بٹن پر کلک شامل ہو سکتے ہیں۔ مثال کے طور پر، اگر آپ دیکھیں کہ صارفین بار بار ایک ہی سوال پوچھ رہے ہیں، تو یہ اس بات کی علامت ہے کہ ایجنٹ توقع کے مطابق کام نہیں کر رہا۔
درستگی: ایجنٹ کتنی بار درست یا مطلوبہ نتائج پیدا کرتا ہے؟ درستگی کی تعریفیں مختلف ہو سکتی ہیں (مثلاً مسئلہ حل کرنے کی درستگی، معلومات بازیافت کی درستگی، صارف کی اطمینان)۔ پہلا قدم یہ ہے کہ آپ اپنے ایجنٹ کے لیے کامیابی کی تعریف کریں۔ آپ خودکار چیکس، جائزہ اسکورز، یا کام کی تکمیل کے لیبلز کے ذریعے درستگی ٹریک کر سکتے ہیں۔ مثال کے طور پر، ٹریسز کو “کامیاب” یا “ناکام” کے طور پر نشان زد کرنا۔
خودکار جائزہ میٹرکس: آپ خودکار جائزے بھی مرتب کر سکتے ہیں۔ مثال کے طور پر، آپ LLM کا استعمال کر کے ایجنٹ کے آؤٹ پٹ کی اسکورنگ کر سکتے ہیں مثلاً یہ مددگار، درست، یا نہیں ہے۔ متعدد اوپن سورس لائبریریاں بھی موجود ہیں جو ایجنٹ کے مختلف پہلوؤں کو اسکور کرنے میں مدد کرتی ہیں، مثلاً RAGAS RAG ایجنٹس کے لیے یا LLM Guard نقصان دہ زبان یا پرامپٹ انجیکشن کا پتہ لگانے کے لیے۔
عملی طور پر، ان میٹرکس کا مجموعہ AI ایجنٹ کی صحت کا بہترین احاطہ کرتا ہے۔ اس باب کے مثال نوٹ بک میں، ہم آپ کو دکھائیں گے کہ یہ میٹرکس حقیقی مثالوں میں کیسے نظر آتے ہیں لیکن پہلے ہم یہ سیکھیں گے کہ ایک عام جائزہ ورک فلو کیسا دکھائی دیتا ہے۔
اپنے ایجنٹ کو انسٹرومنٹ کریں
ٹریسنگ ڈیٹا جمع کرنے کے لیے، آپ کو اپنے کوڈ کو انسٹرومنٹ کرنے کی ضرورت ہے۔ مقصد یہ ہے کہ ایجنٹ کوڈ کو انسٹرومنٹ کرنا تاکہ ٹریسز اور میٹرکس جاری کرے جو نگرانی کے پلیٹ فارم کے ذریعے پکڑے، پراسیس، اور بصری بنائے جا سکیں۔
اوپن ٹیلی میٹری (OTel): اوپن ٹیلی میٹری نے LLM نگرانی کے لیے صنعت کا معیار قائم کیا ہے۔ یہ APIs، SDKs، اور ٹولز کا مجموعہ فراہم کرتا ہے جو ٹیلی میٹری ڈیٹا کی پیداوار، جمع، اور برآمد کرنے کے لیے استعمال ہوتے ہیں۔
کئی انسٹرومنٹیشن لائبریریاں موجود ہیں جو موجودہ ایجنٹ فریم ورک کو لپیٹ کر اسے آسانی سے نگرانی کے ٹول کو اوپن ٹیلی میٹری اسپینز برآمد کرنے کے قابل بناتی ہیں۔ Microsoft Agent Framework قدرتی طور پر اوپن ٹیلی میٹری سے انٹیگریٹ ہوتا ہے۔ نیچے MAF ایجنٹ کو انسٹرومنٹ کرنے کی ایک مثال ہے:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
اس باب کی مثال نوٹ بک میں، ہم دکھائیں گے کہ آپ اپنے MAF ایجنٹ کو کیسے انسٹرومنٹ کریں۔
ہاتھ سے اسپین کی تخلیق: اگرچہ انسٹرومنٹیشن لائبریریاں ایک اچھا بنیادی معیار فراہم کرتی ہیں، اکثر ایسے مواقع ہوتے ہیں جہاں مزید تفصیلی یا حسب ضرورت معلومات کی ضرورت ہوتی ہے۔ آپ خود اسپینز بنا سکتے ہیں تاکہ اپنی ایپلیکیشن لاجک شامل کر سکیں۔ سب سے اہم بات یہ ہے کہ وہ خودکار یا دستی طور پر بنائے گئے اسپینز کو حسب ضرورت خصوصیات (جنہیں ٹیگز یا میٹاڈیٹا بھی کہا جاتا ہے) کے ساتھ مالا مال کر سکتے ہیں۔ یہ خصوصیات کاروباری مخصوص ڈیٹا، درمیانی حساب، یا کوئی بھی ایسا سیاق و سباق شامل ہو سکتا ہے جو خرابی کی جانچ یا تجزیہ کے لیے مفید ہو، جیسے user_id, session_id, یا model_version۔
ہاتھ سے ٹریسز اور اسپینز بنانے کی مثال Langfuse Python SDK کے ساتھ:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
ایجنٹ کا جائزہ
نگرانی ہمیں میٹرکس دیتی ہے، لیکن جائزہ وہ عمل ہے جس میں ان ڈیٹا کا تجزیہ کیا جاتا ہے (اور ٹیسٹ کیے جاتے ہیں) تاکہ معلوم ہو کہ AI ایجنٹ کتنی اچھی کارکردگی دکھا رہا ہے اور اسے کیسے بہتر بنایا جا سکتا ہے۔ دوسرے الفاظ میں، جب آپ کے پاس وہ ٹریسز اور میٹرکس ہوں، تو آپ انہیں ایجنٹ کا فیصلہ کرنے اور فیصلے لینے کے لیے کیسے استعمال کرتے ہیں؟
باقاعدہ جائزہ اہم ہے کیونکہ AI ایجنٹس اکثر غیر متعین ہوتے ہیں اور (اپ ڈیٹس یا ماڈل کے رویے کی تبدیلی کے ذریعے) بدل سکتے ہیں – بغیر جائزے کے، آپ کو معلوم نہیں ہوگا کہ آپ کا “سمارٹ ایجنٹ” درحقیقت اپنا کام اچھی طرح کر رہا ہے یا اس کی کارکردگی خراب ہو چکی ہے۔
AI ایجنٹس کے لیے دو قسم کے جائزے ہیں: آن لائن جائزہ اور آف لائن جائزہ۔ دونوں قیمتی ہیں اور ایک دوسرے کی تکمیل کرتے ہیں۔ ہم عموماً آف لائن جائزے سے شروع کرتے ہیں، کیونکہ یہ کسی ایجنٹ کو تعینات کرنے سے پہلے کی کم از کم ضروری قدم ہے۔
آف لائن جائزہ
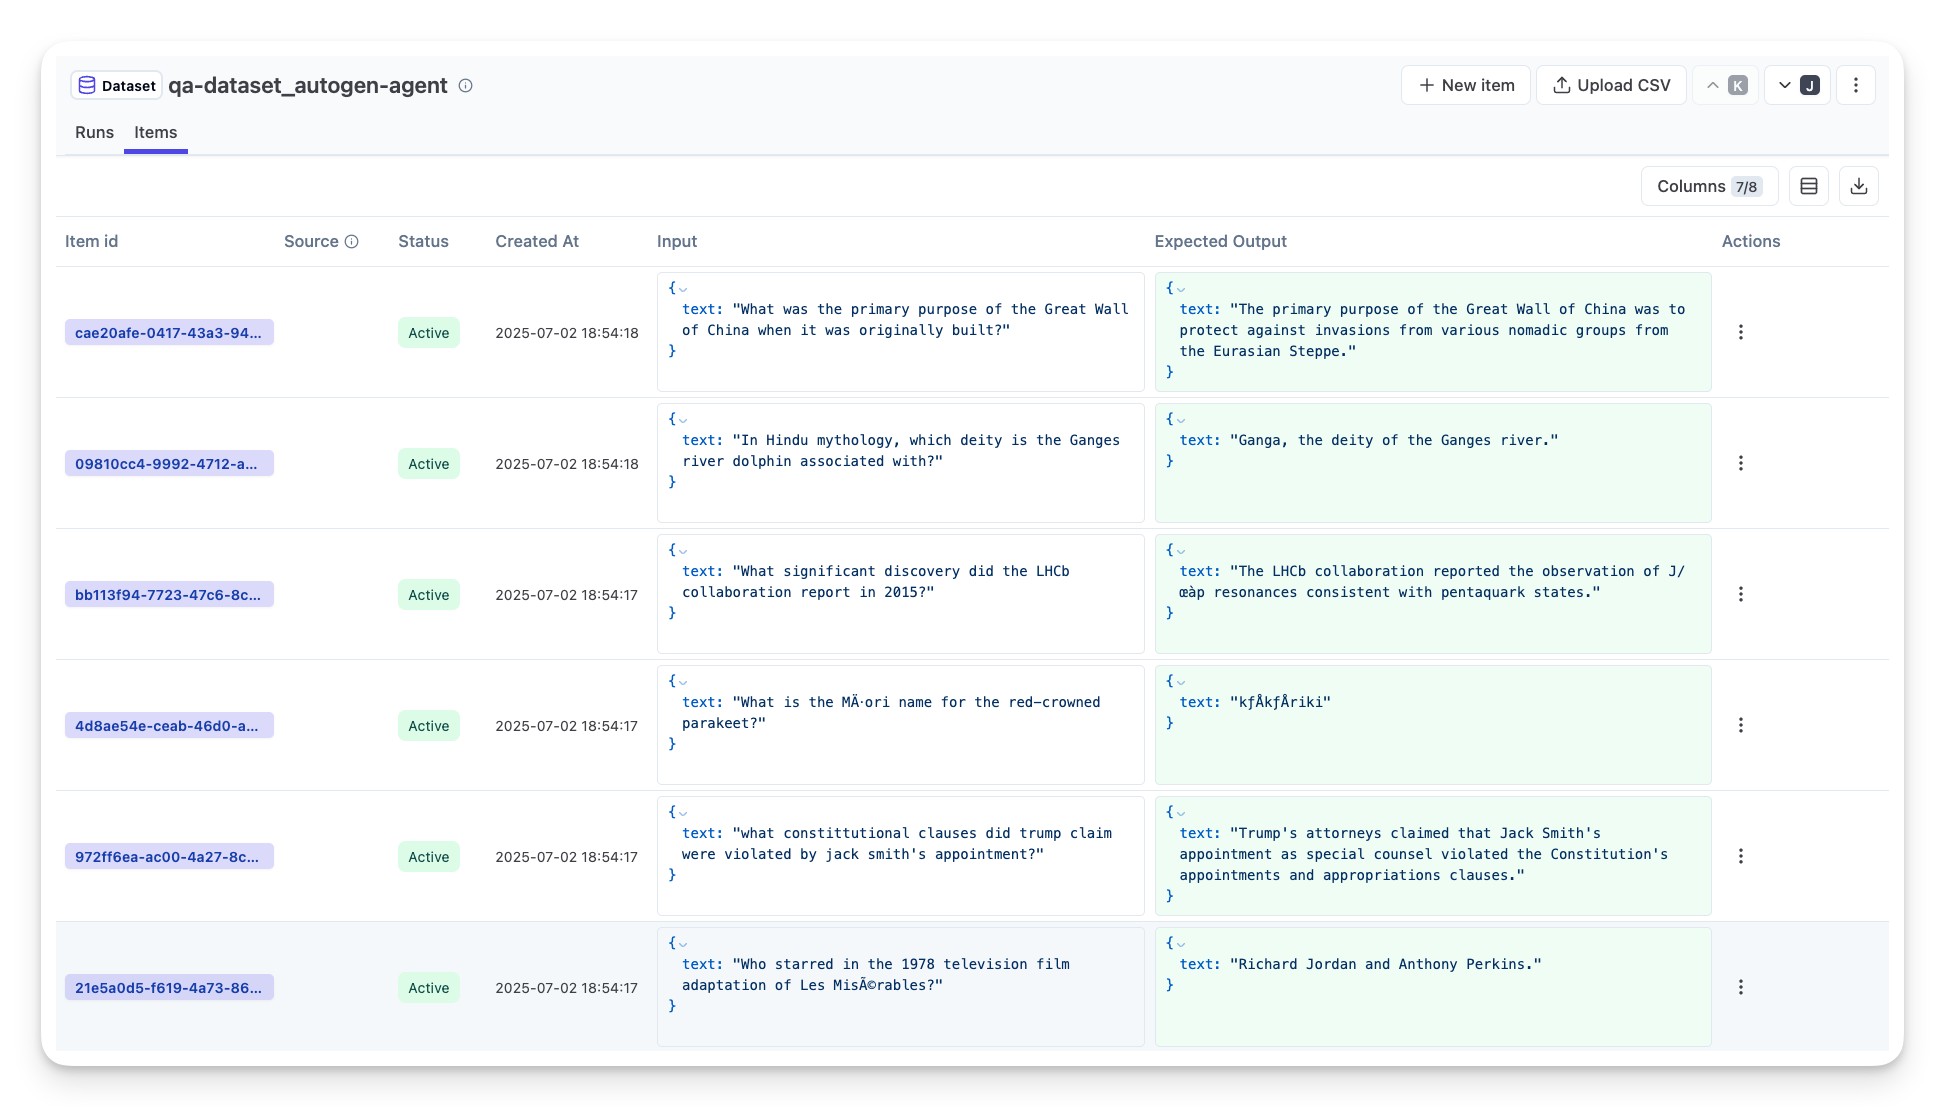
اس میں ایجنٹ کا جائزہ ایک کنٹرولڈ ماحول میں لیا جاتا ہے، عام طور پر ٹیسٹ ڈیٹا سیٹس کا استعمال کرتے ہوئے، نہ کہ براہِ راست صارف کی استفسارات پر۔ آپ منتخب کردہ ڈیٹا سیٹس استعمال کرتے ہیں جہاں آپ کو معلوم ہوتا ہے کہ متوقع نتیجہ یا درست رویہ کیا ہونا چاہیے، پھر اپنے ایجنٹ کو ان پر چلائیں۔
مثال کے طور پر، اگر آپ نے ایک ریاضی کا لفظی مسئلہ حل کرنے والا ایجنٹ بنایا ہے، تو آپ کے پاس 100 مسائل کا ٹیسٹ ڈیٹا سیٹ ہو سکتا ہے جس کے جوابات معلوم ہوں۔ آف لائن جائزہ اکثر ترقیاتی مرحلے میں (اور CI/CD پائپ لائنز کا حصہ ہو سکتا ہے) بہتریوں کی جانچ یا بہتری کی حفاظت کے لیے کیا جاتا ہے۔ فائدہ یہ ہے کہ یہ دوہرانے کے قابل ہوتا ہے اور آپ کے پاس درستگی کے واضح میٹرکس ہوتے ہیں کیونکہ آپ کے پاس زمین کی اصلیت ہوتی ہے۔ آپ صارف کے سوالات کا تخمینی اندازہ لگا کر یا خودکار میٹرکس کا استعمال کر کے ایجنٹ کے جوابات کی پیمائش بھی کر سکتے ہیں جیسا کہ پہلے بیان کیا گیا ہے۔
آف لائن جائزے کی اہم چیلنج یہ ہے کہ آپ کا ٹیسٹ ڈیٹا سیٹ جامع ہو اور متعلقہ رہے – ایجنٹ ایک مقررہ ٹیسٹ سیٹ پر اچھا کام کر سکتا ہے لیکن پیداوار میں بہت مختلف سوالات کا سامنا کر سکتا ہے۔ لہٰذا، آپ کو ٹیسٹ سیٹس کو نئے ایج کیسز اور حقیقی دنیا کے مناظرات کو ظاہر کرنے والے نمونوں کے ساتھ اپ ڈیٹ رکھنا چاہیے۔ چھوٹے “سموک ٹیسٹ” کیسز اور بڑے جائزہ سیٹس کا امتزاج مفید ہے: چھوٹے سیٹس جلدی چیک کے لیے اور بڑے سیٹس وسیع کارکردگی کے میٹرکس کے لیے۔
آن لائن جائزہ
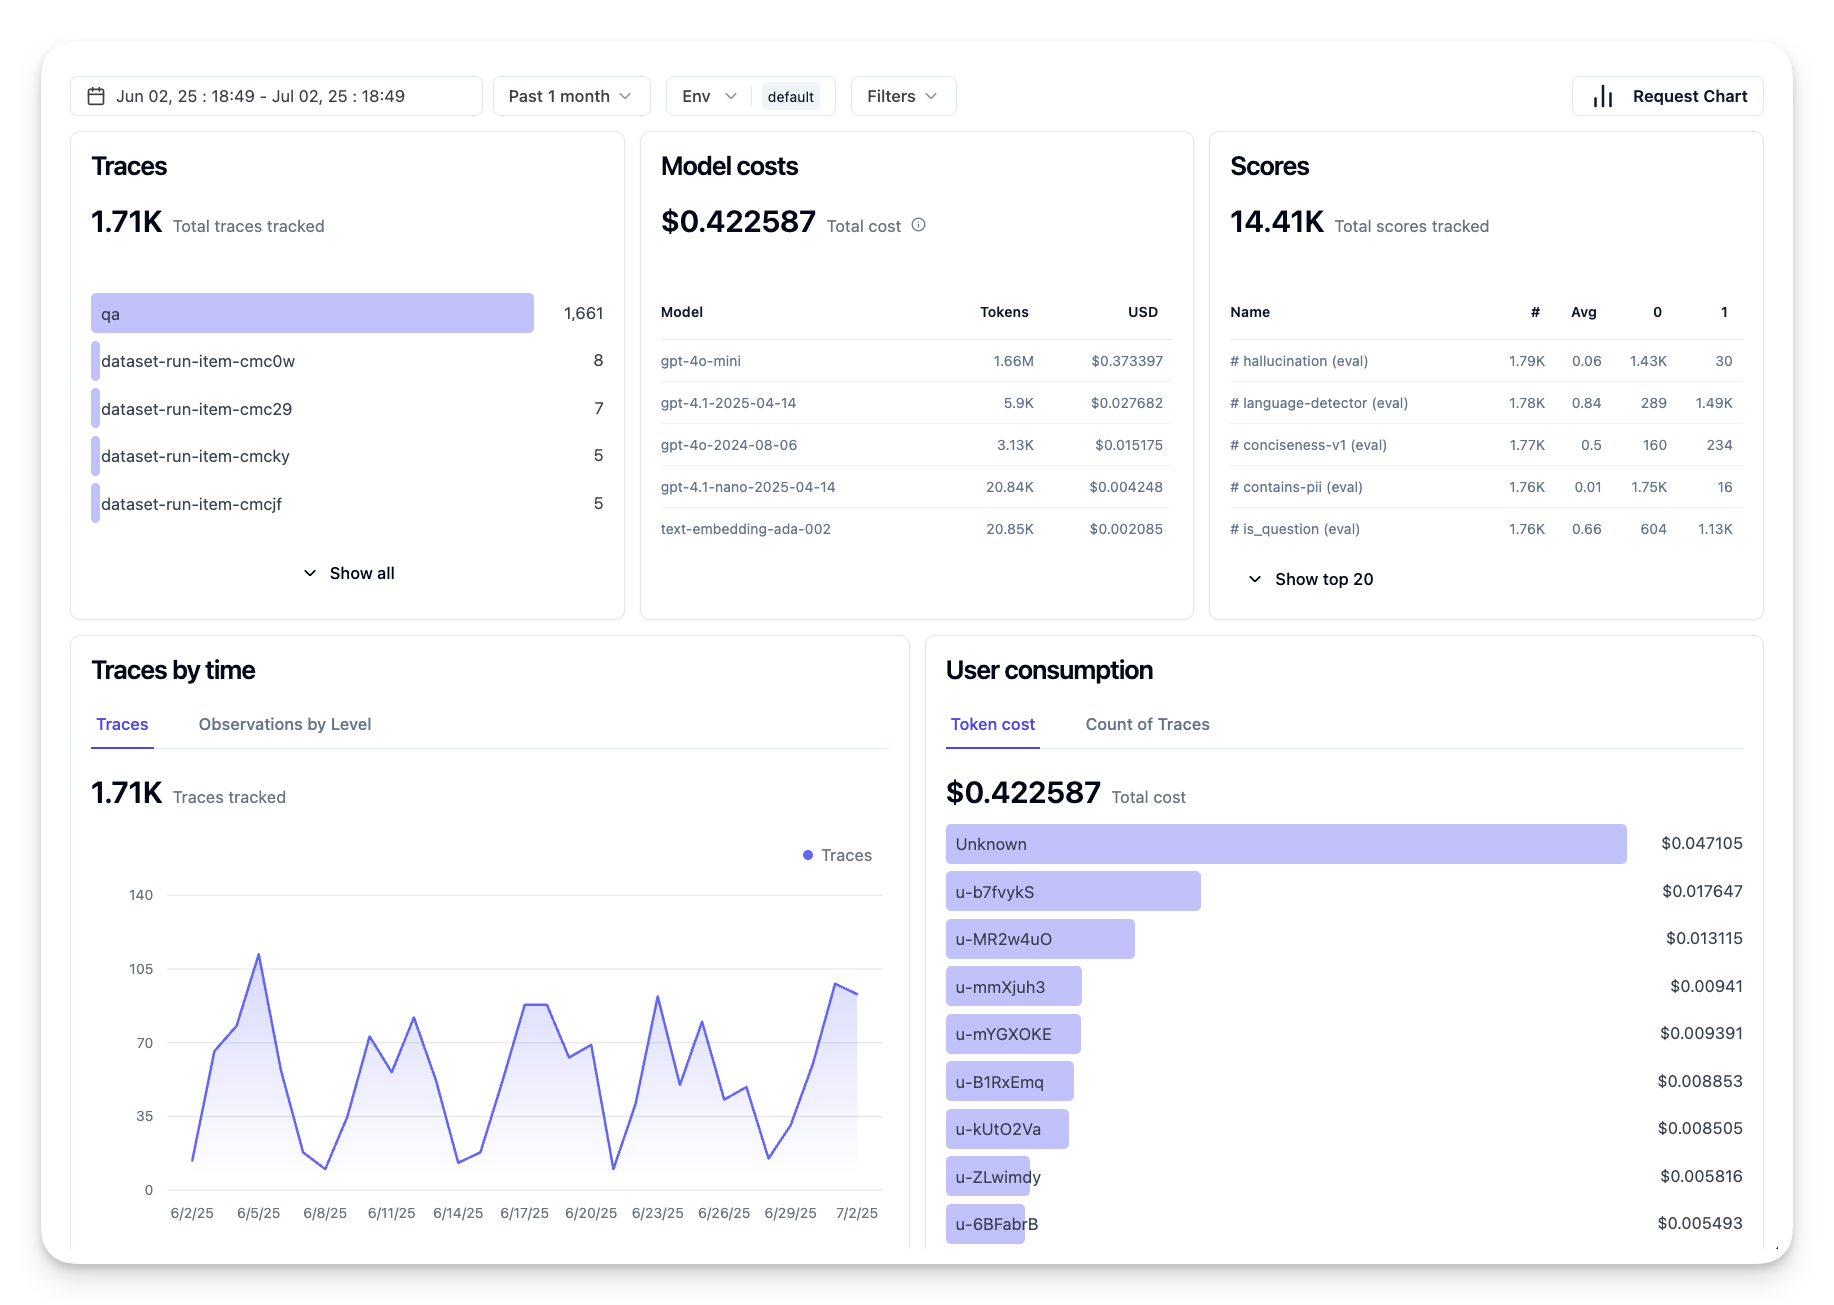
اس کا مطلب ہے کہ ایجنٹ کا جائزہ براہِ راست، حقیقی دنیا کے ماحول میں لیا جائے، یعنی پیداوار میں حقیقی استعمال کے دوران۔ آن لائن جائزہ ایجنٹ کی کارکردگی کی نگرانی کرتا ہے حقیقی صارف کے تعاملات پر اور نتائج کا مسلسل تجزیہ کرتا ہے۔
مثال کے طور پر، آپ کامیابی کی شرحیں، صارف کی اطمینان کے اسکورز، یا دیگر میٹرکس کو لائیو ٹریفک پر ٹریک کر سکتے ہیں۔ آن لائن جائزے کا فائدہ یہ ہے کہ یہ ایسی چیزوں کو پکڑتا ہے جو لیبارٹری کے ماحول میں ممکنہ طور پر نہیں دیکھ پائیں گے – آپ وقت کے ساتھ ماڈل کا رجحان دیکھ سکتے ہیں (اگر ایجنٹ کی مؤثریت ان پٹ کے پیٹرنز میں تبدیلی کی وجہ سے کم ہو جاتی ہے) اور غیر متوقع سوالات یا حالات کو پکڑ سکتے ہیں جو آپ کے ٹیسٹ ڈیٹا میں نہیں تھے۔ یہ ایک حقیقی تصویر فراہم کرتا ہے کہ ایجنٹ جنگل میں کیسے برتاؤ کرتا ہے۔
آن لائن جائزہ اکثر بالواسطہ اور بلاواسطہ صارف کی رائے جمع کرنے، جیسا کہ بحث ہوا، اور ممکنہ طور پر شیڈو ٹیسٹ یا A/B ٹیسٹ کرنے پر مشتمل ہوتا ہے (جہاں ایجنٹ کا نیا ورژن پرانے کے ساتھ موازنہ کے لیے ایک ساتھ چلتا ہے)۔ چیلنج یہ ہے کہ لائیو تعاملات کے لیے قابل اعتماد لیبل یا اسکورز حاصل کرنا مشکل ہو سکتا ہے – آپ ممکنہ طور پر صارف کی رائے یا نیچے کے میٹرکس پر انحصار کرتے ہیں (مثلاً کیا صارف نے نتیجے پر کلک کیا)۔
دونوں کو ملانا
آن لائن اور آف لائن جائزے متضاد نہیں بلکہ ایک دوسرے کی تکمیل ہیں۔ آن لائن نگرانی سے حاصل ہونے والی بصیرت (مثلاً صارف کے نئے قسم کے سوالات جہاں ایجنٹ کارکردگی کم دکھاتا ہے) کو آف لائن ٹیسٹ ڈیٹا سیٹس کو بہتر بنانے کے لیے استعمال کیا جا سکتا ہے۔ اسی طرح، وہ ایجنٹس جو آف لائن ٹیسٹ میں اچھے کارکردگی دکھاتے ہیں، انہیں آن لائن زیادہ بھروسے کے ساتھ تعینات اور نگرانی کی جا سکتی ہے۔
حقیقت میں، کئی ٹیمیں یہ لوپ اپناتی ہیں:
آف لائن جائزہ → تعیناتی → آن لائن نگرانی → نئے ناکامی کے کیسز جمع کرنا → آف لائن ڈیٹا سیٹ میں اضافہ → ایجنٹ کو بہتر بنانا → دہراؤ
عام مسائل
جب آپ AI ایجنٹس کو پیداوار میں تعینات کرتے ہیں، تو آپ کو مختلف چیلنجز کا سامنا ہو سکتا ہے۔ یہاں کچھ عام مسائل اور ان کے ممکنہ حل ہیں:
| مسئلہ | ممکنہ حل |
|---|---|
| AI ایجنٹ تسلسل کے ساتھ کام انجام نہیں دے رہا | - AI ایجنٹ کو دیے جانے والے پرامپٹ کو بہتر بنائیں؛ مقاصد واضح کریں۔ - شناخت کریں کہ کاموں کو ذیلی کاموں میں تقسیم کرنے اور ان کو متعدد ایجنٹس سے سنبھالنے سے مدد مل سکتی ہے۔ |
| AI ایجنٹ مسلسل لوپس میں پھنس رہا ہے | - آپ کے پاس واضح اختتام کی شرائط ہونی چاہئیں تاکہ ایجنٹ جان سکے کہ عمل کو کب روکنا ہے۔ - پیچیدہ کاموں کے لیے جنہیں منطق اور منصوبہ بندی کی ضرورت ہو، ایک بڑا ماڈل استعمال کریں جو منطق کے کاموں کے لیے خصوصی ہو۔ |
| AI ایجنٹ کے ٹول کالز اچھی کارکردگی نہیں دکھا رہے | - ایجنٹ سسٹم کے باہر ٹول کی آؤٹ پٹ کو جانچیں اور تصدیق کریں۔ - ٹولز کے متعین کردہ پیرامیٹرز، پرامپٹس، اور ناموں کو بہتر بنائیں۔ |
| کثیر ایجنٹ سسٹم تسلسل کے ساتھ کارکردگی نہیں دکھا رہا | - ہر ایجنٹ کو دیے جانے والے پرامپٹس کو مخصوص اور ایک دوسرے سے منفرد بنائیں۔ - ایک ہائیئراریکل سسٹم بنائیں جس میں “روٹنگ” یا کنٹرولر ایجنٹ ہو جو طے کرے کہ کون سا ایجنٹ درست ہے۔ |
ان مسائل کی بہتری نگرانی کے ذریعے زیادہ مؤثر طریقے سے کی جا سکتی ہے۔ ہم نے جو ٹریسز اور میٹرکس پہلے بیان کیے، وہ ایجنٹ کے ورک فلو میں بالکل کہاں مسائل ہو رہے ہیں کی نشاندہی کرنے میں مدد کرتے ہیں، جس سے ڈی بگنگ اور اصلاح بہت کارگر ہو جاتی ہے۔
لاگت کا انتظام
یہاں AI ایجنٹس کو پیداوار میں تعینات کرنے کی لاگتوں کو منظم کرنے کی کچھ حکمت عملیاں ہیں:
چھوٹے ماڈلز کا استعمال: چھوٹے زبان کے ماڈلز (SLMs) کچھ مخصوص ایجنٹک استعمال کے کیسز میں اچھی کارکردگی دکھا سکتے ہیں اور اخراجات کو نمایاں طور پر کم کریں گے۔ جیسا کہ پہلے ذکر کیا گیا ہے، ایک ایسی جانچ کا نظام بنانا جو کارکردگی کا تعین کرے اور بڑے ماڈلز کے مقابلے میں موازنہ کرے، یہ بہترین طریقہ ہے یہ سمجھنے کا کہ ایک SLM آپ کے استعمال کے کیس میں کتنی اچھی کارکردگی دکھائے گا۔ آسان کاموں جیسے ارادے کی درجہ بندی یا پیرامیٹر نکالنے کے لئے SLMs استعمال کرنے پر غور کریں، جبکہ پیچیدہ استدلال کے لئے بڑے ماڈلز محفوظ رکھیں۔
روٹر ماڈل کا استعمال: ایک ملتی جلتی حکمت عملی مختلف قسم کے ماڈلز اور سائز استعمال کرنا ہے۔ آپ پیچیدگی کی بنیاد پر درخواستوں کو بہترین فٹ ماڈلز کی طرف روٹ کرنے کے لئے LLM/SLM یا سرور لیس فنکشن استعمال کر سکتے ہیں۔ یہ بھی اخراجات کو کم کرنے میں مدد دے گا جبکہ صحیح کاموں پر کارکردگی کو یقینی بنائے گا۔ مثال کے طور پر، آسان سوالات کو چھوٹے، تیز ماڈلز کی طرف بھیجیں، اور صرف مہنگے بڑے ماڈلز کو پیچیدہ استدلال کے کاموں کے لئے استعمال کریں۔
جوابات کیش کرنا: عام درخواستوں اور کاموں کی شناخت کرنا اور ردعمل فراہم کرنا، ان کے آپ کے ایجنٹک سسٹم سے گزرنے سے پہلے، اسی طرح کی درخواستوں کی مقدار کو کم کرنے کا ایک اچھا طریقہ ہے۔ آپ ایک ایسا فلو بھی نافذ کر سکتے ہیں جو آپ کی کیش کی گئی درخواستوں کے ساتھ درخواست کی مماثلت کی سطح کی نشاندہی کرے، زیادہ بنیادی AI ماڈلز استعمال کرتے ہوئے۔ یہ حکمت عملی اکثر پوچھے جانے والے سوالات یا عام ورک فلو کے لئے اخراجات کو نمایاں طور پر کم کر سکتی ہے۔
آئیے دیکھیں کہ یہ عملی طور پر کیسے کام کرتا ہے
اس سیکشن کی مثال نوٹ بک میں، ہم مثالیں دیکھیں گے کہ ہم مشاہداتی اوزاروں کا استعمال کر کے اپنے ایجنٹ کی نگرانی اور جائزہ کیسے لے سکتے ہیں۔
کیا آپ کے پاس AI ایجنٹس کی پیداوار سے متعلق مزید سوالات ہیں؟
Microsoft Foundry Discord میں شامل ہوں تاکہ دیگر سیکھنے والوں سے ملاقات کریں، آفس آورز میں شرکت کریں اور اپنے AI ایجنٹس کے سوالات کے جواب حاصل کریں۔
پچھلا سبق
اگلا سبق
ڈس کلیمر: یہ دستاویز AI ترجمہ سروس Co-op Translator کے ذریعے ترجمہ کی گئی ہے۔ جبکہ ہم درستگی کے لیے کوشاں ہیں، براہ کرم اس بات سے آگاہ رہیں کہ خودکار ترجمے میں غلطیاں یا عدم درستیاں ہو سکتی ہیں۔ اصل دستاویز اپنے مادری زبان میں مستند ماخذ سمجھی جائے گی۔ حساس معلومات کے لیے پیشہ ور انسانی ترجمہ کی سفارش کی جاتی ہے۔ اس ترجمے کے استعمال سے پیدا ہونے والی کسی بھی غلط فہمی یا غلط تشریح کی ذمہ داری ہم قبول نہیں کرتے۔