ai-agents-for-beginners
उत्पादनमा AI एजेन्टहरू: अवलोकनयोग्यता र मूल्यांकन
जस्तै-जस्तै AI एजेन्टहरू प्रायोगात्मक प्रोटोटाइपहरूबाट वास्तविक विश्वका अनुप्रयोगहरूमा जान्छन्, उनीहरूको व्यवहार बुझ्ने, प्रदर्शन अनुगमन गर्ने, र व्यवस्था अन्तर्गत प्रणालीगत रूपमा उनीहरूको नतिजाहरूको मूल्यांकन गर्ने क्षमता महत्त्वपूर्ण हुन्छ।
सिकाइका लक्ष्यहरू
यस पाठ पूरा गरेपछि, तपाईंलाई निम्न कुरा थाहा हुनेछ/बुझिनेछ:
- एजेन्ट अवलोकनयोग्यता र मूल्यांकनका मूल अवधारणाहरू
- एजेन्टहरूको प्रदर्शन, लागत र प्रभावकारिता सुधार गर्ने प्रविधिहरू
- तपाईंका AI एजेन्टहरूलाई प्रणालीगत रूपमा के र कसरी मूल्यांकन गर्ने
- उत्पादनमा AI एजेन्टहरू परिचालन गर्दा लागत कसरी नियन्त्रण गर्ने
- Microsoft Agent Framework प्रयोग गरी निर्मित एजेन्टहरूलाई कसरी उपकरणसहित निगरानी गर्ने
लक्ष्य तपाईंलाई “कालो बाकस” वा “ब्ल्याक बक्स” एजेन्टहरूलाई पारदर्शी, प्रबन्धनीय, र भरोसायोग्य प्रणालीहरूमा परिणत गर्न आवश्यक ज्ञानले सुसज्जित गर्नु हो।
नोट: सुरक्षित र भरोसायोग्य AI एजेन्टहरू परिचालन गर्नु महत्वपूर्ण छ। Building Trustworthy AI Agents पाठ पनि अवलोकन गर्नुहोस्।
ट्रेस र स्प्यानहरू
अवलोकनयोग्य उपकरणहरू जस्तै Langfuse वा Microsoft Foundry प्रायः एजेन्ट चलाउने कार्यहरूलाई ट्रेस र स्प्यानको रूपमा प्रतिनिधित्व गर्छन्।
- ट्रेस पूर्ण एजेन्ट कार्यलाई सुरु देखि अन्त्यसम्म दर्शाउँछ (जस्तै प्रयोगकर्ताको प्रश्न सम्हाल्नु)।
- स्प्यानहरू ट्रेस भित्रका व्यक्तिगत चरणहरू हुन् (जस्तै भाषा मोडेल कल गर्नु वा डेटा प्राप्त गर्नु)।
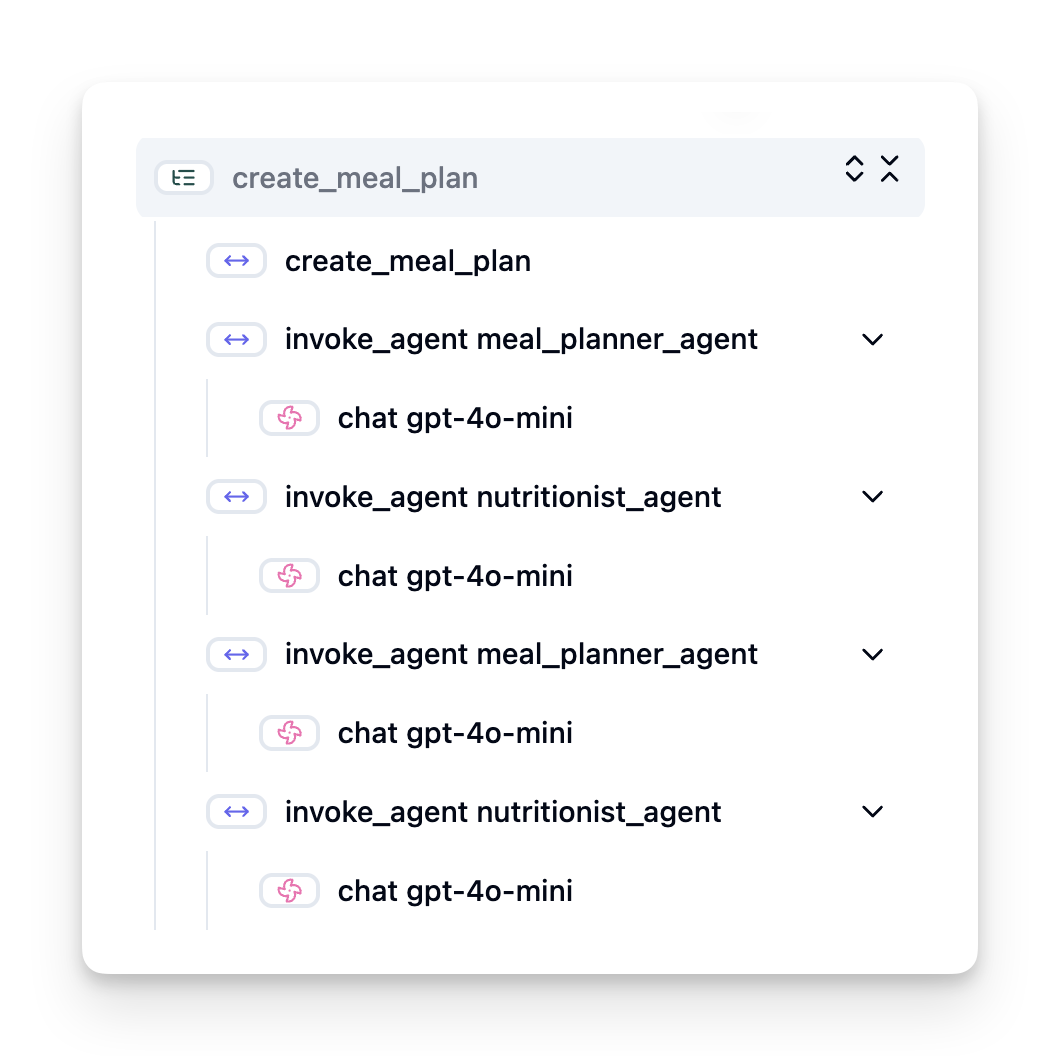
अवलोकनयोग्यता बिना, AI एजेन्टले “ब्ल्याक बक्स” जस्तो महसुस गराउन सक्छ - यसको आन्तरिक अवस्था र तर्क अस्पष्ट हुन्छ, जसले समस्या समाधान वा प्रदर्शन अनुकूलन गर्न कठिन बनाउँछ। अवलोकनयोग्यताबाट, एजेन्टहरू “ग्लास बक्स” मा परिणत हुन्छन्, जसले पारदर्शिता प्रदान गर्दछ जुन विश्वास निर्माण र तिनको निर्धारित रूपमा सञ्चालन सुनिश्चित गर्न अत्यावश्यक छ।
उत्पादन वातावरणहरूमा अवलोकनयोग्यता किन महत्त्वपूर्ण छ
AI एजेन्टहरूलाई उत्पादन वातावरणमा लैजानाले नयाँ चुनौतीहरू र आवश्यकताहरू ल्याउँछ। अवलोकनयोग्यता अब एक “राम्रो हुने कुरा” मात्र होइन, एउटा महत्वपूर्ण क्षमता हो:
- डिबगिङ र मूल कारण विश्लेषण: जब एजेन्ट असफल हुन्छ वा अनपेक्षित नतिजा उत्पादन गर्दछ, अवलोकनयोग्य उपकरणहरूले त्रुटिको स्रोत पहिचान गर्न आवश्यक ट्रेसहरू प्रदान गर्छन्। यो विशेष गरी जटिल एजेन्टहरूमा महत्त्वपूर्ण हुन्छ जसमा धेरै LLM कलहरू, उपकरण अन्तरक्रिया, र सशर्त तर्क हुन सक्छन्।
- ढिलाइ र लागत व्यवस्थापन: AI एजेन्टहरू प्रायः LLM र अन्य बाह्य API हरूमाथि निर्भर हुन्छन् जुन प्रति टोकन वा कलमा बिल गरिन्छ। अवलोकनयोगिताले यी कलहरूको सटीक ट्र्याकिङ गर्न अनुमति दिन्छ, जसले अत्यधिक सुस्त वा महँगो अपरेसनहरू पहिचान गर्न मद्दत गर्दछ। यसले टोलीहरूलाई प्रोम्प्टहरू अनुकूलित गर्न, बढी प्रभावकारी मोडेलहरू चयन गर्न, अथवा कार्यप्रवाह पुन: डिजाइन गर्न सक्षम बनाउँछ जसले सञ्चालन लागत व्यवस्थापन र राम्रो प्रयोगकर्ता अनुभव सुनिश्चित गर्छ।
- विश्वास, सुरक्षा, र अनुपालन: धेरै अनुप्रयोगहरूमा एजेन्टहरू सुरक्षित र नैतिक व्यवहार गर्नुपर्छ। अवलोकनयोग्यताले एजेन्टका क्रियाकलाप र निर्णयहरूको अडिट ट्रेल प्रदान गर्छ। यसले प्रॉम्प्ट इंजेक्शन, हानिकारक सामग्री उत्पादन, वा व्यक्तिगत पहिचानयोग्य सूचना (PII) को गलत ह्यान्डलिंग जस्ता मुद्दाहरू पत्ता लगाउन र समाधान गर्न प्रयोग गर्न सकिन्छ। उदाहरणका लागि, तपाईं ट्रेसहरू समीक्षा गरेर बुझ्न सक्नुहुन्छ किन एजेन्टले विशिष्ट प्रतिक्रिया दिएको वा विशिष्ट उपकरण प्रयोग गरेको।
- लगातार सुधार चक्रहरू: अवलोकनयोग्यता डाटाले आवर्ती विकास प्रक्रियाको आधार तयार गर्छ। वास्तविक दुनियाँमा एजेन्टहरूको प्रदर्शन अनुगमन गरेर, टोलीहरूले सुधारका क्षेत्रहरू पहिचान गर्न, मोडेलहरूको सूक्ष्म समायोजनका लागि डेटा संकलन गर्न, र परिवर्तनहरूको प्रभाव प्रमाणित गर्न सक्छन्। यसले एउटा फिडब्याक लूप सिर्जना गर्छ जहाँ अनलाइन मूल्यांकनबाट प्राप्त उत्पादन अन्तर्दृष्टिहरू अफलाइन प्रयोगशालामा परिमार्जन र सुधारलाई सूचित गर्छ, जसबाट लगातार राम्रो एजेन्ट प्रदर्शन हासिल हुन्छ।
ट्र्याक गर्ने मुख्य मेट्रिक्सहरू
एजेन्टको व्यवहार अनुगमन गर्नका लागि विभिन्न मेट्रिक्स र संकेतहरू ट्र्याक गरिनुपर्छ। एजेन्टको उद्देश्य अनुसार विशेष मेट्रिक्स फरक हुन सक्छ, तर केही सार्वभौमिक रूपमा महत्त्वपूर्ण हुन्छन्।
यहाँ अवलोकनयोग्य उपकरणहरूले अनुगमन गर्ने केही सामान्य मेट्रिक्सहरू छन्:
ढिलाइ (Latency): एजेन्टले कति छिटो प्रतिक्रिया दिन्छ? लामो प्रतीक्षा समयले प्रयोगकर्ता अनुभवमा नकारात्मक प्रभाव पार्छ। तपाईंले एजेन्टको दौडहरू ट्रेस गरेर कार्य र व्यक्तिगत चरणहरूको ढिलाइ मापन गर्नु पर्छ। उदाहरणका लागि, सबै मोडेल कलहरूमा २० सेकेन्ड लाग्ने एजेन्ट छिटो मोडेल प्रयोग गरेर वा समानान्तर मोडेल कल चलाएर तीव्र बनाउन सकिन्छ।
लागतहरू: प्रति एजेन्ट रनमा कति खर्च हुन्छ? AI एजेन्टहरू LLM कलहरू वा बाह्य API हरूमा निर्भर हुन्छन् जुन प्रति टोकन बिल गरिन्छ। बारम्बार उपकरण प्रयोग वा धेरै प्रोम्प्टहरूले लागत तीव्र रूपमा बढाउन सक्छ। उदाहरणका लागि, यदि एजेन्टले पाँच पटक LLM कल गरेर सामान्य गुणस्तर सुधार गर्छ भने, लागत न्यायोचित छ कि छैन वा कलहरू कम गर्ने वा सस्तो मोडेल प्रयोग गर्ने कुरा मूल्यांकन गर्नुपर्छ। वास्तविक-समय निगरानीले अनपेक्षित खर्च वृद्धिहरू पत्ता लगाउन मद्दत गर्दछ (उदाहरणका लागि, बगहरूले अत्यधिक API लूप उत्पन्न गर्दा)।
अनुरोध त्रुटिहरू: कित्तो अनुरोधहरू एजेन्टले असफल गर्यो? यसमा API त्रुटि वा असफल उपकरण कलहरू समावेश हुन सक्छ। उत्पादनमा एजेन्टलाई थप मजबूत बनाउनका लागि फलब्याक वा पुनः प्रयास सेटअप गर्न सकिन्छ। जस्तै, यदि LLM प्रदायक A डाउन छ भने, ब्याकअपका रूपमा LLM प्रदायक B मा स्विच गर्ने।
प्रयोगकर्ता प्रतिक्रिया: सिधा प्रयोगकर्ता मूल्यांकनहरू लागू गर्दा महत्वपूर्ण अन्तर्दृष्टिहरू प्राप्त हुन्छन्। यसमा स्पष्ट मूल्याङ्कनहरू (👍थम्ब्स-अप/👎डाउन, ⭐1-5 स्टार) वा टेक्स्ट टिप्पणीहरू समावेश हुन सक्छ। लगातार नकारात्मक प्रतिक्रिया तपाईंलाई सर्तक गराउनु पर्छ किनभने यो एजेन्टले अपेक्षित रूपमा काम गरिरहेको छैन भन्ने सङ्केत हो।
अप्रत्यक्ष प्रयोगकर्ता प्रतिक्रिया: प्रयोगकर्ता व्यवहारहरू स्पष्ट मूल्याङ्कन बिना पनि अप्रत्यक्ष प्रतिक्रिया प्रदान गर्छ। जस्तै तुरुन्तै प्रश्न पुन:फरमाउने, प्रश्न दोहोर्याउने वा पुन: प्रयास बटन क्लिक गर्ने। उदाहरणका लागि, यदि तपाईं देख्नुहुन्छ कि प्रयोगकर्ताहरू बारम्बार एउटै प्रश्न सोध्छन् भने, यो एजेन्टले ठीकसँग काम गरिरहेको छैन भन्ने सङ्केत हो।
शुद्धता (Accuracy): एजेन्टले कति पटक सही वा चाहिएको नतिजा उत्पादन गर्छ? शुद्धताको परिभाषा फरक हुनसक्छ (जस्तो समस्या समाधानमा शुद्धता, सूचना पुनर्प्राप्तिमा शुद्धता, प्रयोगकर्ता सन्तुष्टि)। पहिलो चरण हो तपाईंको एजेन्टका लागि सफलताको परिभाषा निर्धारण गर्नु। तपाईं शुद्धता स्वत: परीक्षण, मूल्यांकन स्कोर, वा कार्य सम्पन्नता चिन्ह लगाएर ट्र्याक गर्न सक्नुहुन्छ। उदाहरणका लागि, ट्रेसहरूलाई “सफल” वा “असफल” चिन्ह लगाउने।
स्वचालित मूल्यांकन मेट्रिक्सहरू: तपाईंले स्वचालित मूल्यांकन पनि सेटअप गर्न सक्नुहुन्छ। उदाहरणका लागि, तपाईं LLM प्रयोग गरेर एजेन्टको नतिजालाई स्कोर गर्न सक्नुहुन्छ जस्तै के यो सहयोगी छ, सही छ वा छैन। त्यस्तै विभिन्न पक्षहरू स्कोर गर्न सहयोग गर्ने धेरै खुला स्रोत पुस्तकालयहरू पनि छन्। जस्तै RAGAS RAG एजेन्टहरूका लागि वा LLM Guard हानिकारक भाषा वा प्रॉम्प्ट इंजेक्शन पत्ता लगाउन।
व्यवहारमा, यी मेट्रिक्सहरूको संयोजनले AI एजेन्टको स्वास्थ्यको सबैभन्दा राम्रो कभर प्रदान गर्छ। यस अध्यायको उदाहरण नोटबुक मा हामी तपाईंलाई यी मेट्रिक्स कसरी वास्तविक उदाहरणहरूमा देखिन्छन् भन्ने देखाउनेछौं तर पहिले हामी एउटा सामान्य मूल्यांकन कार्यप्रवाह कस्तो हुन्छ भन्ने सिक्नेछौं।
आफ्नो एजेन्टलाई उपकरणसहित सेटअप गर्नुहोस्
ट्रेसिङ डेटा सङ्कलन गर्न, तपाईंले तपाईँको कोडलाई उपकरणसहित बनाउन आवश्यक छ। लक्ष्य भनेको एजेन्ट कोडलाई यस्तो बनाउनु हो जुन ट्रेस र मेट्रिक्सहरू प्रेषित गर्छ जसलाई अवलोकनयोग्य प्लेटफर्मले समात्न, प्रक्रिया गर्न र दृश्यता गर्न सक्छ।
OpenTelemetry (OTel): OpenTelemetry LLM अवलोकनयोग्यताको लागि उद्योग मानकको रूपमा उदय भएको छ। यसले टेलीमेट्री डेटा उत्पन्न, सङ्कलन, र निर्यात गर्नका लागि API, SDK, र उपकरणहरूको सेट प्रदान गर्छ।
धेरै उपकरण पुस्तकालयहरू छन् जुन अवस्थित एजेन्ट फ्रेमवर्कहरूलाई आवरण दिई OpenTelemetry स्प्यानहरूलाई अवलोकनयोग्य उपकरणतर्फ सजिलै निर्यात गर्न सकिन्छ। Microsoft Agent Framework मूल रूपमा OpenTelemetry सँग एकीकृत छ। तल MAF एजेन्टलाई उपकरणसहित बनाउने उदाहरण छ:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
यस अध्यायको उदाहरण नोटबुक ले तपाईंलाई तपाईंको MAF एजेन्टलाई कसरी उपकरणसहित बनाउन देखाउनेछ।
म्यानुअल स्प्यान सिर्जना: जबकि उपकरण पुस्तकालयहरूले राम्रो आधार प्रदान गर्छन्, प्रायः थप विस्तृत वा अनुकूलित जानकारी आवश्यक पर्न सक्छ। तपाईंले म्यानुअल रूपमा स्प्यानहरू सिर्जना गरेर अनुकूलित एप्लिकेसन तर्क थप्न सक्नुहुन्छ। अधिक महत्त्वपूर्ण कुरा, ती स्वचालित वा म्यानुअल रूपमा सिर्जना गरिएका स्प्यानहरूलाई अनुकूलित विशेषताहरू (ट्याग वा मेटाडाटा पनि भनिन्छ) द्वारा समृद्ध बनाउन सकिन्छ। यी विशेषताहरूमा व्यापार-विशिष्ट डेटा, मध्यवर्ती गणना, वा डिबगिङ वा विश्लेषणका लागि उपयोगी हुनसक्ने कुनै पनि सन्दर्भ समावेश गर्न सकिन्छ, जस्तै user_id, session_id, वा model_version।
म्यानुअल रूपमा ट्रेस र स्प्यानहरू सिर्जना गर्ने उदाहरण Langfuse Python SDK संग:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
एजेन्ट मूल्यांकन
अवलोकनयोग्यताले हामीलाई मेट्रिक्स दिन्छ, तर मूल्यांकन भनेको त्यो डाटालाई विश्लेषण गर्ने प्रक्रिया हो (र परीक्षणहरू गर्ने) जसले AI एजेन्टको कस्तो प्रदर्शन छ र कसरी सुधार गर्न सकिन्छ निर्धारण गर्छ। अर्कोतर्फ, यी ट्रेस र मेट्रिक्सहरू प्राप्त गरेपछि, तपाईंले एजेन्टलाई कसरी निर्णय र मूल्याङ्कन गर्नुपर्छ?
नियमित मूल्यांकन महत्वपूर्ण हुन्छ किनभने AI एजेन्टहरू प्रायः गैर-नियतात्मक हुन्छन् र विकासशील हुन्छन् (अपडेट वा मोडेल व्यवहारमा विचलनबाट) – मूल्यांकन बिना, तपाईंलाई थाहा नहुन सक्छ कि तपाईंको “स्मार्ट एजेन्ट” साँच्चै राम्रो काम गरिरहेको छ कि छैन वा यसको प्रदर्शन घटेको छ।
AI एजेन्टहरूको लागि दुई मूल्यांकन विधाहरू छन्: अनलाइन मूल्यांकन र अफलाइन मूल्यांकन। दुवै महत्त्वपूर्ण छन् र एकअर्कालाई पूरक गर्दछन्। हामी प्रायः अफलाइन मूल्यांकनबाट सुरु गर्छौं, किनभने यो कुनै एजेन्ट परिचालन गर्नुअघि आवश्यक न्यूनतम कदम हो।
अफलाइन मूल्यांकन
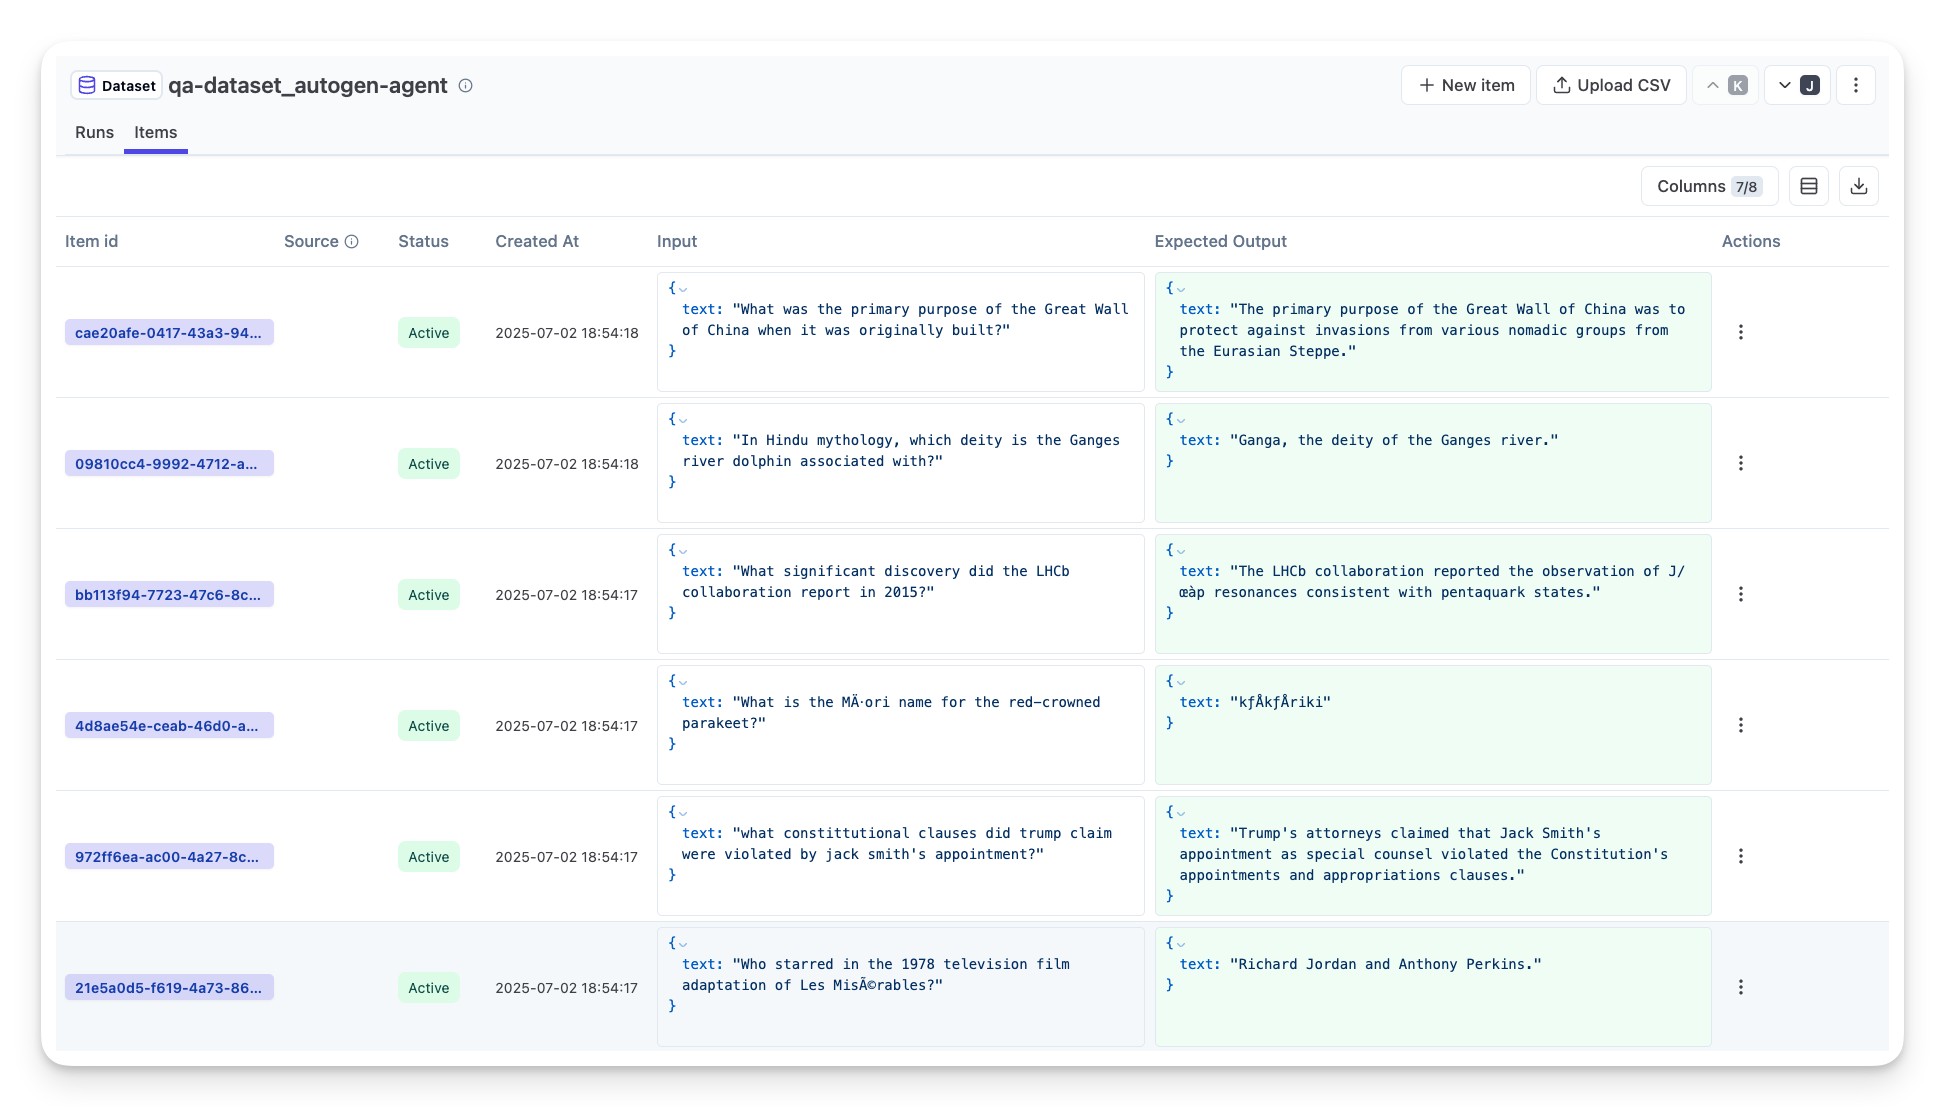
यसमा एजेन्टलाई नियन्त्रण वातावरणमा मूल्यांकन गर्ने समावेश छ, सामान्यतया परीक्षण डेटासेटहरूको प्रयोग गरेर, प्रत्यक्ष प्रयोगकर्ता प्रश्नहरू होइन। तपाईंले क्युरेट गरिएको डेटासेटहरू प्रयोग गर्नुहुन्छ जहाँ अपेक्षित नतिजा वा सही व्यवहार थाहा हुन्छ, र त्यसपछि आफ्नो एजेन्टलाई तिनमा चलाउनुहुन्छ।
उदाहरणका रूपमा, यदि तपाईंले गणितीय शब्द-समस्या एजेन्ट बनाउनुभएको छ भने, तपाईं सँग १०० समस्याहरू भएको परीक्षा डेटासेट हुनसक्छ जुन उत्तरहरू थाहा हुन्छन्। अफलाइन मूल्यांकन प्राय: विकास क्रममा गरिन्छ (र CI/CD पाइपलाइनको हिस्सा हुन सक्छ) सुधारहरु जाँच्न वा पागलपन विरुद्ध सुरक्षा गर्न। यसको फाइदा यो छ कि यो पुन: दोहोर्याउन सकिने र तपाईंलाई आधारभूत गुणस्तर मेट्रिक्सहरू प्राप्त गर्ने मौका दिन्छ किनभने तपाईंलाई ग्राउन्ड ट्रुथ थाहा हुन्छ। तपाईंले प्रयोगकर्ता प्रश्नहरू सिमुलेट गरेर एजेन्टको प्रतिक्रिया आदर्श उत्तरहरूसँग तुलना गर्न सक्नुहुन्छ वा माथि वर्णन गरिएका स्वचालित मेट्रिक्सहरू प्रयोग गर्न सक्नुहुन्छ।
अफलाइन मूल्यांकनमा मुख्य चुनौती भनेको तपाईँको परीक्षण डेटासेट व्यापक र सम्बन्धित रहोस भन्ने सुनिश्चित गर्नु हो - एजेन्टले स्थिर परीक्षण सेटमा राम्रो प्रदर्शन गर्न सक्छ तर उत्पादनमा धेरै फरक प्रश्नहरूको सामना गर्न सक्छ। त्यसकारण, तपाईंले परीक्षण सेटहरूलाई नयाँ किनारा प्रकरणहरू र वास्तविक-विश्व परिदृश्यहरू प्रतिबिम्बित गर्ने उदाहरणहरूसहित अपडेट गरिरहनु पर्छ। सानो “स्मोक टेस्ट” केसहरू र ठूला मूल्यांकन सेटहरूको मिश्रण उपयोगी हुन्छ: साना सेटहरू छिटो जाँचका लागि र ठूला प्रदर्शन मेट्रिक्सहरूको लागि।
अनलाइन मूल्यांकन
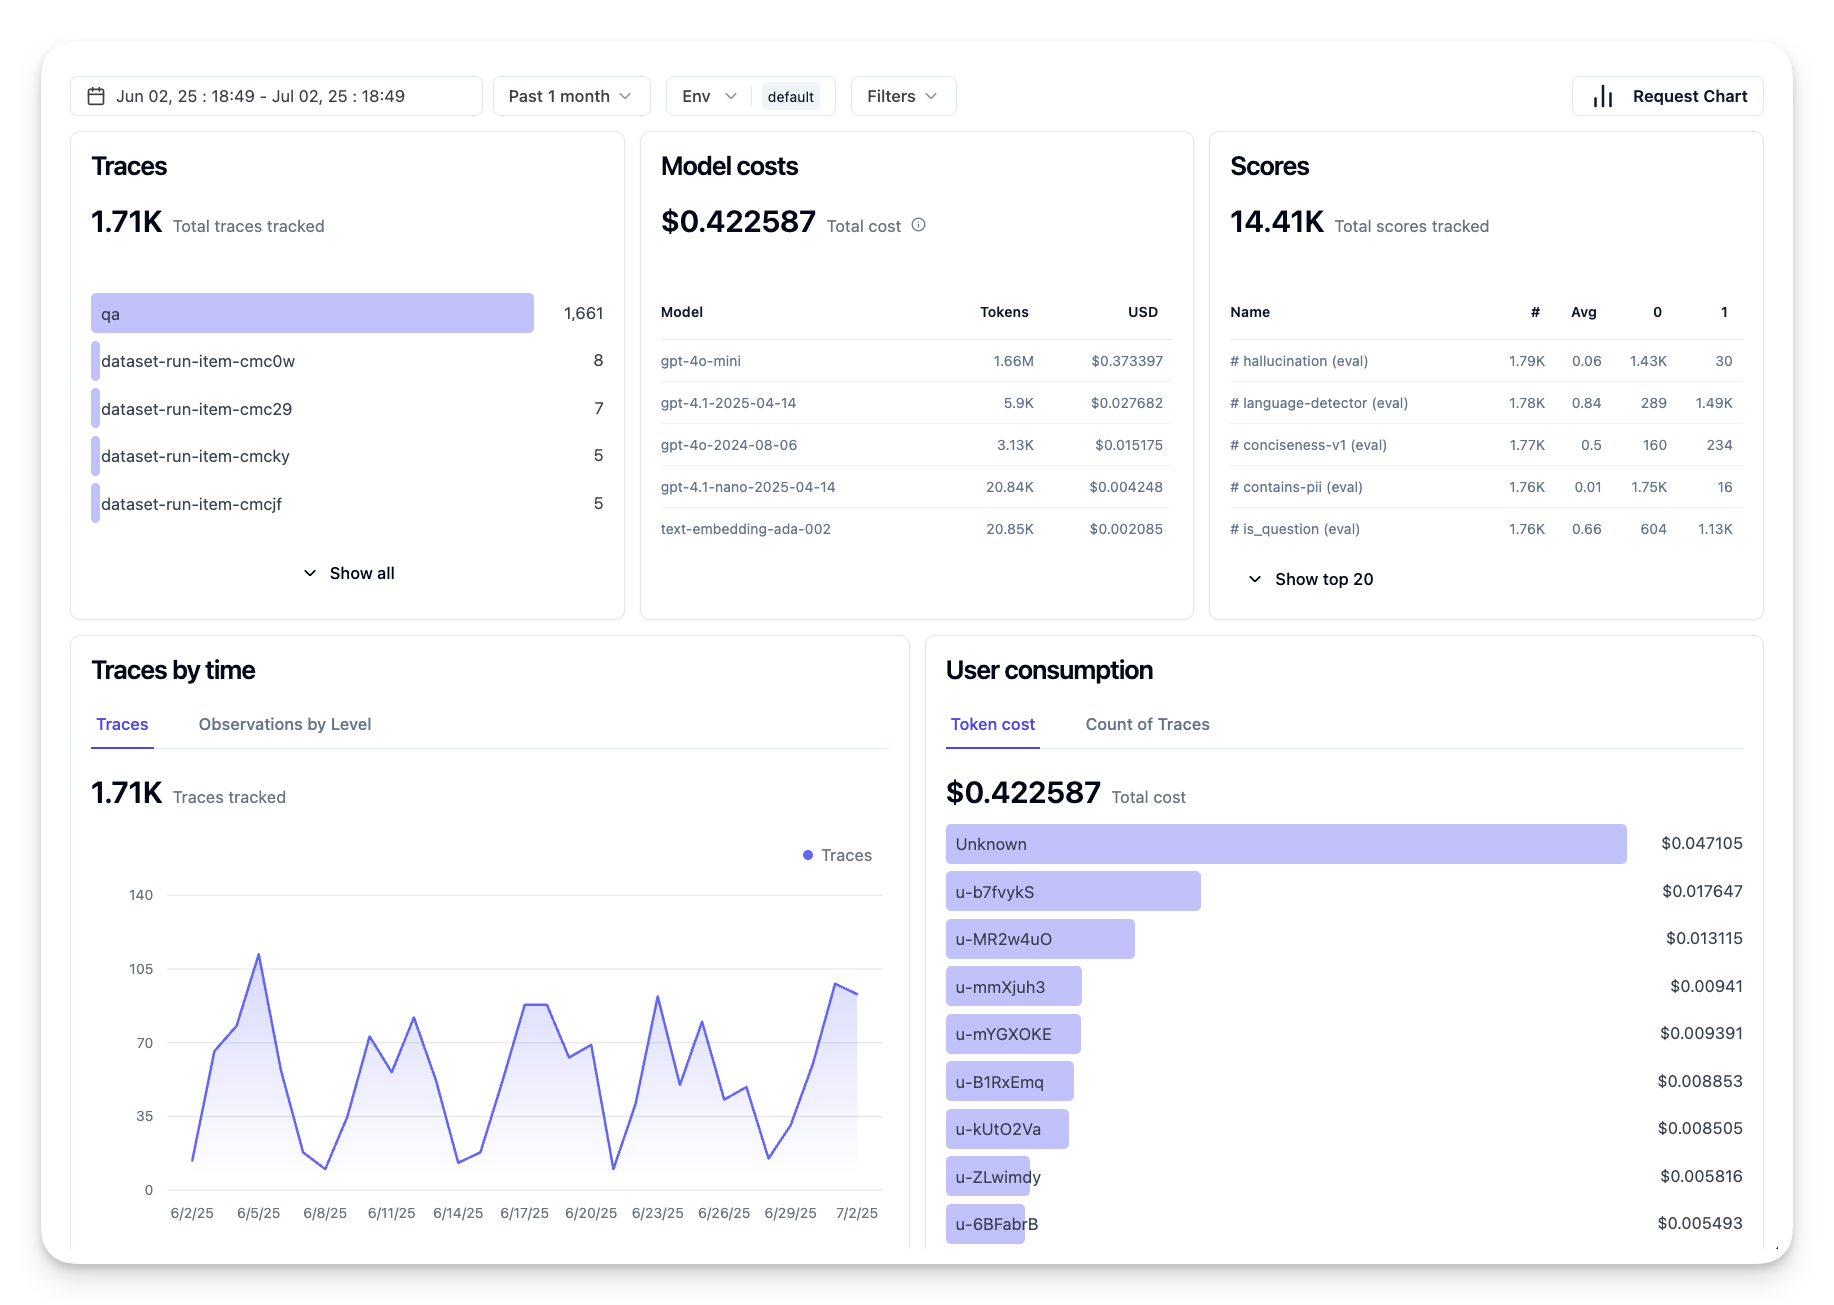
यसले एजेन्टलाई प्रत्यक्ष, वास्तविक-विश्व वातावरणमा मूल्यांकन गर्ने जनाउँछ, अर्थात उत्पादनमा वास्तविक प्रयोगको समयमा। अनलाइन मूल्यांकनले वास्तविक प्रयोगकर्ता अन्तरक्रियाहरूमा एजेन्टको प्रदर्शन अनुगमन गर्न र नतिजाहरूलाई निरन्तर विश्लेषण गर्न समावेश गर्दछ।
उदाहरणका लागि, तपाईंले सफलताको दर, प्रयोगकर्ता सन्तुष्टि अंक, वा वास्तविक ट्राफिकमा अन्य मेट्रिक्सहरू ट्र्याक गर्न सक्नुहुन्छ। अनलाइन मूल्यांकनको फाइदा यो हो कि यसले तपाईँले प्रयोगशालामा अनुमान नलगाउन सक्ने कुरा समात्छ – तपाईँले मोडेल विचलन समयसँगै देख्न सक्नुहुन्छ (यदि एजेन्टको प्रभावकारिता इनपुट ढाँचाहरू सर्दा घट्छ भने) र तपाईँले अनपेक्षित प्रश्नहरू वा अवस्थाहरू टिप्न सक्नुहुन्छ जुन परीक्षण डाटामा थिएन। यसले एजेन्टले जङ्गलमा कसरी व्यवहार गरिरहेको छ भन्ने साँचो चित्र प्रदान गर्दछ।
अनलाइन मूल्यांकन प्रायः अप्रत्यक्ष र प्रत्यक्ष प्रयोगकर्ता प्रतिक्रिया सङ्कलन समावेश गर्दछ, र सम्भवतः छायाँ परीक्षणहरू वा A/B परीक्षणहरू चलाउने (जहाँ एजेन्टको नयाँ संस्करण पुरानोको तुलनामा समानान्तर चल्छ) हुन्छ। चुनौती यो हो कि प्रत्यक्ष अन्तरक्रियाहरूका लागि भरपर्दो लेबलहरू वा स्कोरहरू प्राप्त गर्न मुस्किल पर्न सक्छ – तपाईं प्रयोगकर्ता प्रतिक्रियामा वा तलका मेट्रिक्सहरूमा निर्भर हुन सक्नुहुन्छ (उदाहरणका लागि प्रयोगकर्ताले परिणाम क्लिक गर्यो कि गरेन)।
दुवैलाई संयोजन गर्ने
अनलाइन र अफलाइन मूल्यांकनहरू परस्पर विरोधी होइनन्; तिनीहरू अत्यन्त पूरक छन्। अनलाइन अनुगमनबाट प्राप्त अन्तर्दृष्टिहरू (जस्तै नयाँ प्रकारका प्रयोगकर्ता प्रश्न जहाँ एजेन्ट खराब प्रदर्शन गर्छ) लाई प्रयोग गरेर अफलाइन परीक्षण डेटासेटहरूलाई वृद्धि र सुधार गर्न सकिन्छ। त्यसैगरी, जस एजेन्टहरू अफलाइन परीक्षणहरूमा राम्रो प्रदर्शन गर्छन् तिनीहरूलाई बढी विश्वासका साथ अनलाइन परिचालन गरिन्छ र अनुगमन गरिन्छ।
वास्तवमा, धेरै टोलीहरूले एउटा लूप अपनाउँछन्:
अफलाइन मूल्यांकन -> परिचालन -> अनलाइन अनुगमन -> नयाँ असफलता मामिला सङ्कलन -> अफलाइन डेटासेटमा थप -> एजेन्ट सुधार -> दोहोर्याउँ।
सामान्य समस्याहरू
तपाईं AI एजेन्टहरूलाई उत्पादनमा परिचालन गर्दा विभिन्न चुनौतीहरूको सामना गर्न सक्नुहुन्छ। यहाँ केही सामान्य समस्याहरू र सम्भावित समाधानहरू छन्:
| समस्या | सम्भावित समाधान |
|---|---|
| AI एजेन्टले कार्यहरू निरन्तर रूपमा ठीकसँग गर्दैन | - AI एजेन्टलाई दिइने प्रॉम्प्ट परिष्कृत गर्नुहोस्; उद्देश्यहरू स्पष्ट राख्नुहोस्। - कार्यलाई उपकार्यहरूमा विभाजन गरेर विभिन्न एजेन्टहरूद्वारा सम्हाल्न सकिने ठाउँ पहिचान गर्नुहोस्। |
| AI एजेन्टले निरन्तर रूटीन लूपहरूमा फस्दछ | - सुनिश्चित गर्नुहोस् स्पष्ट समाप्ति सर्तहरू र नियमहरू छन् जसले एजेन्टलाई प्रक्रिया कहिले रोक्ने थाहा हुन्छ। - तर्क र योजना आवश्यक जटिल कार्यहरूको लागि तर्क कार्यहरूमा विशेषज्ञता भएको ठूलो मोडेल प्रयोग गर्नुहोस्। |
| AI एजेन्टका उपकरण कलहरूले राम्रो प्रदर्शन गर्दैन | - उपकरणको नतिजा एजेन्ट प्रणाली बाहिर परीक्षण र प्रमाणित गर्नुहोस्। - परिभाषित प्यारामिटरहरू, प्रॉम्प्टहरू, र उपकरणहरूको नाम समायोजन गर्नुहोस्। |
| बहु एजेन्ट प्रणालीले निरन्तरता पूर्वक राम्रो प्रदर्शन गर्दैन | - प्रत्येक एजेन्टलाई दिइने प्रॉम्प्टहरू परिष्कृत गर्नुहोस् ताकि तिनीहरू एकअर्काबाट स्पष्ट र विशिष्ट हुन्। - उपयुक्त एजेन्ट पहिचान गर्न “राउटिङ” वा नियन्त्रण एजेन्ट उपयोग गरी पदानुक्रमित प्रणाली निर्माण गर्नुहोस्। |
सबैभन्दा धेरै यी समस्याहरू अवलोकनयोग्यता हुँदाहुँदै बढी प्रभावकारी रूपमा पहिचान गर्न सकिन्छ। माथि छलफल गरिएका ट्रेस र मेट्रिक्सहरूले एजेन्ट कार्यप्रवाहमा समस्या कहाँ छ ठ्याक्कै पत्ता लगाउन मद्दत गर्छ, जसले डिबगिङ र अनुकूलनलाई धेरै कुशल बनाउँछ।
लागत व्यवस्थापन
उत्पादनमा AI एजेन्टहरू परिचालन गर्दा लागत व्यवस्थापनका लागि यहाँ केही रणनीतिहरू छन्:
सानो मोडेलहरू प्रयोग गर्दै: साना भाषा मोडेलहरू (SLMs) ले केहि एजेन्टिक प्रयोगका मामिलाहरूमा राम्रो प्रदर्शन गर्न सक्छन् र लागतमा उल्लेखनीय बचत गराउनेछन्। पहिले उल्लेख गरेझैं, ठूलो मोडेलहरूसँगको प्रदर्शन तुलना गर्न र मूल्याङ्कन प्रणाली निर्माण गर्नु भनेको तपाईंको प्रयोग मामिलामा SLM कतिको राम्रो प्रदर्शन गर्नेछ बुझ्ने उत्तम तरिका हो। सरल कार्यहरू जस्तै उद्देश्य वर्गीकरण वा प्यारामिटर निकासी जस्ता कामहरूको लागि SLM हरू प्रयोग गर्ने विचार गर्नुहोस्, जबकि जटिल तर्कका लागि ठूलो मोडेलहरू आरक्षित राख्नुहोस्।
राउटर मोडेल प्रयोग गर्दै: समान रणनीति मोडेल र आकारहरूको विविधता प्रयोग गर्ने हो। तपाईं LLM/SLM वा सर्भरलेस फंक्शन प्रयोग गरेर जटिलताका आधारमा अनुरोधहरूलाई उत्तम मिल्ने मोडेलहरूसम्म मार्गनिर्देशन गर्न सक्नुहुन्छ। यसले लागत घटाउन मद्दत गर्नेछ र सही कामहरूमा प्रदर्शन सुनिश्चित गर्नेछ। उदाहरणका लागि, सरल प्रश्नहरूलाई साना, छिटो मोडेलहरूमा राउट गर्नुहोस् र जटिल तर्कका लागि मात्र महंगा ठूलो मोडेलहरू प्रयोग गर्नुहोस्।
प्रतिक्रियाहरू क्यास गर्दै: सामान्य अनुरोध र कार्यहरू पहिचान गरी एजेन्टिक प्रणालीमा जानुअघि प्रतिक्रिया प्रदान गर्नु समान अनुरोधहरूको मात्रा कम गर्ने राम्रो तरिका हो। तपाईं क्यास गरिएका अनुरोधहरूसँग अनुरोधको समानता कसरी छ भनेर पहिचान गर्न आधारभूत AI मोडेलहरू प्रयोग गरेर एक प्रवाह पनि कार्यान्वयन गर्न सक्नुहुन्छ। यस रणनीतिले अक्सर सोधिने प्रश्नहरू वा सामान्य काम प्रवाहहरूको लागि लागतमा उल्लेखनीय बचत गर्न सक्छ।
यो अभ्यासमा कसरी काम गर्छ हेरौं
यस सेग्मेन्टको उदाहरण नोटबुकमा, हामी कसरी अवलोकन उपकरणहरू प्रयोग गरेर हाम्रो एजेन्टको निगरानी र मूल्याङ्कन गर्न सक्छौं भन्ने उदाहरणहरू हेर्नेछौं।
उत्पादनमा AI एजेन्टहरू सम्बन्धी थप प्रश्नहरू छन्?
Microsoft Foundry Discord सँग सामेल हुनुहोस् जहाँ तपाईं अन्य सिक्नेहरूलाई भेट्न, अफिस हावरहरूमा सहभागी हुन र तपाईंका AI एजेन्टका प्रश्नहरूको उत्तर पाउन सक्नुहुन्छ।
अघिल्लो पाठ
अर्को पाठ
अस्वीकरण: यो दस्तावेज़ AI अनुवाद सेवा Co-op Translator प्रयोग गरेर अनुवाद गरिएको हो। हामी सही हुन प्रयास गर्छौं, तर कृपया जानकार हुनुस् कि स्वचालित अनुवादमा त्रुटिहरू वा अशुद्धताहरू हुन सक्छन्। मूल दस्तावेज़ यसको मूल भाषामा आधिकारिक स्रोत मानिनुपर्छ। महत्वपूर्ण जानकारीका लागि व्यावसायिक मानव अनुवाद सिफारिस गरिन्छ। यस अनुवादको प्रयोगबाट उत्पन्न कुनै पनि गलत बुझाइ वा त्रुटिको लागि हामी जिम्मेवार छैनौं।