ai-agents-for-beginners
ตัวแทน AI ในการผลิต: การสังเกตการณ์และการประเมินผล
เมื่อ ตัวแทน AI เคลื่อนจากต้นแบบทดลองสู่การใช้งานจริง ความสามารถในการเข้าใจพฤติกรรมของพวกเขา ตรวจสอบประสิทธิภาพ และประเมินผลลัพธ์อย่างเป็นระบบจะกลายเป็นสิ่งสำคัญ
เป้าหมายการเรียนรู้
หลังจบบทเรียนนี้ คุณจะรู้/เข้าใจ:
- แนวคิดหลักของการสังเกตการณ์และการประเมินผลของตัวแทน
- เทคนิคในการปรับปรุงประสิทธิภาพ ต้นทุน และประสิทธิผลของตัวแทน
- อะไรและวิธีการประเมินตัวแทน AI ของคุณอย่างเป็นระบบ
- วิธีควบคุมต้นทุนเมื่อนำตัวแทน AI ไปใช้ในงานจริง
- วิธีติดตั้งเครื่องมือให้กับตัวแทนที่สร้างด้วย Microsoft Agent Framework
เป้าหมายคือการมอบความรู้เพื่อเปลี่ยนตัวแทนที่เป็น “กล่องดำ” ให้กลายเป็นระบบที่โปร่งใส จัดการได้ และเชื่อถือได้
หมายเหตุ: สิ่งสำคัญคือต้องนำตัวแทน AI ที่ปลอดภัยและน่าเชื่อถือไปใช้งานด้วย ตรวจสอบบทเรียน Building Trustworthy AI Agents ด้วยเช่นกัน
ร่องรอยและช่วงเวลา
เครื่องมือสังเกตการณ์เช่น Langfuse หรือ Microsoft Foundry มักจะแสดงการทำงานของตัวแทนเป็นร่องรอยและช่วงเวลา
- ร่องรอย (Trace) แทนงานตัวแทนที่สมบูรณ์ตั้งแต่เริ่มจนเสร็จ (เช่น การจัดการคำถามของผู้ใช้)
- ช่วงเวลา (Spans) คือขั้นตอนย่อยแต่ละขั้นในร่องรอย (เช่น การเรียกใช้โมเดลภาษา หรือดึงข้อมูล)
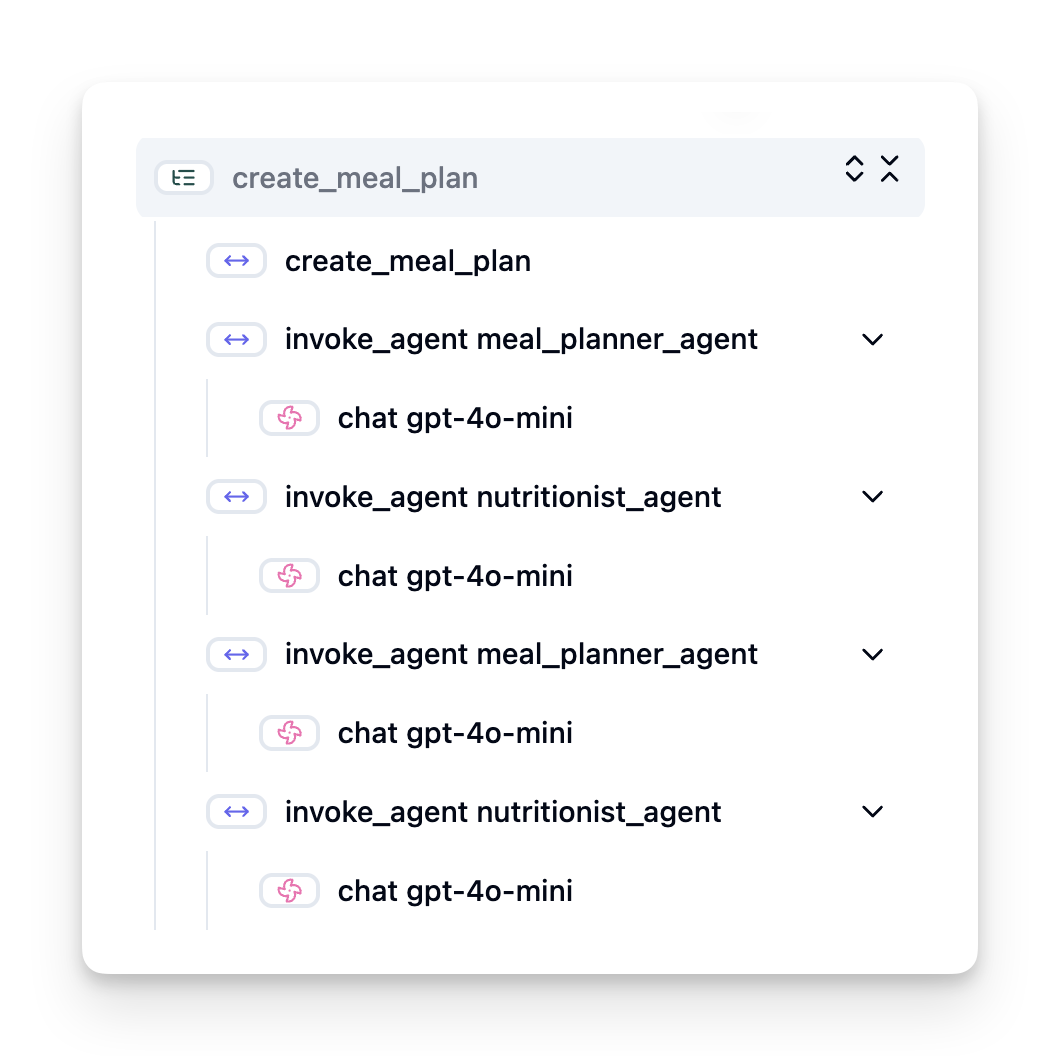
หากไม่มีการสังเกตการณ์ ตัวแทน AI จะรู้สึกเหมือน “กล่องดำ” - สถานะภายในและตรรกะไม่โปร่งใส ทำให้ยากต่อการวินิจฉัยปัญหาหรือปรับปรุงประสิทธิภาพ เมื่อมีการสังเกตการณ์ ตัวแทนจะกลายเป็น “กล่องแก้ว” ที่เปิดเผยโปร่งใส ซึ่งเป็นสิ่งสำคัญต่อการสร้างความเชื่อถือและรับประกันว่าทำงานได้ตามที่ตั้งใจไว้
ทำไมการสังเกตการณ์จึงสำคัญในสภาพแวดล้อมผลิต
การย้ายตัวแทน AI สู่สภาพแวดล้อมการผลิตนำมาซึ่งความท้าทายและข้อกำหนดใหม่ การสังเกตการณ์จึงไม่ได้เป็นแค่ “สิ่งที่ดีควรมี” แต่เป็นความสามารถที่สำคัญ:
- การแก้ไขบั๊กและวิเคราะห์สาเหตุ: เมื่อเกิดความล้มเหลวหรือลักษณะผลลัพธ์ไม่คาดคิด เครื่องมือสังเกตการณ์จะให้ร่องรอยที่จำเป็นในการชี้จุดต้นเหตุของข้อผิดพลาด ซึ่งสำคัญมากในตัวแทนที่ซับซ้อนที่อาจมีการเรียกหลายครั้งของ LLM การโต้ตอบเครื่องมือ และตรรกะตามเงื่อนไขต่างๆ
- การจัดการความหน่วงเวลาและค่าใช้จ่าย: ตัวแทน AI มักพึ่งพา LLM และ API ภายนอกซึ่งคิดค่าบริการต่อโทเคนหรือต่อการเรียกใช้งาน การสังเกตการณ์ช่วยติดตามการเรียกเหล่านี้อย่างแม่นยำ ช่วยระบุการทำงานที่ช้าหรือแพงเกินไป ทำให้ทีมสามารถปรับจูนคำสั่ง เลือกโมเดลที่มีประสิทธิภาพมากขึ้น หรือออกแบบขั้นตอนใหม่เพื่อลดต้นทุนและให้ประสบการณ์ผู้ใช้ที่ดี
- ความเชื่อถือ ความปลอดภัย และความสอดคล้อง: ในหลายกรณี การรับรองว่าตัวแทนประพฤติอย่างปลอดภัยและเป็นไปตามจริยธรรมเป็นสิ่งสำคัญ การสังเกตการณ์ให้เส้นทางตรวจสอบการทำงานและการตัดสินใจของตัวแทน ซึ่งช่วยตรวจจับและลดปัญหา เช่น การฉีดคำสั่ง, เนื้อหาที่เป็นอันตราย หรือการจัดการข้อมูลส่วนบุคคลผิดวิธี เช่น คุณสามารถตรวจร่องรอยเพื่อเข้าใจว่าทำไมตัวแทนถึงตอบด้วยคำตอบหนึ่งหรือใช้เครื่องมือใด
- วงจรปรับปรุงอย่างต่อเนื่อง: ข้อมูลการสังเกตการณ์เป็นฐานของกระบวนการพัฒนาที่เน้นทำซ้ำ โดยการติดตามการทำงานของตัวแทนในโลกจริง ทีมสามารถกำหนดจุดปรับปรุง รวบรวมข้อมูลเพื่อปรับแต่งโมเดล และตรวจสอบผลจากการเปลี่ยนแปลง ทำให้เกิดวงจรป้อนกลับที่ข้อมูลการประเมินออนไลน์ในงานจริงช่วยชี้แนะแบบทดลองและปรับปรุงออฟไลน์ นำไปสู่ประสิทธิภาพของตัวแทนที่ดีขึ้นอย่างต่อเนื่อง
ตัวชี้วัดสำคัญที่ควรติดตาม
เพื่อวัดและเข้าใจพฤติกรรมตัวแทน ควรติดตามตัวชี้วัดและสัญญาณต่างๆ แม้ว่าตัวชี้วัดเฉพาะจะขึ้นอยู่กับวัตถุประสงค์ของตัวแทน แต่มาตรฐานบางอย่างเป็นสากลและสำคัญ
ตัวอย่างตัวชี้วัดที่เครื่องมือสังเกตการณ์มักติดตามคือ:
ความหน่วงเวลา: ตัวแทนตอบสนองเร็วแค่ไหน? เวลารอนานส่งผลลบต่อประสบการณ์ผู้ใช้ คุณควรวัดความหน่วงเวลาของงานและแต่ละขั้นตอนโดยการติดตามการทำงานของตัวแทน เช่น หากตัวแทนใช้เวลารวม 20 วินาทีในการเรียกโมเดลทั้งหมด อาจเร่งความเร็วได้ด้วยการใช้โมเดลที่เร็วกว่า หรือเรียกโมเดลพร้อมกัน
ต้นทุน: ค่าใช้จ่ายต่อการทำงานแต่ละครั้งของตัวแทนเป็นเท่าไร? ตัวแทน AI พึ่งพาการเรียกใช้ LLM ที่คิดค่าบริการต่อโทเคนหรือ API ภายนอก การใช้เครื่องมือบ่อยครั้งหรือคำสั่งหลายชุดสามารถเพิ่มค่าใช้จ่ายอย่างรวดเร็ว เช่น ถ้าตัวแทนเรียก LLM ห้าครั้งเพื่อปรับปรุงคุณภาพเล็กน้อย คุณควรวัดว่าค่าใช้จ่ายนั้นคุ้มหรือไม่ หรือควรลดจำนวนการเรียกหรือใช้โมเดลราคาถูกกว่า การติดตามแบบเรียลไทม์ช่วยระบุการเพิ่มขึ้นที่ไม่คาดคิด (เช่น บั๊กทำให้เกิดลูป API ซ้ำ)
ข้อผิดพลาดคำขอ: มีคำขอกี่ครั้งที่ล้มเหลว? เช่น ข้อผิดพลาด API หรือการเรียกเครื่องมือที่ล้มเหลว เพื่อทำให้ตัวแทนมีความทนทานขึ้น คุณสามารถตั้งค่าการสำรองหรือการลองใหม่ เช่น หากผู้ให้บริการ LLM A ล่ม คุณเปลี่ยนไปใช้ผู้ให้บริการ B เป็นสำรอง
ความคิดเห็นผู้ใช้: การประเมินจากผู้ใช้โดยตรงให้ข้อมูลอันมีค่า เช่น การให้คะแนนชัดเจน (👍 ชอบ/👎 ไม่ชอบ, ⭐1-5 ดาว) หรือความคิดเห็นเป็นข้อความ หากได้รับข้อเสนอแนะลบต่อเนื่อง ควรเตือนว่าตัวแทนอาจทำงานไม่เป็นไปตามคาด
ความคิดเห็นผู้ใช้แฝง: พฤติกรรมผู้ใช้ให้ข้อเสนอแนะโดยไม่ต้องให้คะแนนชัดเจน เช่น การตั้งคำถามใหม่ทันที การถามซ้ำ หรือกดปุ่มลองใหม่ เช่น หากผู้ใช้ถามคำถามเดิมซ้ำๆ นั่นเป็นสัญญาณว่าตัวแทนอาจทำงานไม่ดี
ความถูกต้อง: ตัวแทนผลิตผลถูกหรือเป็นที่ต้องการบ่อยแค่ไหน? ความถูกต้องถูกกำหนดแตกต่างกัน (เช่น ความถูกต้องในการแก้ปัญหา, ความแม่นยำในการดึงข้อมูล, ความพึงพอใจของผู้ใช้) ขั้นตอนแรกคือกำหนดความหมายของความสำเร็จสำหรับตัวแทนของคุณ คุณสามารถติดตามความถูกต้องโดยการตรวจสอบอัตโนมัติ คะแนนประเมิน หรือป้ายบ่งชื่องานที่เสร็จสมบูรณ์ เช่น การติดป้ายร่องรอยว่า “สำเร็จ” หรือ “ล้มเหลว”
ตัวชี้วัดการประเมินอัตโนมัติ: คุณสามารถตั้งค่าการประเมินอัตโนมัติ เช่น การใช้ LLM ให้คะแนนผลลัพธ์ของตัวแทนว่าเป็นประโยชน์ แม่นยำ หรือไม่ นอกจากนี้ยังมีไลบรารีโอเพ่นซอร์สหลายตัวที่ช่วยให้คุณประเมินแง่มุมต่างๆ ของตัวแทน เช่น RAGAS สำหรับตัวแทน RAG หรือ LLM Guard เพื่อการตรวจจับภาษาที่เป็นอันตรายหรือการฉีดคำสั่ง
ในทางปฏิบัติ การรวมตัวชี้วัดเหล่านี้ช่วยให้เห็นภาพสุขภาพของตัวแทน AI ได้ดีที่สุด ใน สมุดตัวอย่างบทนี้ เราจะแสดงตัวอย่างจริงของตัวชี้วัดเหล่านี้แต่ก่อนอื่นเราจะเรียนรู้กระบวนการประเมินแบบทั่วไปก่อน
ติดตั้งเครื่องมือให้ตัวแทนของคุณ
เพื่อรวบรวมข้อมูลร่องรอย คุณต้องติดตั้งเครื่องมือให้โค้ดของคุณ เป้าหมายคือให้โค้ดตัวแทนส่งร่องรอยและตัวชี้วัดที่แพลตฟอร์มสังเกตการณ์สามารถเก็บ ประมวลผล และแสดงผลได้
OpenTelemetry (OTel): OpenTelemetry กลายเป็นมาตรฐานอุตสาหกรรมสำหรับการสังเกตการณ์ LLM มีชุด API, SDK และเครื่องมือสำหรับการสร้าง เก็บ และส่งข้อมูลเทเลเมทรี
มีกลุ่มไลบรารีติดตั้งเครื่องมือที่ห่อหุ้มกรอบงานตัวแทนที่มีอยู่และช่วยให้ส่ง OpenTelemetry spans ไปยังเครื่องมือสังเกตการณ์ได้ง่าย Microsoft Agent Framework รวม OpenTelemetry ไว้โดยตรง ด้านล่างคือตัวอย่างการติดตั้งเครื่องมือให้ตัวแทน MAF:
from agent_framework.observability import get_tracer, get_meter

tracer = get_tracer()
meter = get_meter()

with tracer.start_as_current_span("agent_run"):
    # Agent execution is traced automatically
    pass
สมุดตัวอย่าง ในบทนี้จะแสดงวิธีติดตั้งเครื่องมือให้ตัวแทน MAF ของคุณ
การสร้าง Span ด้วยตนเอง: แม้ไลบรารีติดตั้งเครื่องมือจะช่วยได้มาก แต่บางครั้งต้องการข้อมูลละเอียดหรือแบบกำหนดเอง คุณสามารถสร้าง spans ด้วยตนเองเพื่อเพิ่มตรรกะแอปพลิเคชันเฉพาะ และเติมเต็ม spans ที่สร้างขึ้นอัตโนมัติหรือตามต้องการด้วยแอตทริบิวต์ (หรือแท็ก/เมทาดาทา) ที่กำหนดเอง แอตทริบิวต์เหล่านี้อาจรวมข้อมูลธุรกิจ การคำนวณระหว่างทาง หรือบริบทที่มีประโยชน์ต่อการดีบักหรือตรวจสอบ เช่น user_id, session_id, หรือ model_version
ตัวอย่างการสร้างร่องรอยและช่วงเวลาด้วยตนเองด้วย Langfuse Python SDK:
from langfuse import get_client

langfuse = get_client()

span = langfuse.start_span(name="my-span")

span.end()
การประเมินตัวแทน
การสังเกตการณ์ให้ตัวชี้วัด แต่การประเมินเป็นกระบวนการวิเคราะห์ข้อมูลนั้น (และทดสอบ) เพื่อกำหนดว่าตัวแทน AI ทำงานได้ดีแค่ไหนและจะปรับปรุงอย่างไร กล่าวคือ เมื่อคุณมีร่องรอยและตัวชี้วัดแล้ว คุณจะใช้มันตัดสินตัวแทนและตัดสินใจอย่างไร
การประเมินอย่างสม่ำเสมอสำคัญเพราะตัวแทน AI มักไม่แน่นอนและสามารถวิวัฒนาการได้ (ผ่านการอัปเดตหรือพฤติกรรมโมเดลที่เปลี่ยนไป) – หากไม่มีการประเมิน คุณจะไม่ทราบว่า “ตัวแทนอัจฉริยะ” ของคุณทำงานได้ดีหรือถดถอยลง
การประเมินสำหรับตัวแทน AI มีสองประเภท: การประเมินออนไลน์ และ การประเมินออฟไลน์ ทั้งสองมีคุณค่าและเสริมกัน ปกติเหมาะเริ่มจากการประเมินออฟไลน์เพราะเป็นขั้นตอนขั้นต่ำก่อนนำตัวแทนไปใช้
การประเมินออฟไลน์
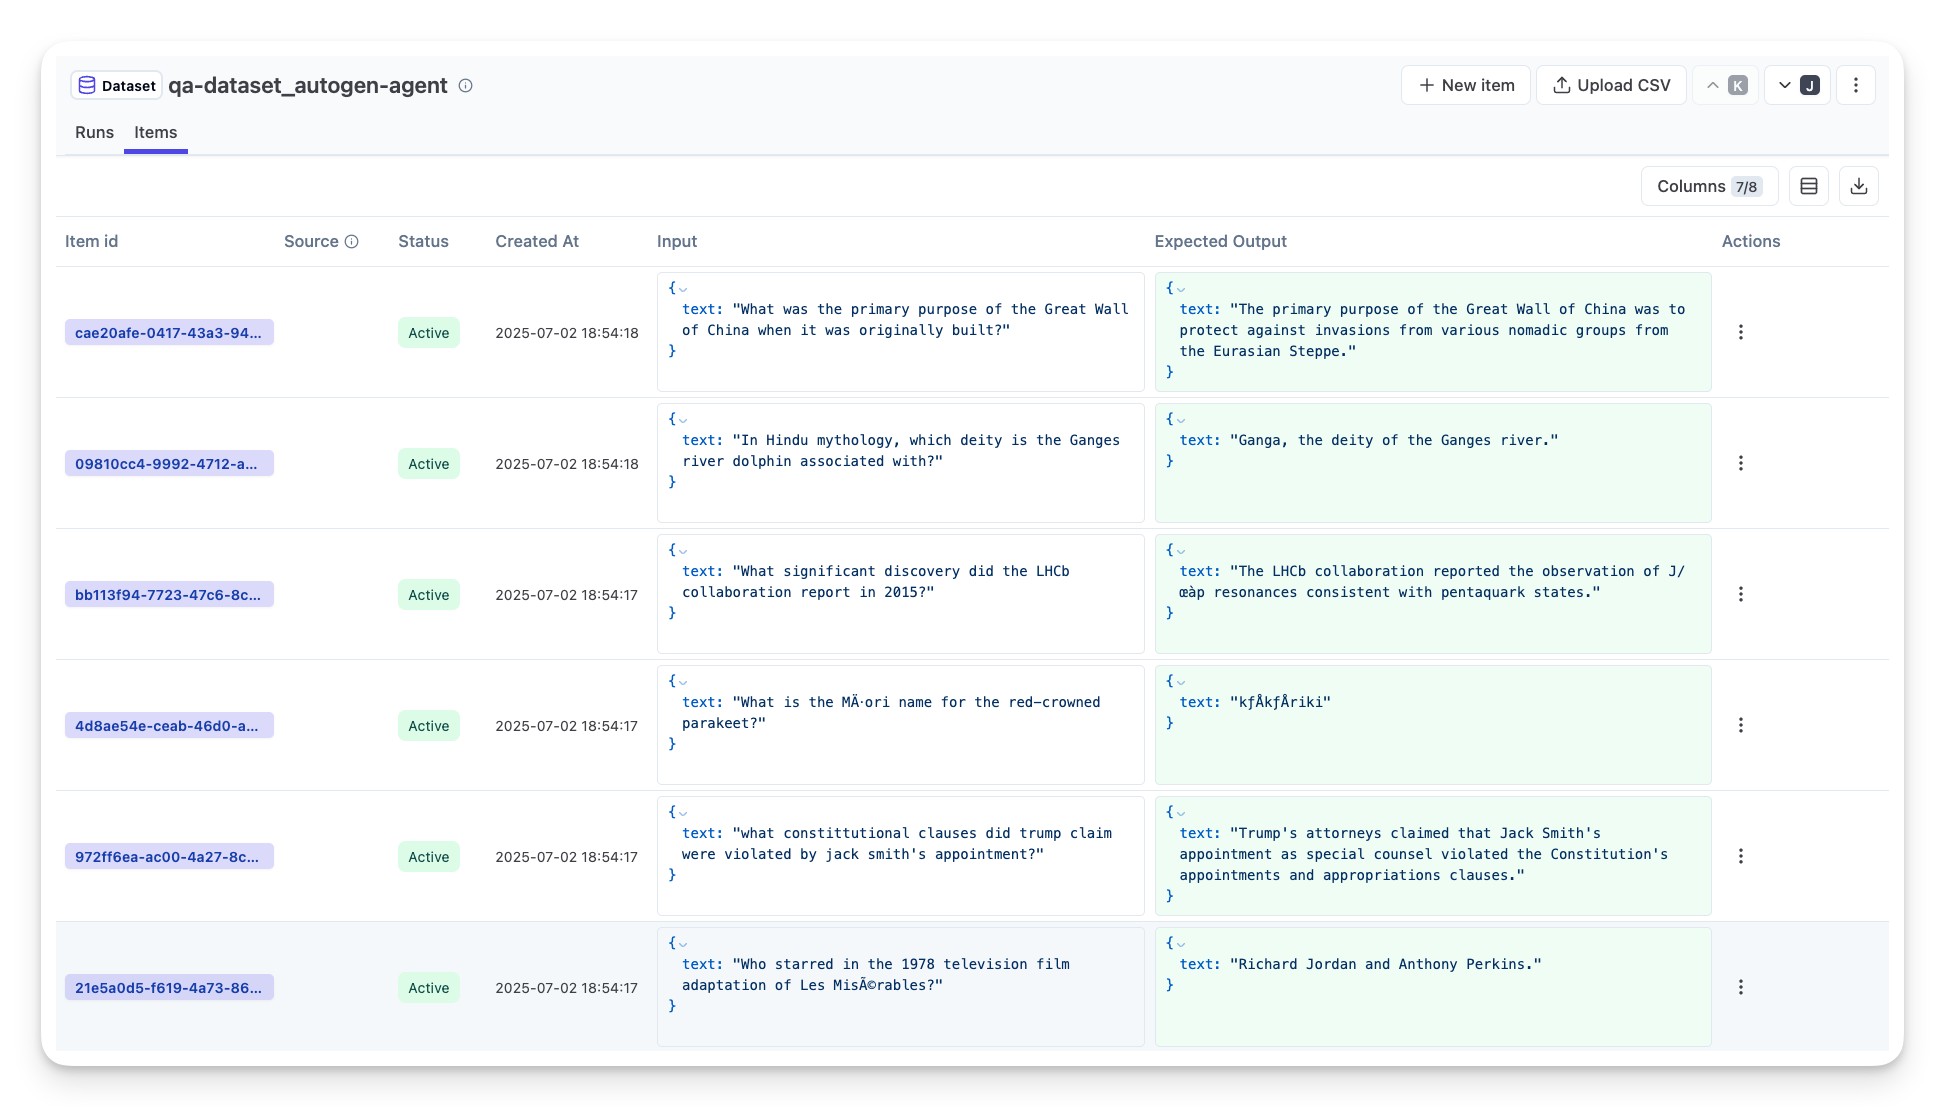
คือการประเมินตัวแทนในสภาพแวดล้อมควบคุม โดยใช้ชุดข้อมูลทดสอบ ไม่ใช่คำถามผู้ใช้จริง ใช้ชุดข้อมูลที่คัดสรรซึ่งรู้ผลลัพธ์หรือพฤติกรรมที่ถูกต้อง จากนั้นเรียกตัวแทนทำงานกับชุดนั้น
ยกตัวอย่าง หากคุณสร้างตัวแทนแก้โจทย์คณิตศาสตร์ คุณอาจมี ชุดข้อมูลทดสอบ 100 ปัญหาพร้อมคำตอบล่วงหน้า การประเมินออฟไลน์ทำในช่วงพัฒนา (และอาจเป็นส่วนหนึ่งของ CI/CD) เพื่อเช็คการปรับปรุงหรือตรวจจับการถดถอย ข้อดีคือตรวจซ้ำได้และได้ตัวชี้วัดความแม่นยำชัดเจนเพราะมีข้อมูลจริง คุณอาจจำลองคำถามผู้ใช้และวัดคำตอบเทียบคำตอบวิเคราะห์หรือใช้ตัวชี้วัดอัตโนมัติตามที่กล่าวไว้ก่อนหน้านี้
ปัญหาหลักของการประเมินออฟไลน์คือการรับประกันว่าชุดข้อมูลทดสอบครบถ้วนและทันสมัย — ตัวแทนอาจทำงานได้ดีในชุดทดสอบที่ตายตัวแต่มาพบคำถามต่างกันในงานจริง ดังนั้นคุณจึงควรอัปเดตชุดทดสอบด้วยเคสพิเศษและตัวอย่างใหม่ที่สะท้อนสถานการณ์ในโลกจริง การผสมชุดทดสอบเล็กสำหรับตรวจสอบรวดเร็วและชุดใหญ่สำหรับวัดประสิทธิภาพกว้างๆ เป็นประโยชน์
การประเมินออนไลน์
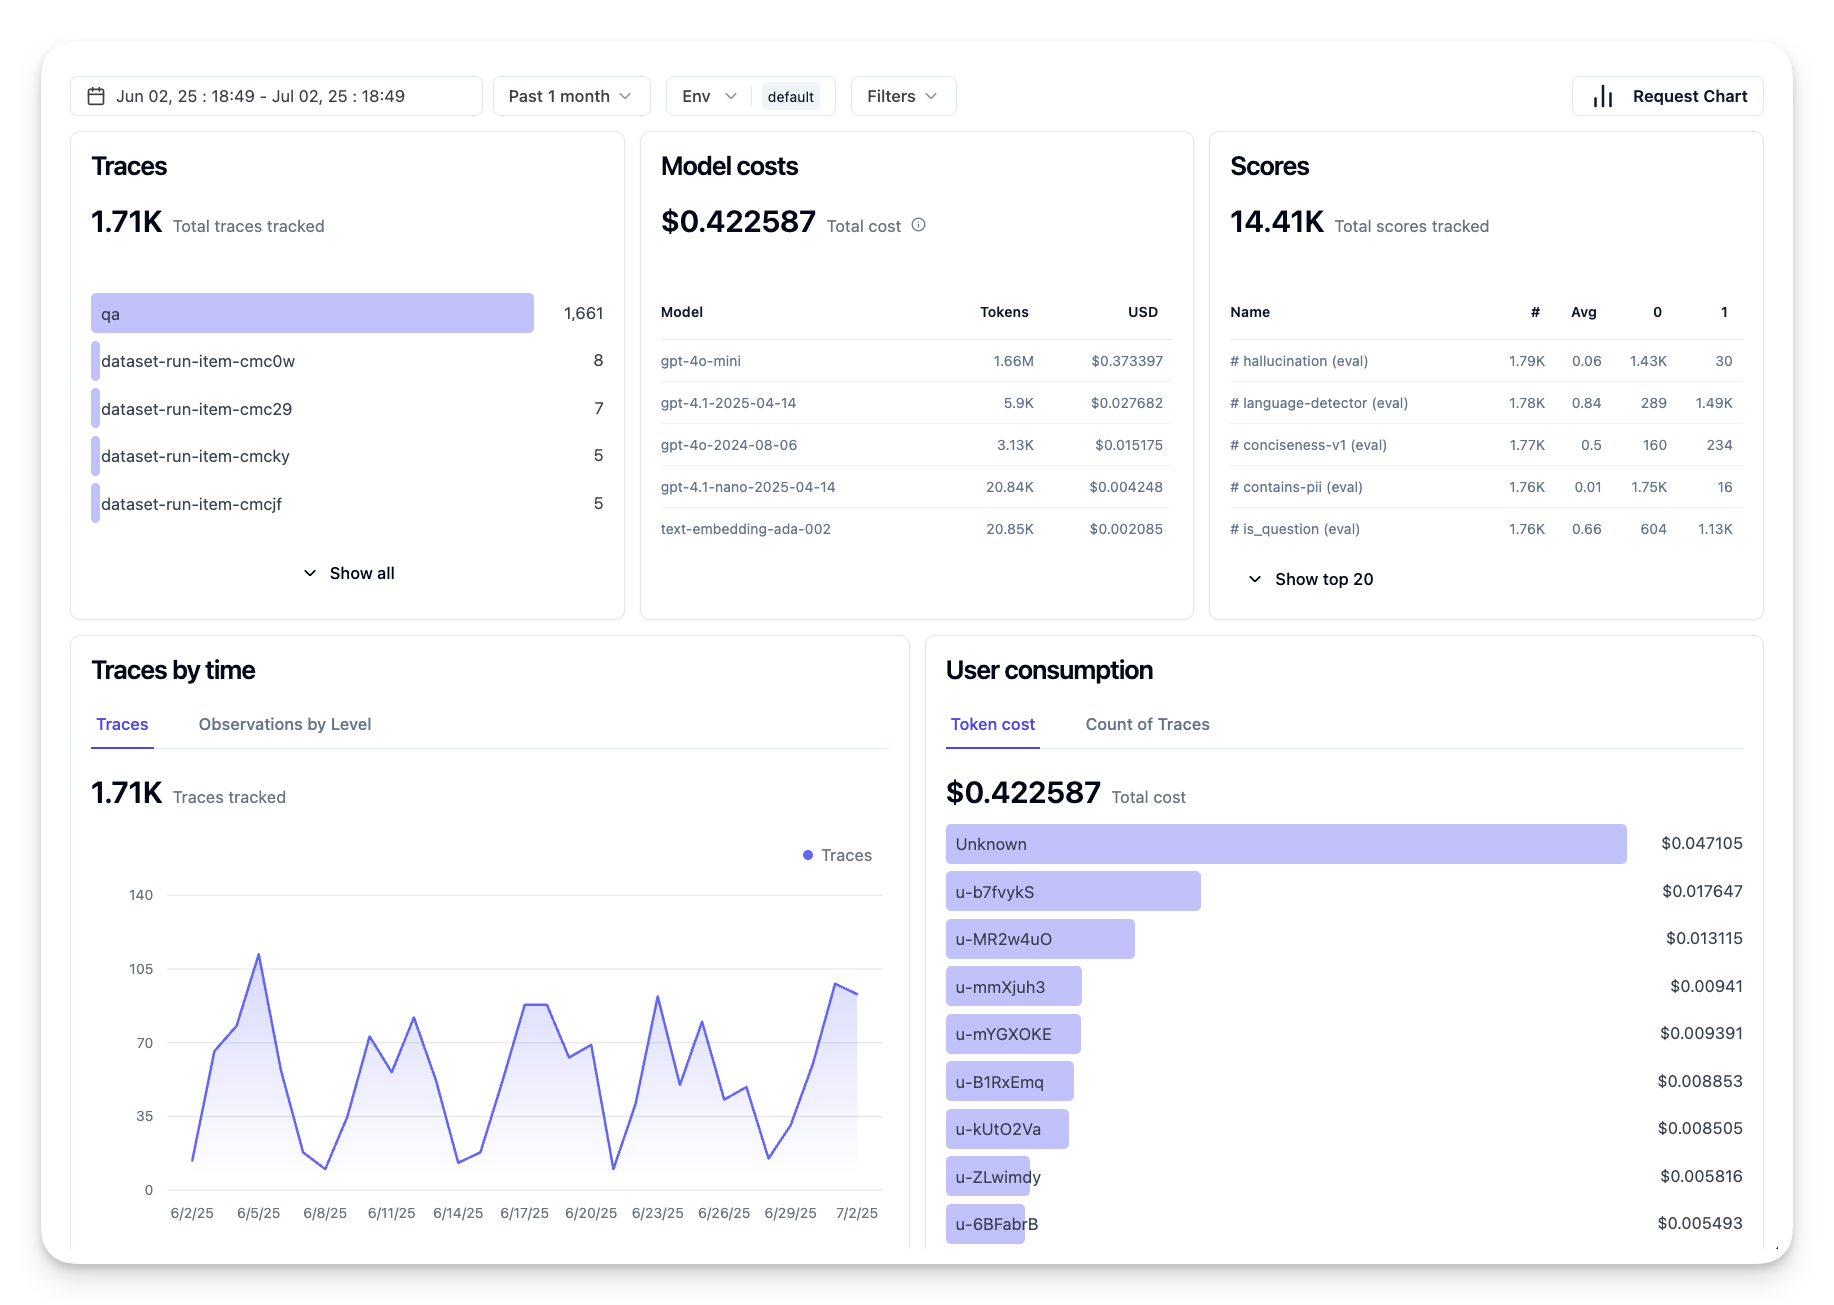
คือการประเมินตัวแทนในสภาพแวดล้อมจริงและใช้งานอยู่ เช่น ในการใช้งานจริงในงานผลิต การประเมินออนไลน์เกี่ยวข้องกับการติดตามประสิทธิภาพของตัวแทนในปฏิสัมพันธ์ผู้ใช้จริงและวิเคราะห์ผลอย่างต่อเนื่อง
ตัวอย่างเช่น คุณอาจติดตามอัตราความสำเร็จ คะแนนความพึงพอใจ หรือเครื่องชี้วัดอื่นๆ ในข้อมูลเรียลไทม์ ข้อดีของการประเมินออนไลน์คือมันถ่ายทอดสิ่งที่คุณอาจไม่คาดคิดในห้องทดลอง — คุณเห็นการเบี่ยงเบนโมเดลเมื่อเวลาผ่านไป (ถ้าประสิทธิภาพตัวแทนลดลงเมื่อรูปแบบอินพุตเปลี่ยน) และจับคำถามหรือตัวสถานการณ์ไม่คาดคิดที่ไม่ได้อยู่ในชุดทดสอบ มันให้ภาพแท้จริงของพฤติกรรมตัวแทนในโลกจริง
การประเมินออนไลน์มักมีการเก็บข้อเสนอแนะผู้ใช้แบบแฝงและชัดเจนตามที่กล่าว และอาจทดสอบแบบเงาหรือ A/B test (ที่เวอร์ชันตัวแทนใหม่ทำงานคู่ขนานเพื่อเปรียบเทียบกับเวอร์ชันเก่า) ความท้าทายคือการได้คะแนนหรือตัวชี้วัดที่น่าเชื่อถือสำหรับปฏิสัมพันธ์สดอาจยาก — อาจต้องพึ่งพาข้อเสนอแนะผู้ใช้หรือเครื่องชี้วัดปลายน้ำ (เช่น ผู้ใช้คลิกผลการค้นหาหรือไม่)
การผสมผสานทั้งสอง
การประเมินออนไลน์และออฟไลน์ไม่ใช่สิ่งที่แยกจากกัน แต่เสริมซึ่งกันและกัน ข้อมูลจากการตรวจสอบออนไลน์ (เช่น ประเภทคำถามใหม่ที่ตัวแทนทำงานไม่ดี) สามารถใช้เสริมชุดข้อมูลทดสอบออฟไลน์ และในทางกลับกัน ตัวแทนที่ทำงานดีในชุดทดสอบออฟไลน์ก็สามารถนำไปใช้งานและติดตามออนไลน์ได้อย่างมั่นใจ
หลายทีมใช้ลูปนี้:
ประเมินออฟไลน์ -> นำไปใช้ -> ติดตามออนไลน์ -> รวบรวมกรณีล้มเหลวใหม่ -> เพิ่มชุดข้อมูลออฟไลน์ -> ปรับแต่งตัวแทน -> ทำซ้ำ
ปัญหาทั่วไป
ขณะที่คุณนำตัวแทน AI ไปใช้จริง คุณอาจเจอความท้าทายต่างๆ ต่อไปนี้คือปัญหาทั่วไปและวิธีแก้ไขที่เป็นไปได้:
| ปัญหา | วิธีแก้ไขที่เป็นไปได้ |
|---|---|
| ตัวแทน AI ทำงานไม่สม่ำเสมอ | - ปรับปรุงคำสั่งที่ให้ตัวแทน AI; ชัดเจนในเป้าหมาย - หาจุดที่แยกงานเป็นงานย่อยและแจกจ่ายให้ตัวแทนหลายตัวช่วยได้ |
| ตัวแทน AI เข้าสู่ลูปซ้ำไม่หยุด | - กำหนดเงื่อนไขและข้อกำหนดการสิ้นสุดให้ชัดเจน เพื่อให้ตัวแทนรู้เมื่อควรหยุด - สำหรับงานซับซ้อนที่ต้องใช้เหตุผลและวางแผน ใช้โมเดลใหญ่ที่เชี่ยวชาญด้านนี้ |
| เรียกใช้เครื่องมือของตัวแทน AI แล้วผลลัพธ์ไม่ดี | - ทดสอบและตรวจสอบผลลัพธ์เครื่องมือภายนอกระบบตัวแทน - ปรับจูนพารามิเตอร์ คำสั่ง และชื่อเครื่องมือ |
| ระบบหลายตัวแทนทำงานไม่สม่ำเสมอ | - ปรับคำสั่งที่ให้แต่ละตัวแทนให้ชัดเจนและแตกต่างกัน - สร้างระบบลำดับชั้นด้วยตัวแทน “ตัวกลาง” หรือควบคุมเพื่อเลือกตัวแทนที่ถูกต้อง |
หลายปัญหานี้สามารถระบุได้มีประสิทธิภาพมากขึ้นด้วยการมีระบบสังเกตการณ์ที่ติดตั้ง ร่องรอยและตัวชี้วัดที่กล่าวมาแล้วช่วยชี้จุดปัญหาในขั้นตอนโฟลว์ของตัวแทน ทำให้การแก้ไขบั๊กและปรับปรุงมีประสิทธิภาพสูงขึ้น
การจัดการต้นทุน
นี่คือกลยุทธ์บางประการในการจัดการต้นทุนเมื่อนำตัวแทน AI ไปใช้จริง
การใช้โมเดลขนาดเล็ก: โมเดลภาษาขนาดเล็ก (SLMs) สามารถทำงานได้ดีในกรณีการใช้งานที่มุ่งเน้นตัวแทนบางประเภท และจะช่วยลดต้นทุนอย่างมาก อย่างที่กล่าวไว้ก่อนหน้านี้ การสร้างระบบประเมินผลเพื่อกำหนดและเปรียบเทียบประสิทธิภาพกับโมเดลที่ใหญ่กว่านั้น เป็นวิธีที่ดีที่สุดในการเข้าใจว่า SLM จะทำงานได้ดีแค่ไหนในกรณีการใช้งานของคุณ พิจารณาใช้ SLM สำหรับงานที่ง่ายกว่าเช่น การจำแนกเจตนา หรือการดึงพารามิเตอร์ ในขณะที่เก็บโมเดลที่ใหญ่กว่าสำหรับการให้เหตุผลที่ซับซ้อน
การใช้โมเดลตัวนำทาง: กลยุทธ์ที่คล้ายกันคือการใช้โมเดลและขนาดที่หลากหลาย คุณสามารถใช้ LLM/SLM หรือฟังก์ชันแบบไม่มีเซิร์ฟเวอร์เพื่อนำทางคำขอตามความซับซ้อนไปยังโมเดลที่เหมาะสมที่สุด ซึ่งจะช่วยลดต้นทุนในขณะเดียวกันก็รับประกันประสิทธิภาพในงานที่เหมาะสม ตัวอย่างเช่น นำทางคำถามง่ายๆ ไปยังโมเดลที่เล็กกว่าและเร็วกว่า และใช้โมเดลขนาดใหญ่มากที่มีค่าใช้จ่ายสูงเฉพาะสำหรับงานการให้เหตุผลที่ซับซ้อน
การแคชคำตอบ: การระบุคำขอและงานที่พบบ่อยและให้คำตอบก่อนที่คำขอจะผ่านระบบตัวแทนของคุณ เป็นวิธีที่ดีในการลดปริมาณคำขอที่เหมือนกัน คุณยังสามารถดำเนินการไหลขั้นตอนเพื่อระบุว่าคำขอใกล้เคียงกับคำขอที่แคชไว้แค่ไหนโดยใช้โมเดล AI ที่พื้นฐานกว่า กลยุทธ์นี้สามารถลดต้นทุนได้อย่างมากสำหรับคำถามที่ถูกถามบ่อยหรือเวิร์กโฟลว์ที่ใช้บ่อย
มาดูวิธีการทำงานเหล่านี้ในทางปฏิบัติกัน
ใน โน้ตบุ๊กตัวอย่างของส่วนนี้ เราจะเห็นตัวอย่างวิธีที่เราสามารถใช้เครื่องมือสังเกตการณ์เพื่อตรวจสอบและประเมินตัวแทนของเรา
มีคำถามเพิ่มเติมเกี่ยวกับ AI Agents ในการใช้งานจริงไหม?
เข้าร่วม Microsoft Foundry Discord เพื่อพบปะกับผู้เรียนคนอื่นๆ เข้าร่วมชั่วโมงทำงาน และรับคำตอบสำหรับคำถามเกี่ยวกับ AI Agents ของคุณ
บทเรียนก่อนหน้า
บทเรียนถัดไป
ปฏิเสธความรับผิดชอบ: เอกสารนี้ได้รับการแปลโดยใช้บริการแปลภาษา AI Co-op Translator ขณะที่เราพยายามให้ความถูกต้อง โปรดทราบว่าการแปลโดยอัตโนมัติอาจมีข้อผิดพลาดหรือความไม่ถูกต้อง เอกสารต้นฉบับในภาษาต้นทางควรถูกพิจารณาเป็นแหล่งข้อมูลที่เชื่อถือได้ สำหรับข้อมูลที่สำคัญ แนะนำให้ใช้การแปลโดยมนุษย์มืออาชีพ เราไม่รับผิดชอบต่อความเข้าใจผิดหรือการตีความที่ผิดพลาดที่เกิดขึ้นจากการใช้การแปลนี้