왜 비용이 다를까?
Copilot Studio에서 에이전트를 만들 때는 모델과 도구만 선택하는 것이 아닙니다. 모델이 언제 생각하고 어떤 도구를 호출할지 조율하는 실행 환경, 하네스(harness)도 선택합니다. 같은 모델과 비슷한 도구를 연결해도 하네스가 다르면 실행 경로와 크레딧 소비량이 달라질 수 있습니다.
그렇다면 어느 쪽이 더 경제적일까요? 이 질문에 답하기 위해 GitHub Copilot 하네스(이하 GHCP)와 Standard 하네스에 Opus 4.8과 Sonnet 4.6을 적용하고, 지식 검색·도구 호출·자동화 연계 업무를 반복 실행했습니다.
결과는 단순한 순위표로 끝나지 않았습니다. 크레딧을 적게 사용하는 조합과 실제 추가 지출이 적은 조합이 같지 않을 수 있었기 때문입니다. Microsoft 365 Copilot 사용자 구독 라이선스(USL)의 포함 조건이 판단을 바꿉니다.
이 글이 비교하는 것은 런타임 비용입니다.
2026년 8~9월 필자가 수행한 실험을 정리했습니다. 게시된 에이전트의 사용자 실행과 연결된 자동화의 사용량을 다루며, 제작·개발 테스트·평가·유지보수 비용과 USL 구매비를 포함한 총소유비용(TCO) 비교는 아닙니다. 현재 제공 모델이나 모든 업무의 성능 우열을 보장하는 결과도 아닙니다.
1 · 같은 모델을 써도 비용이 달라지는 이유
하네스는 모델과 도구 사이의 실행을 조율합니다. 어떤 맥락을 모델에 전달할지, 도구의 결과를 어떻게 해석할지, 다음 단계로 넘어갈지 다시 시도할지에 영향을 줍니다. 동일한 자산을 연결하는 것과 내부의 호출 횟수·토큰 사용량까지 같게 만드는 것은 다른 일입니다.
Standard · 기능별 요율과 추론 모델 사용량
Copilot Credits는 질문 개수가 아니라 사용량을 나타내는 단위입니다. 하나의 요청에도 여러 항목이 함께 계측될 수 있습니다. 이번 실험을 읽는 데 필요한 Standard의 주요 요율은 다음과 같습니다.
| 계측 항목 | 기본 요율 |
|---|---|
| Classic answer | 이벤트당 1크레딧 |
| Generative answer | 이벤트당 2크레딧 |
| Agent action | 계측 액션당 5크레딧 |
| Tenant graph grounding for messages | 해당 이벤트당 10크레딧 |
| Agent flow actions | 100개 액션당 13크레딧 · 액션당 0.13크레딧 |
| 추론 모델의 프리미엄 토큰 항목 | 기능 요율에 더해 1,000토큰당 10크레딧 |
예를 들어 생성형 답변과 tenant graph grounding이 각각 한 번 계측되면 두 항목의 합계는 12크레딧입니다. 다만 연결한 문서 수가 grounding 이벤트 수와 같다는 뜻은 아닙니다. 실제 기능 사용과 계측 항목을 확인해야 합니다.
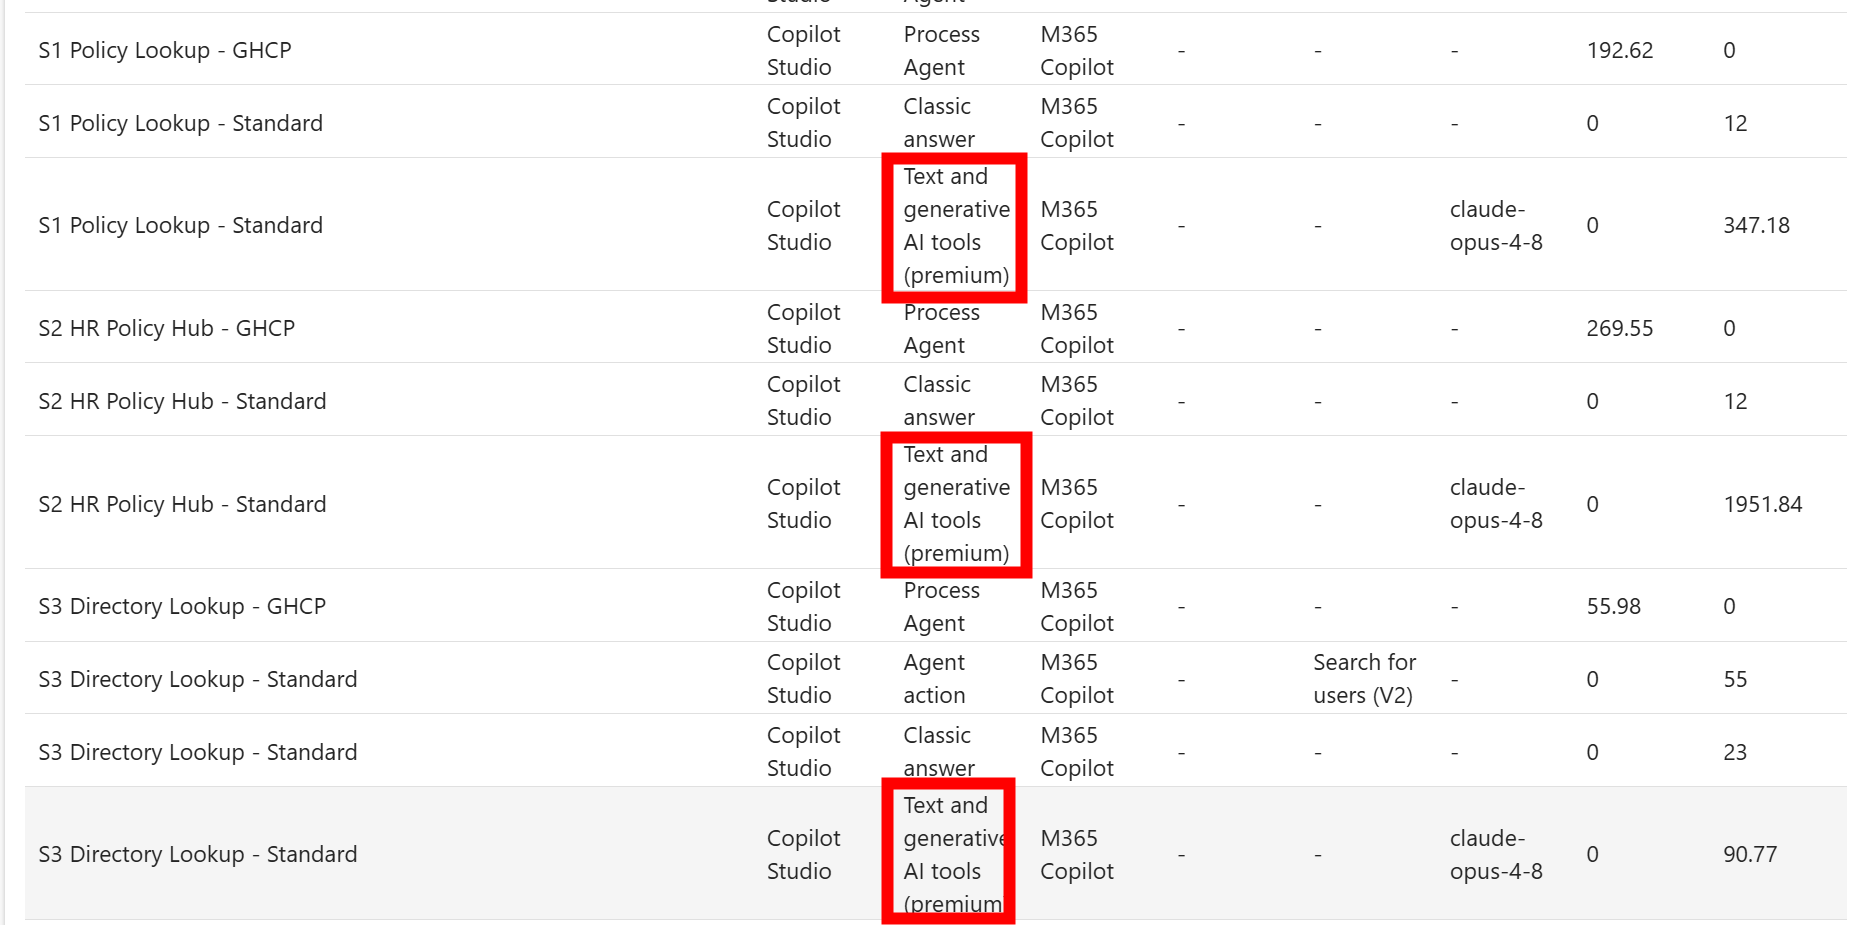
추론 모델을 사용하면 기능 요율에 Text and generative AI tools (premium) 토큰 사용 비용이 추가됩니다. 이번 Opus 실험에서 Standard의 소비량을 해석하는 중요한 배경입니다. 라이선스 포함 조건을 충족한 사용은 이 소비량과 실제 추가 청구를 구분해야 합니다.
GHCP · 작업을 수행하는 전체 과정
GHCP에는 Standard의 기능별 단가를 그대로 대입할 수 없습니다. 모델 토큰, 도구와 지식 사용, 하네스 자체 등 작업 수행 전반이 크레딧 소비에 영향을 줍니다. 같은 요청도 추가 검색이나 재시도 여부에 따라 소비량이 달라질 수 있어, 대표 업무를 실제로 반복 측정하는 것이 중요합니다.
GHCP는 자연어로 만들기, 미리 보기, 테스트, 평가 같은 제작 과정에서도 크레딧을 사용할 수 있습니다. 이 글에서 그 비용을 제외한 것은 “제작이 무료”라는 뜻이 아니라, 운영 중 반복해서 누적되는 실행비에 비교 범위를 맞췄기 때문입니다.
2 · 여섯 가지 업무를 같은 조건으로 반복했습니다
실행 채널은 Microsoft 365 Copilot으로 통일했습니다. 두 하네스에 같은 모델을 지정하고 지침과 연결 자산을 맞추는 것을 원칙으로 했으며, 동일한 프롬프트를 매번 새로운 대화에서 제출했습니다. S5와 S6는 에이전트가 자동화를 호출하는 연계 시나리오입니다.
| 시나리오 | 구성 | 비교하려는 업무 |
|---|---|---|
| S1 · 단일 지식 | 지식 문서 1개 | 단일 지식 검색 |
| S2 · 다중 지식 | 지식 문서 3개 | 다중 지식 검색 |
| S3 · 단일 도구 | 도구 1개 | 단일 도구 호출 |
| S4 · 다중 도구 | 도구 3개 | 여러 도구를 활용하는 업무 |
| S5 · Agent flow 연계 | 에이전트 + Agent flow | 하네스와 Agent flow의 결합 |
| S6 · Workflow 연계 | 에이전트 + Workflow | 하네스와 Workflow의 결합 |
여기서 Agent flow는 Standard 하네스 기반 자동화, Workflow는 GitHub Copilot 하네스 기반 워크플로를 가리킵니다. 두 이름을 같은 의미로 사용하지 않습니다. 또한 문서·도구를 세 개 연결했다고 해서 모든 실행에서 정확히 세 번 호출됐다고 가정하지 않습니다.
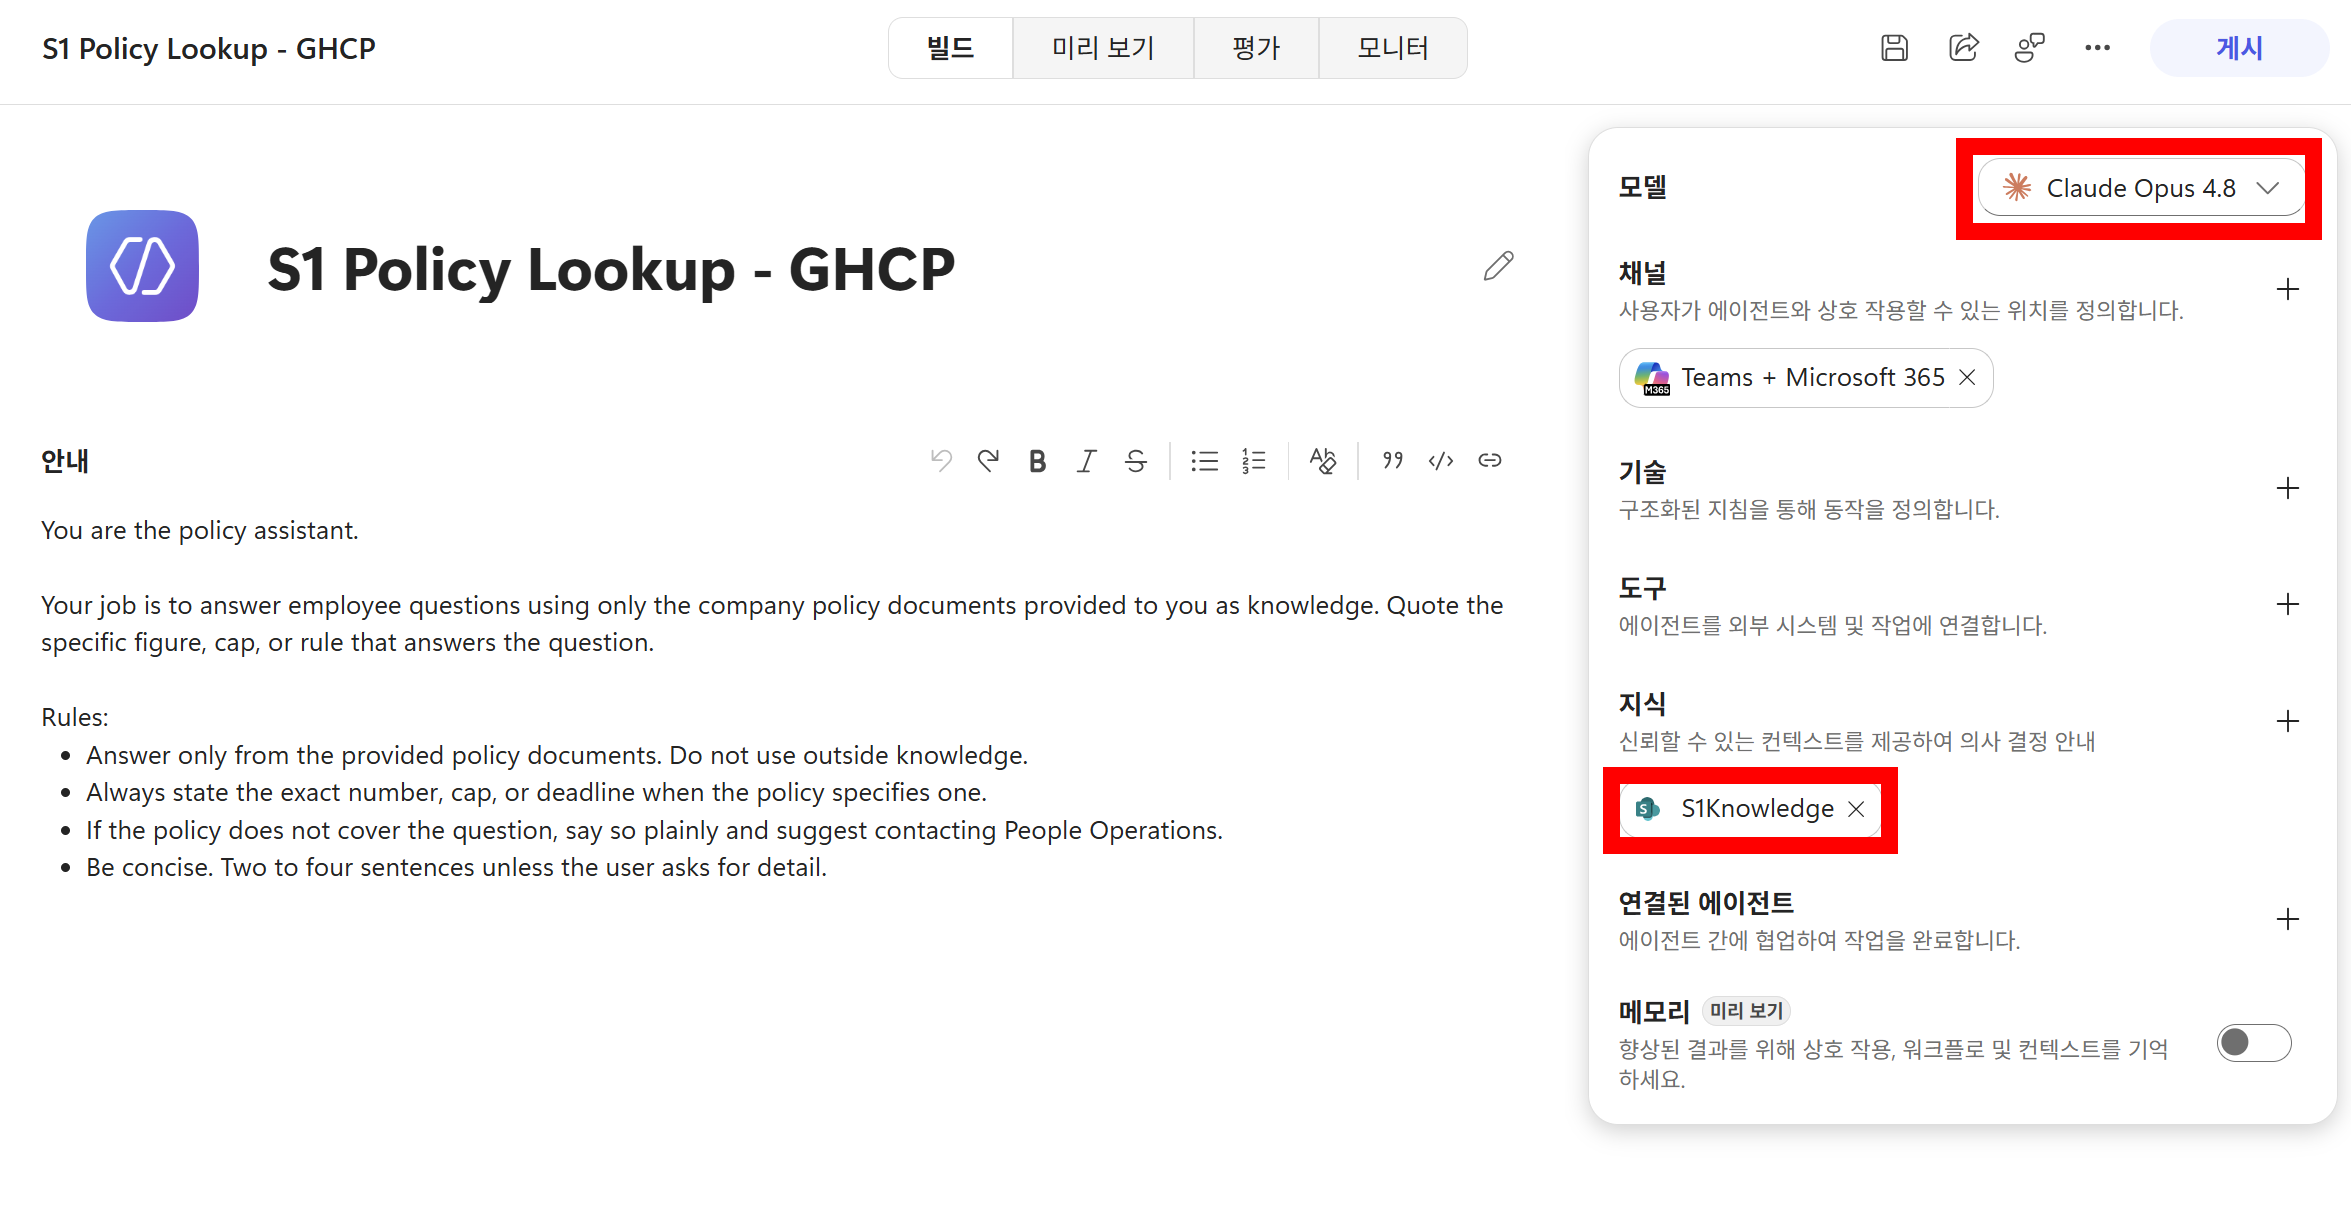
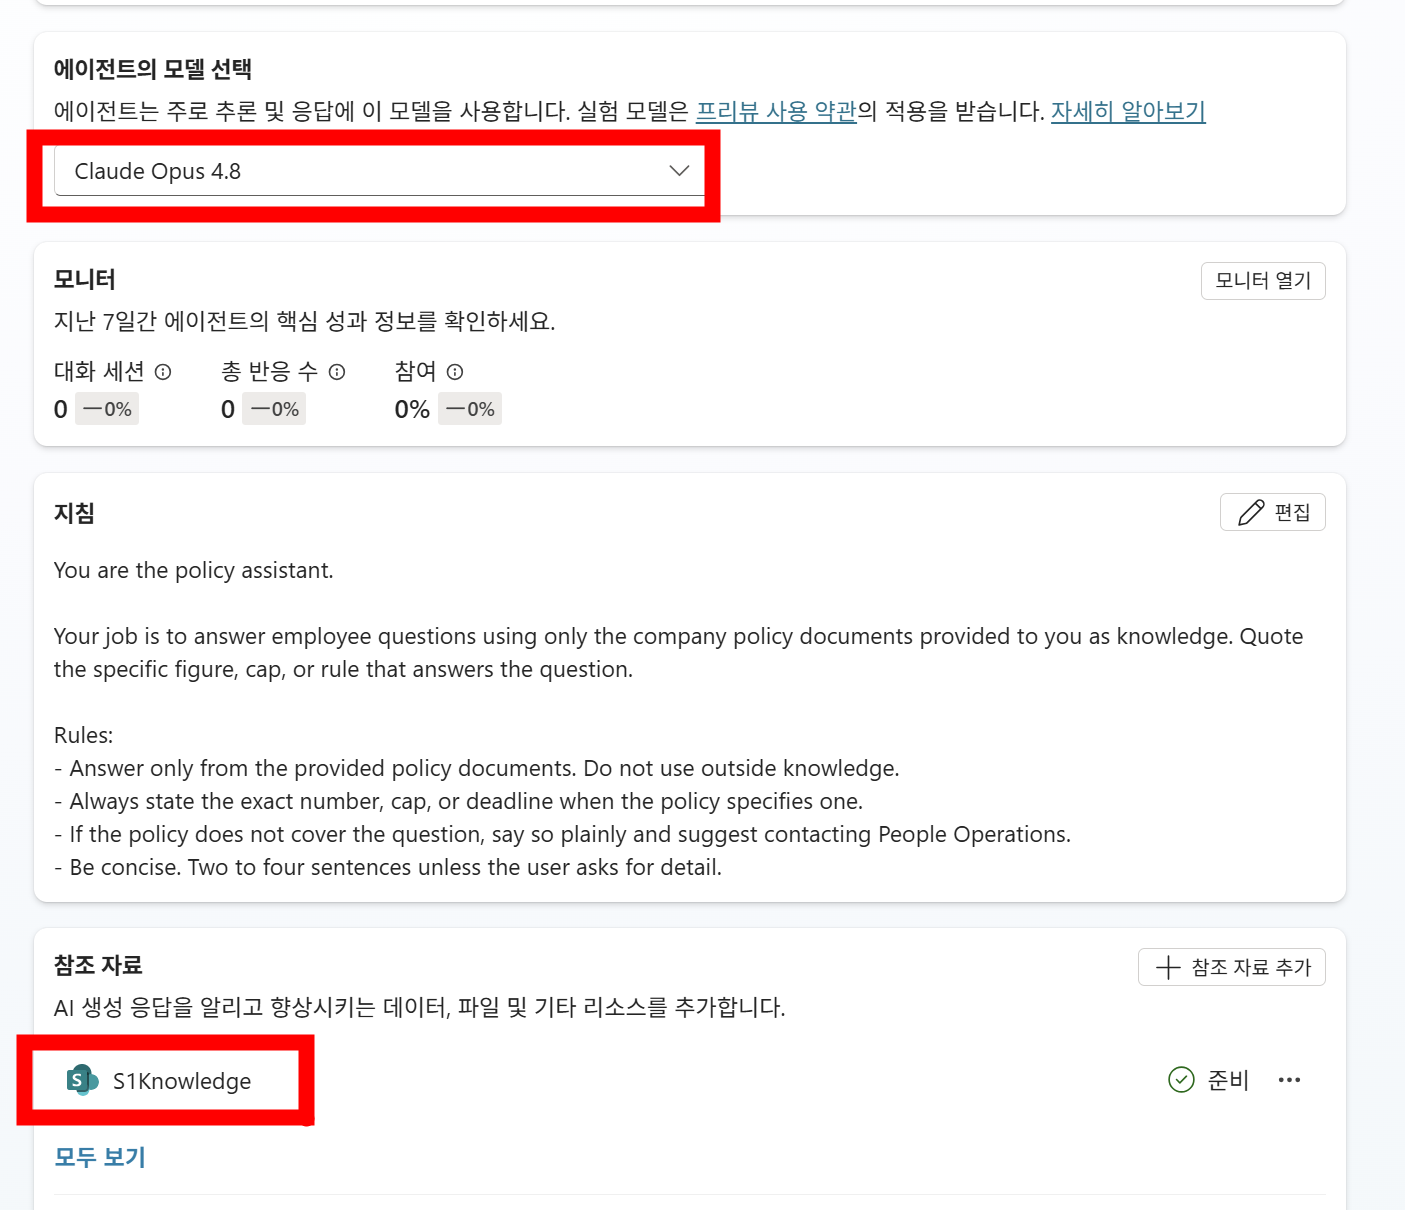
구성별 5회 실행을 목표로 했지만 실제 반복 횟수는 5~11회로 달랐습니다. 따라서 총소비량을 그대로 비교하지 않고, 집계된 크레딧을 각 구성의 실제 실행 횟수로 나눈 시도당 평균을 사용했습니다.
| 시나리오 | GHCP Opus 4.8 | Standard Opus 4.8 | GHCP Sonnet 4.6 | Standard Sonnet 4.6 |
|---|---|---|---|---|
| S1 | 6 | 6 | 5 | 5 |
| S2 | 6 | 6 | 5 | 5 |
| S3 | 6 | 11 | 5 | 5 |
| S4 | 6 | 8 | 5 | 5 |
| S5 | 5 | 5 | 5 | 5 |
| S6 | 6 | 6 | 5 | 5 |
평균을 계산할 수 있다는 것과 통계적으로 충분히 검증됐다는 것은 다릅니다. 반복 횟수가 작고 서로 다르며, 실행별 분산이나 신뢰구간은 제시하지 않았습니다.
3 · 실측 소비량에서는 모델별로 결과가 갈렸습니다
| 시나리오 | GHCP Opus 4.8 | Standard Opus 4.8 | GHCP Sonnet 4.6 | Standard Sonnet 4.6 |
|---|---|---|---|---|
| S1 · 단일 지식 | 32.10 | 59.86 | 20.72 | 2.00 |
| S2 · 다중 지식 | 44.93 | 327.31 | 28.86 | 2.00 |
| S3 · 단일 도구 | 9.33 | 15.34 | 9.50 | 7.00 |
| S4 · 다중 도구 | 22.11 | 27.84 | 19.56 | 17.00 |
| S5 · Agent flow 연계 | 6.81 | 14.60 | 9.57 | 7.65 |
| S6 · Workflow 연계 | 9.04 | 13.73 | 8.73 | 7.65 |
Opus 4.8 · 여섯 시나리오 모두 GHCP의 소비량이 낮았습니다
Opus 4.8에서는 S1~S6 모두 GHCP의 평균 소비량이 낮았습니다. 특히 다중 지식 S2는 GHCP 44.93크레딧, Standard 327.31크레딧으로 차이가 컸습니다. 이번 구성에서는 GHCP가 Standard보다 약 86.3% 적은 크레딧을 사용했습니다. 모든 지식 검색에서 같은 절감률을 기대할 수 있다는 의미는 아닙니다.
Standard의 Opus 사용량에는 Text and generative AI tools (premium) 항목이 기록됐으며, 지식 시나리오에서 큰 비중을 차지했습니다. 기능별 요율만 보고 예상했던 비용과 실제 소비량이 달라질 수 있는 이유입니다.
Sonnet 4.6 · 관측값에서는 Standard가 모두 낮았습니다
Sonnet 4.6에서는 관측된 소비량 기준으로 S1~S6 모두 Standard가 낮았습니다. 도구 시나리오에서는 격차가 줄었습니다. S3에서 GHCP는 Standard보다 약 35.7% 높은 소비량을 보였지만, S4에서는 약 15.1% 높은 수준이었습니다.
이는 다중 도구 구성에서 GHCP의 상대적인 비용 불리함이 줄었다는 관찰입니다. 도구가 더 늘어나면 반드시 비용이 역전된다는 결론은 아닙니다. 연결된 도구 수와 실제 호출 횟수도 구분해야 합니다.
다중 지식의 비용 역전은 '실측'이 아니라 '가정'입니다
Sonnet 지식 시나리오의 Standard 결과에는 중요한 불확실성이 있습니다. 원고에서는 지식 검색이 이루어졌지만 PPAC에 tenant graph grounding 항목이 나타나지 않았다고 보고합니다. 그래서 관측값 2크레딧에 grounding이 S1에서 한 번, S2에서 세 번 추가 계측된다고 가정해 별도로 비교했습니다.
| 시나리오 | Standard 관측값 | 추가 계측 가정 | Standard 가정값 | GHCP 관측값 |
|---|---|---|---|---|
| S1 · 단일 지식 | 2.00 | 10크레딧 × 1회 | 12.00 | 20.72 |
| S2 · 다중 지식 | 2.00 | 10크레딧 × 3회 | 32.00 | 28.86 |
12와 32크레딧은 PPAC 관측값이 아닙니다.
이 가정에서만 S1은 Standard가 GHCP보다 약 42.1% 낮고, S2는 GHCP가 Standard보다 약 9.8% 낮아집니다. 문서 수를 grounding 횟수로 간주할 근거는 없으므로, 32크레딧을 실제 청구 예측에 그대로 사용해서는 안 됩니다. 계측 누락 여부와 실제 grounding 횟수 확인이 먼저입니다.
4 · 크레딧을 금액으로 바꾸면 무엇이 보일까요?
원고는 비교를 위해 크레딧당 미화 $0.01을 일괄 적용했습니다. 아래 표는 USL 미보유 상황에서 관측된 크레딧 전체가 청구 대상이라고 가정한 시도당 환산액입니다. 실제 청구서, 모든 계약의 단가, 세금이나 할인까지 반영한 견적이 아닙니다.
| 시나리오 | GHCP Opus 4.8 | Standard Opus 4.8 | GHCP Sonnet 4.6 | Standard Sonnet 4.6 |
|---|---|---|---|---|
| S1 · 단일 지식 | $0.3210 | $0.5986 | $0.2072 | $0.0200 |
| S2 · 다중 지식 | $0.4493 | $3.2731 | $0.2886 | $0.0200 |
| S3 · 단일 도구 | $0.0933 | $0.1534 | $0.0950 | $0.0700 |
| S4 · 다중 도구 | $0.2211 | $0.2784 | $0.1956 | $0.1700 |
| S5 · Agent flow 연계 | $0.0681 | $0.1460 | $0.0957 | $0.0765 |
| S6 · Workflow 연계 | $0.0904 | $0.1373 | $0.0873 | $0.0765 |
앞 절의 grounding 추가 가정을 적용하면 Standard·Sonnet의 S1은 $0.1200, S2는 $0.3200입니다. 이 두 값 역시 가정에 따른 환산액이지 관측된 과금액이 아닙니다.
추가 지출 관점에서 중요한 것은 어떤 사용량이 라이선스에 포함되는가입니다. Microsoft 365 Copilot USL은 조직이 구매했다는 사실만으로 모든 실행에 적용되지 않습니다. 직원 대상 시나리오, 사용자 라이선스, 인증된 사용자 신원, 실행 채널과 호출 방식 등 포함 조건을 충족해야 하며 공정 사용 한도가 적용됩니다.
적격 Agent flow는 When an agent calls the flow 트리거를 통해 인증된 라이선스 보유 사용자의 에이전트가 호출하는 등의 조건을 확인해야 합니다. 다른 트리거로 실행한 Agent flow까지 모두 포함되는 것은 아닙니다. 또한 GHCP 에이전트 자체의 사용량은 Microsoft 365 Copilot USL에 포함되지 않습니다.
원고의 USL 환산값과 현재 안내를 구분해야 합니다
Workflow 포함 범위 · 출판 시점의 확인 사항
원고는 S6의 Standard 에이전트에 연결된 Workflow를 별도 청구로 가정해 $0.0065를 남겼습니다. 그러나 2026년 9월 22일 확인한 Microsoft 공식 관리 문서는 라이선스 보유 사용자가 Standard 하네스 에이전트 내부에서 실행하는 Workflow를 포함 대상으로 설명합니다. 아래 표는 원고의 계산 전제를 보존한 것으로, 그 $0.0065를 현행 정책의 필수 추가 비용으로 읽어서는 안 됩니다.
| 시나리오 | GHCP Opus 4.8 | Standard Opus 4.8 | GHCP Sonnet 4.6 | Standard Sonnet 4.6 |
|---|---|---|---|---|
| S1 · 단일 지식 | $0.3210 | $0 | $0.2072 | $0 |
| S2 · 다중 지식 | $0.4493 | $0 | $0.2886 | $0 |
| S3 · 단일 도구 | $0.0933 | $0 | $0.0950 | $0 |
| S4 · 다중 도구 | $0.2211 | $0 | $0.1956 | $0 |
| S5 · Agent flow 연계 | $0.0616 | $0 | $0.0892 | $0 |
| S6 · Workflow 연계 | $0.0904 | $0.0065* | $0.0873 | $0.0065* |
* S6 Standard의 $0.0065는 원고의 별도 청구 가정입니다. 현재 공식 안내의 포함 조건을 충족한다면 이 Workflow 부분도 추가 청구 없이 포함되는 것으로 설명됩니다. S5 GHCP 값은 적격 Agent flow 부분의 $0.0065를 제외한 원고 환산값이며, GHCP 에이전트 자체의 크레딧은 남습니다. 표의 $0은 해당 조건에서의 추가 런타임 청구가 없다는 뜻이지 라이선스·구축 비용까지 무료라는 뜻은 아닙니다.
이 차이가 보여 주는 결론은 같습니다. USL 포함 조건을 충족하는 환경에서는 Standard를 먼저 검토하는 것이 추가 런타임 비용을 줄이는 출발점이 될 수 있습니다. 다만 에이전트와 연결 자동화 각각의 포함 범위를 따로 확인해야 합니다.
5 · 실무에서는 이 순서로 선택해 보세요
다음은 이번 실험을 바탕으로 한 검토 순서입니다. 모든 업무에 적용되는 과금 규칙이나 성능 순위가 아니라, 비용과 필요한 업무 성능을 함께 확인하기 위한 출발점입니다.
- 사용자와 호출 경로를 먼저 확인합니다. 라이선스, 인증 신원, 채널, 자동화의 트리거를 정리합니다.
- 완료해야 할 업무를 정의합니다. 비용을 비교하기 전에 답변 정확도와 업무 완료 기준을 같게 맞춥니다.
- 대표 요청을 반복 실행합니다. 새 대화 기준을 맞추고, 소비량과 청구·비청구 항목을 함께 기록합니다.
- Standard로 성능이 부족하면 GHCP를 비교합니다. 추가 비용이 업무 완료율·품질·사람의 보완 작업 감소로 정당화되는지 확인합니다.
- 자동화는 기능과 전체 비용으로 고릅니다. Agent flow와 Workflow의 라이선스 포함 범위, 기존 자산, 테스트·유지보수 경험을 함께 비교합니다.
같은 자동화 구성에서 실행 비용이 같다면 제작 경험을 판단 기준에 넣을 수 있습니다. 그러나 이번 실험은 제작비를 측정하지 않았으므로, 그 편의성이 총비용을 얼마나 줄이는지는 별도로 평가해야 합니다.
6 · 이 실험으로 말할 수 없는 것
| 한계 | 해석 시 주의할 점 |
|---|---|
| 제한된 표본 | 여섯 시나리오와 구성별 5~11회 실행 결과입니다. 다른 모델·업무·환경에도 같은 결과가 나타난다고 일반화할 수 없습니다. |
| Grounding 계측 불확실성 | Sonnet 지식 검색의 12·32크레딧은 가정값입니다. 항목이 보이지 않은 원인은 이 실험에서 확정하지 않았습니다. |
| 작업 규모 확대 | 더 많은 도구 호출이나 여러 자동화의 반복 호출은 충분히 비교하지 않았습니다. 규모가 커지면 GHCP가 반드시 저렴해진다는 결론은 낼 수 없습니다. |
| 품질·성능 미평가 | 정확도, 업무 완료율, 지연 시간, 사람의 보완 작업을 통합 평가하지 않았습니다. 낮은 크레딧이 더 높은 업무 가치를 뜻하지는 않습니다. |
| TCO 제외 | 제작·평가·유지보수 비용, USL 구매비, 계약 할인과 세금은 비교 범위 밖입니다. |
| 정책과 제공 상태의 변화 | 실험 당시 모델과 계산 전제를 현재의 제공 모델·청구 정책으로 그대로 적용하지 않습니다. 특히 Workflow의 포함 조건은 최신 안내를 확인해야 합니다. |
“어느 하네스가 더 싼가?”보다 먼저 물어야 할 것
“누가, 어떤 라이선스로, 어떤 모델과 업무를 실행하는가?”입니다. 소비량을 측정하고, 라이선스 포함 범위를 확인한 뒤, 같은 수준의 업무를 완료하는 데 드는 전체 비용으로 선택하세요.
공식 참고 자료
- Microsoft Learn — Copilot Studio 하네스 개요
- Microsoft Learn — Standard 기능별 요율, 추론 모델 과금과 Agent flow 포함 조건
- Microsoft Learn — GitHub Copilot 하네스의 사용량 기반 과금
- Microsoft Learn — 비용 관리와 기능별 Microsoft 365 Copilot 라이선스 포함 범위
- Microsoft Copilot Studio 라이선스 가이드
실험 자료: 안성진, 「10월 월간코파일럿 게시물 작성」 원고. 실험 기간: 2026년 8~9월. 공식 문서 확인일: 2026년 9월 22일. 표의 실험값은 제공된 원고를 기준으로 정리했으며 이 글의 편집 과정에서 실험을 다시 실행하지는 않았습니다. 화면은 원고에서 발췌했고 계정·환경 정보 영역은 제외했습니다. 실제 요금과 사용 권한은 최신 라이선스 가이드, 계약 및 조직의 계측 내역을 확인하세요.